大家好!今天,我想和大家聊一聊一个非常强大且直观的方法,可以一目了然地掌握我们开发和运营的服务的健康状况——RED 指标。特别是,我们将详细探讨如何通过追踪数据 (Trace Data) 轻松生成和利用这些指标!
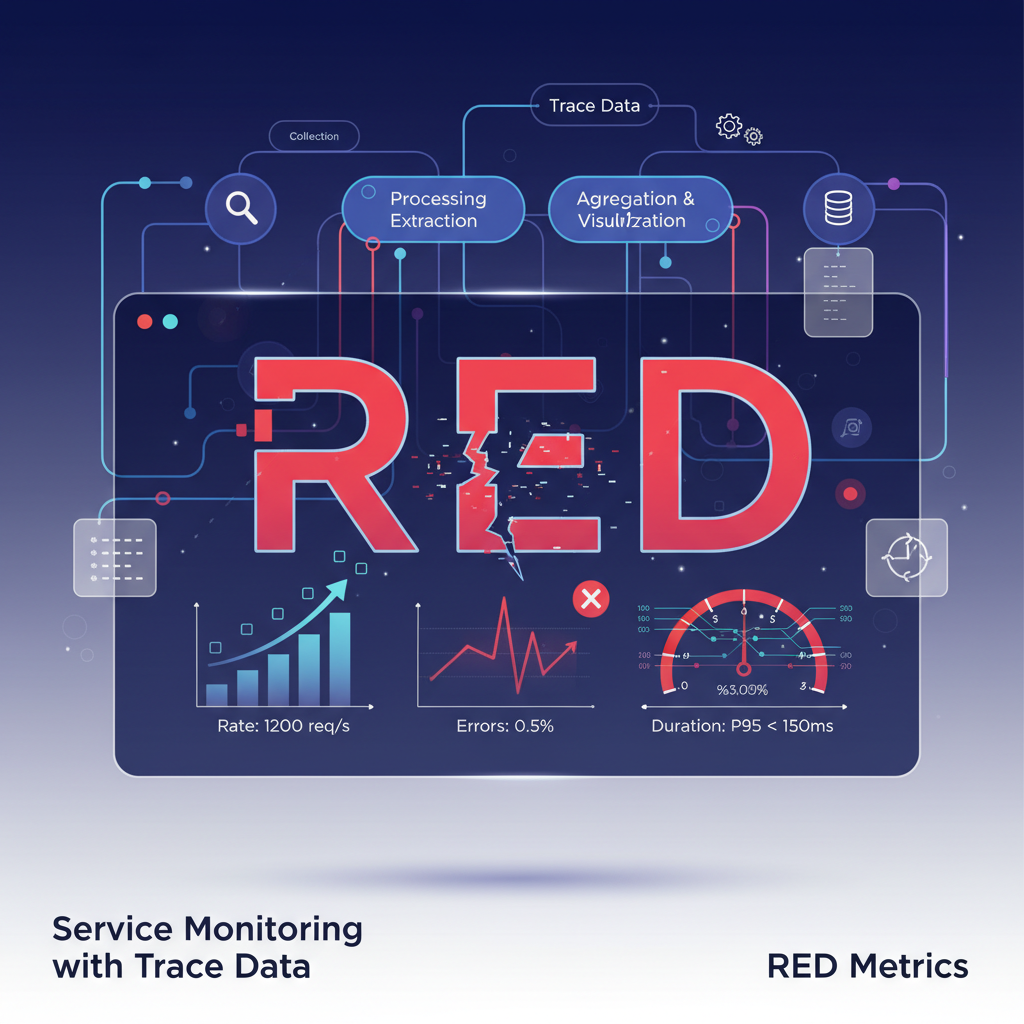
🤔 什么是 RED 指标?
RED 是用于了解服务状态的三个核心指标的缩写。它是 Google SRE (Site Reliability Engineering) 团队提出的“四大黄金信号 (Four Golden Signals)”的简化概念,专为微服务环境量身定制,易于记忆和理解。
- 📈 Rate (请求率): 服务在单位时间(通常是1秒)内处理的请求数量。
- “现在我们的服务有多少用户涌入?”
- 通过识别流量的突然增加或减少来检测异常。
- ❌ Errors (错误率): 在所有请求中,失败请求的比例或数量。
- “用户正在经历多少错误?”
- 错误率的增加是服务发生严重问题的最直接信号。
- ⏳ Duration (响应时间): 处理每个请求所需时间的分布。
- “我们的服务响应速度有多快?”
- 通常,检查第95和第99百分位数(percentile)比平均值(average)更重要,以了解大多数用户体验到的响应速度。响应时间过长会降低用户体验。
只要持续观察这三项指标,您就能自信地回答“服务是否正常?”这个问题!
🛤️ 为什么“追踪数据”是最佳材料?
传统上,我们通过分析日志或度量数据来收集上述指标。但是,使用追踪数据可以更轻松、更准确地获取 RED 指标。
追踪是记录用户请求从进入我们的系统到离开的整个旅程的数据。一个追踪由多个跨度 (Span) 组成,每个跨度代表一个特定的工作单元(例如:API 调用、数据库查询)。
由于这种旅程记录,我们可以非常轻松地获取以下信息:
- 单个请求 (Trace) 的开始和结束时间 ➡️ Duration 计算变得容易。
- 请求的最终成功/失败状态 (例如:HTTP 状态码) ➡️ 可以明确知道是否存在Error。
- 单位时间内收到的请求总数 ➡️ 可以准确计算Rate。
换句话说,追踪数据就像一个宝库,已经完美地包含了生成 RED 指标所需的所有信息。💎
🔧 在数据管道中生成 RED 指标:分步指南
那么,我们如何在实际的追踪数据流管道中生成 RED 指标呢?
1️⃣ 步骤:数据收集 (Collection)
应用程序使用 OpenTelemetry 等标准库生成追踪数据。这些数据通常被发送到数据管道的第一个关卡——“Collector”。
[应用程序] ➡️ [Collector]
2️⃣ 步骤:数据处理与提取 (Processing & Extraction)
Collector 或其后端的数据处理系统会实时分析接收到的追踪数据,提取 RED 指标所需的信息。
- Rate: 计算在特定时间间隔(例如:10秒)内收到的追踪数量。 count(traces)
- Errors: 检查每个追踪的状态标签(例如:status.code = ERROR, http.status_code >= 500),计算错误追踪的数量。 count(error_traces)
- Duration: 计算每个追踪的开始时间和结束时间之差,得到响应时间 (latency)。将这些值收集起来,以便计算直方图或百分位数。
3️⃣ 步骤:聚合与可视化 (Aggregation & Visualization)
提取的数据会根据服务名称、端点 (endpoint) 等标准进行聚合,然后发送到 Prometheus、Grafana、Datadog 等监控系统。
[Collector] ➡️ [监控系统 (例如:Prometheus)] ➡️ [仪表盘 (例如:Grafana)]
现在,我们可以通过精美的仪表盘实时查看我们服务的 Rate、Errors 和 Duration 了! 📊
✨ 使用 RED 指标的优势
- 直观性: 无需关注复杂的指标,只需关注三项即可快速识别问题。
- 标准化: 无论何种服务,都可以使用相同的标准评估其状态,这在管理多个微服务时特别有用。
- 快速响应: 可以立即检测到异常并迅速采取行动,例如“错误率急剧上升!”或“响应时间正在变慢!”。
现在,您也可以利用追踪数据构建 RED 指标,智能地管理您的服务健康状况。稳定服务运营的第一步始于准确而直观的监控! 🚀
发表回复