こんにちは!今日は、私たちが開発・運用しているサービスの健全性を一目で把握できる、非常に強力で直感的な方法、RED指標についてお話ししたいと思います。特に、これらの指標をトレースデータ(Trace Data)を通じていかに簡単に生成し、活用できるかについて詳しく見ていきましょう!
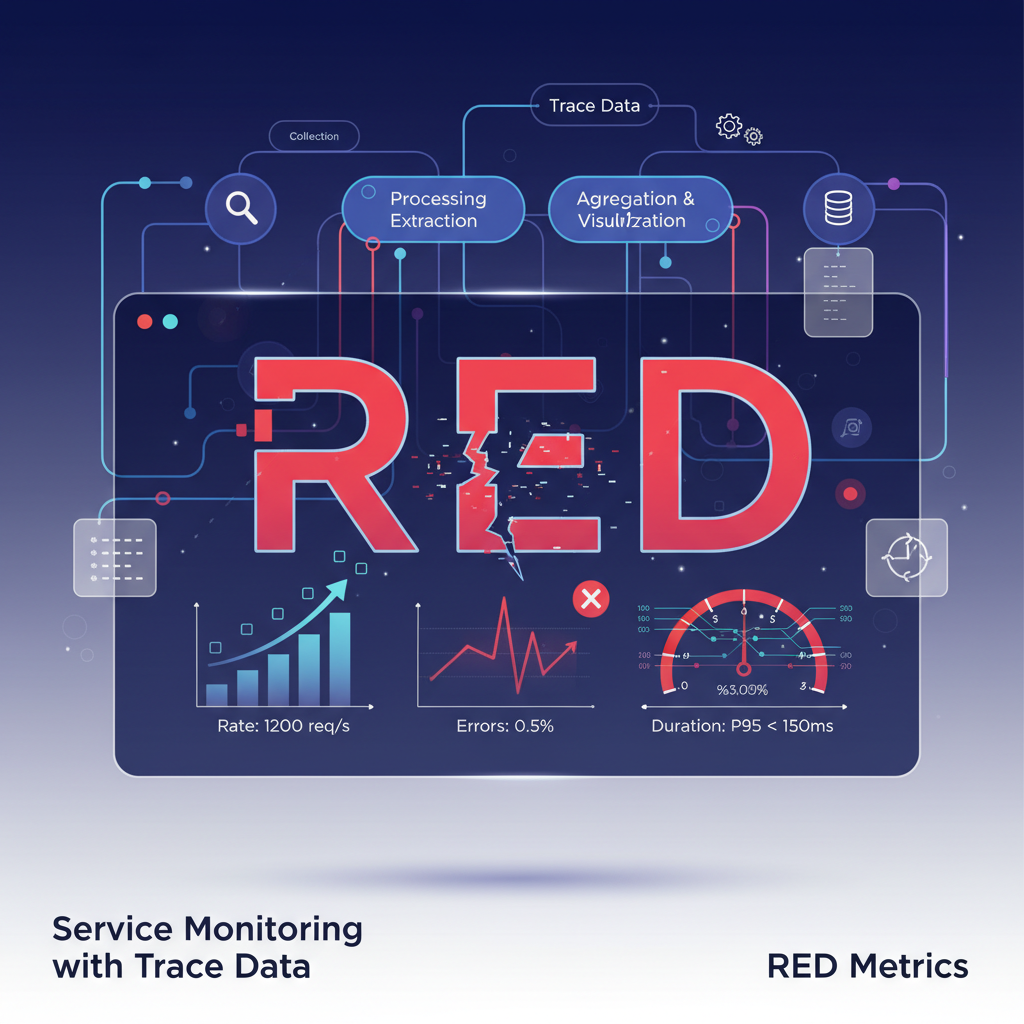
🤔 RED指標とは何ですか?
REDは、サービスの状況を把握するための3つの主要な指標の頭文字です。GoogleのSRE(Site Reliability Engineering)チームが提唱した「4つのゴールデンシグナル(Four Golden Signals)」をマイクロサービス環境に合わせて簡素化した概念で、覚えやすく、理解しやすいのが特徴です。
- 📈 Rate (リクエストレート): サービスが単位時間(通常1秒)あたりに処理しているリクエストの数です。
- 「今、私たちのサービスにどれくらいのユーザーが集中しているだろう?」
- 急激なトラフィックの増減を把握し、異常を検知できます。
- ❌ Errors (エラーレート): 全体のリクエストのうち、失敗したリクエストの割合または数です。
- 「ユーザーはどれくらいのエラーに遭遇しているだろう?」
- エラーレートの増加は、サービスに深刻な問題が発生したことを示す最も直接的なシグナルです。
- ⏳ Duration (応答時間): 各リクエストを処理するのにかかる時間の分布です。
- 「私たちのサービスはどれくらい速く応答しているだろう?」
- 通常、平均(average)よりも95パーセンタイル、99パーセンタイルを確認することで、ほとんどのユーザーが経験する応答速度を把握することが重要です。応答時間が長くなると、ユーザーエクスペリエンスが低下します。
この3つを継続的に観察するだけで、「サービスは正常か?」という質問に自信を持って答えられるようになります!
🛤️ なぜ「トレースデータ」が最高の材料なのでしょうか?
従来は、ログやメトリックデータを分析して上記の指標を収集していました。しかし、トレースデータを使用すると、はるかに簡単かつ正確にRED指標を取得できます。
トレースは、ユーザーのリクエストがシステムに入ってから出るまでの全行程を記録したデータです。1つのトレースは複数のスパン(Span)で構成され、各スパンは特定の作業単位(例:API呼び出し、DBクエリ)を表します。
この行程記録のおかげで、私たちは次のような情報を非常に簡単に得ることができます。
- 1つのリクエスト(Trace)が開始され、終了する時点 ➡️ Durationの計算が容易になります。
- リクエストの最終的な成功/失敗の有無 (HTTPステータスコードなど) ➡️ Errorの有無を明確に知ることができます。
- 単位時間あたりに入ってきたリクエストの総数 ➡️ Rateを正確に数えることができます。
つまり、トレースデータはRED指標を生成するために必要なすべての情報をすでに完璧に含んでいる宝の山のようなものです。💎
🔧 データパイプラインでRED指標を生成する:ステップバイステップガイド
それでは、実際にトレースデータが流れるパイプラインでどのようにRED指標を作成するのか見ていきましょう!
1️⃣ ステップ:データ収集 (Collection)
アプリケーションはOpenTelemetryのような標準ライブラリを使用してトレースデータを生成します。このデータは通常、データパイプラインの最初のゲートウェイである「Collector」に送信されます。
[アプリケーション] ➡️ [Collector]
2️⃣ ステップ:データ処理と抽出 (Processing & Extraction)
Collectorまたはその下流のデータ処理システムでは、受信したトレースデータをリアルタイムで分析し、RED指標に必要な情報を抽出します。
- Rate: 特定の時間間隔(例:10秒)に入ってきたトレースの数を数えます。 count(traces)
- Errors: 各トレースのステータスタグ(例:status.code = ERROR, http.status_code >= 500)を確認し、エラーであるトレースの数を数えます。 count(error_traces)
- Duration: 各トレースの開始時間と終了時間の差を計算して応答時間(latency)を求めます。これらの値を集めてヒストグラムやパーセンタイルとして計算できるように準備します。
3️⃣ ステップ:集計と可視化 (Aggregation & Visualization)
抽出されたデータは、サービス名、エンドポイント(endpoint)などの基準で集計され、Prometheus、Grafana、Datadogなどのモニタリングシステムに送信されます。
[Collector] ➡️ [モニタリングシステム (例:Prometheus)] ➡️ [ダッシュボード (例:Grafana)]
これで、素晴らしいダッシュボードを通じて、私たちのサービスのRate、Errors、Durationをリアルタイムで確認できるようになります! 📊
✨ RED指標活用のメリット
- 直感性: 複雑な指標の代わりに3つだけに集中できるため、問題状況を素早く認識できます。
- 標準化: どのようなサービスでも同じ基準で状態を評価できるため、複数のマイクロサービスを管理する際に特に有用です。
- 迅速な対応: 「エラーレートが急増した!」や「応答時間が遅くなっている!」のように、即座に異常を検知し、迅速に対処できます。
さあ、皆さんもトレースデータを活用してRED指標を構築し、サービスの健全性をスマートに管理してみてください。安定したサービス運用の第一歩は、正確で直感的なモニタリングから始まります! 🚀
コメントを残す