当LLM生成句子时,它似乎在记住已读内容的同时自然地选择下一个词。然而,Decoder-only Transformer内部并没有像人类记忆句子那样的记忆装置。
相反,每个Token都被转换为向量,称为Query, Key, Value,简称Q·K·V。当前位置的Q会计算与之前Token的K的相关度,并通过更多地获取相关度高的Token的V来构建上下文。
此外,还结合了用于提高推理速度的KV Cache。这是一种存储已处理Token的K和V,并在生成下一个Token时重用的方法。
本文将从Q·K·V的生成过程、Self-Attention计算、Prefill和Causal Mask、逐Token解码,以及KV Cache对性能的影响等方面,以一个连贯的流程进行探讨。
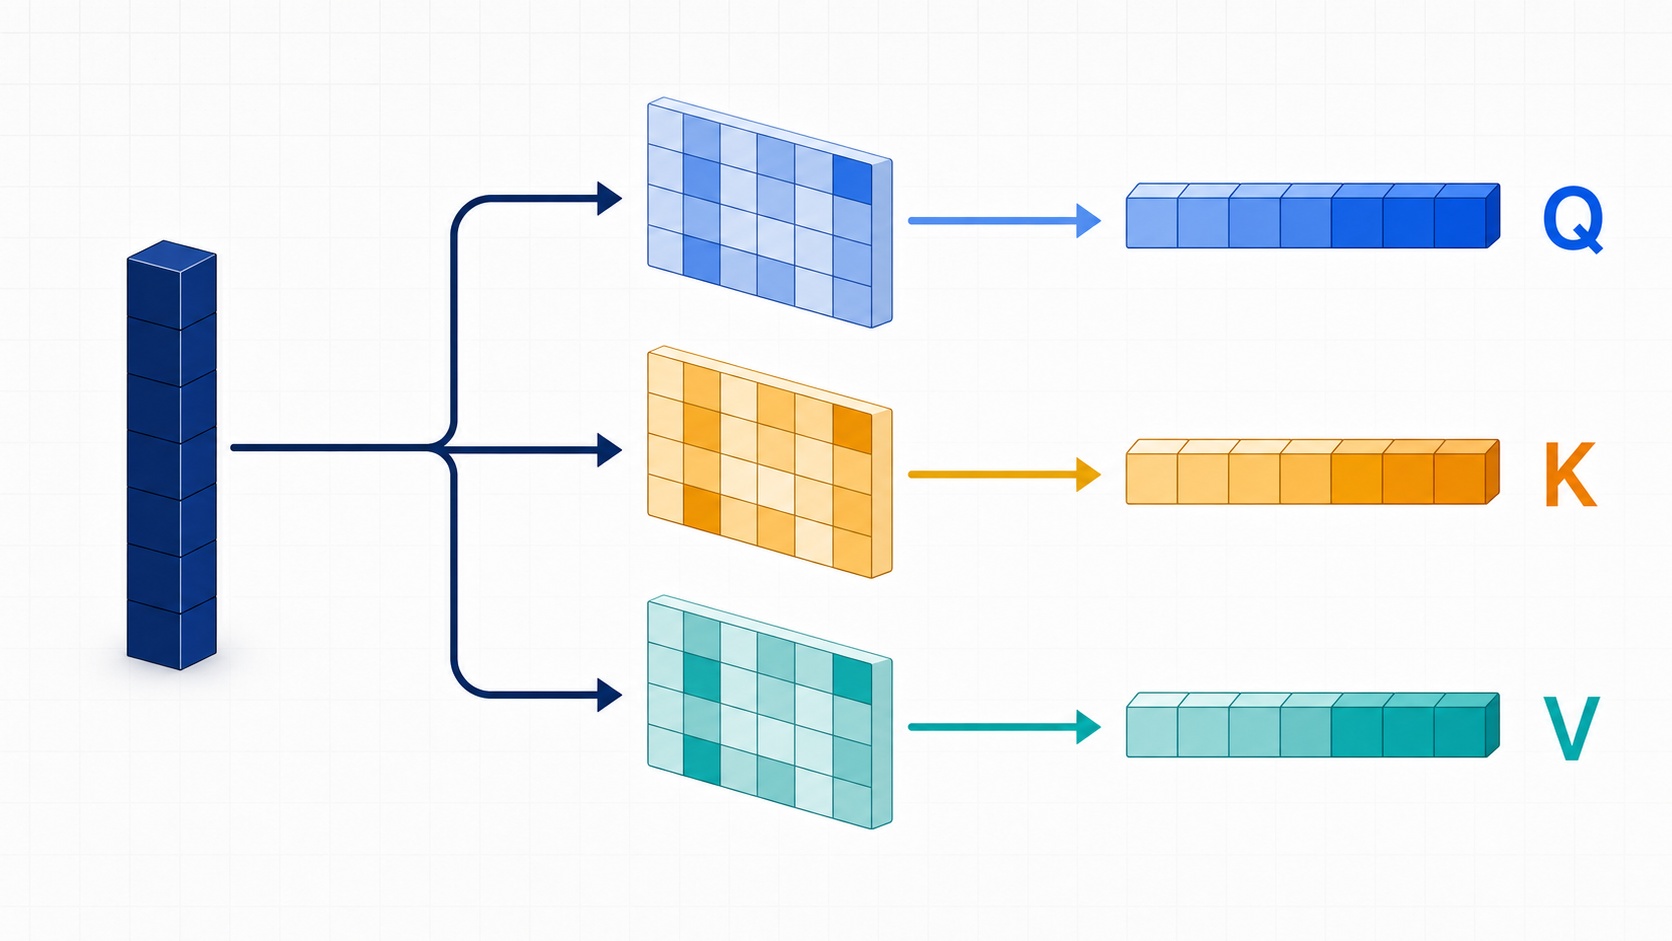
图:从一个Token表示中生成Q·K·V的三分支投影过程
Q·K·V从何而来
Decoder-only Transformer是一种堆叠了多个Transformer Layer的结构。每个层都包含Self-Attention和Feed Forward Network。
Q·K·V出现在Self-Attention中。重要的一点是,Q·K·V并非只对整个输入句子创建一次,而是每个层都会重新投影其当前输入以创建新的Q·K·V。
如果进入一个层的Token表示为X,则可以表示如下:
Q = XWQ
K = XWK
V = XWV
WQ、WK、WV是通过训练确定的不同权重矩阵。即使使用相同的Token表示X,根据比较的角度和要传递的内容,也会生成不同的向量。
토큰의 현재 표현 X
 ├─ WQ와 곱함 → Q
 ├─ WK와 곱함 → K
 └─ WV와 곱함 → V
将这三个向量比作搜索系统会更容易理解。
| 向量 | 在Attention中的作用 | 搜索系统类比 |
| — | — | — |
| Q, Query | 当前位置想要查找的信息 | 搜索词 |
| K, Key | 表示每个位置与何种信息相关的标记 | 文档索引·关键词 |
| V, Value | 被选中时实际传递的信息 | 文档正文 |
但是,这个类比不应过于字面化。K并不存储人类可读的关键词,V也不直接存储句子。它们都是经过训练的高维向量,是模型执行任务的良好内部表示。
Q比较K并获取V
Self-Attention的核心可以用一句话概括:
用当前位置的Q与所有允许位置的K进行比较,然后根据得分对V进行加权求和。
Q和K是用于计算相关度的配对,而V是相关度计算后实际混合的信息。区分这些作用可以自然地理解为什么K和V会被缓存,而Q通常不会被缓存。
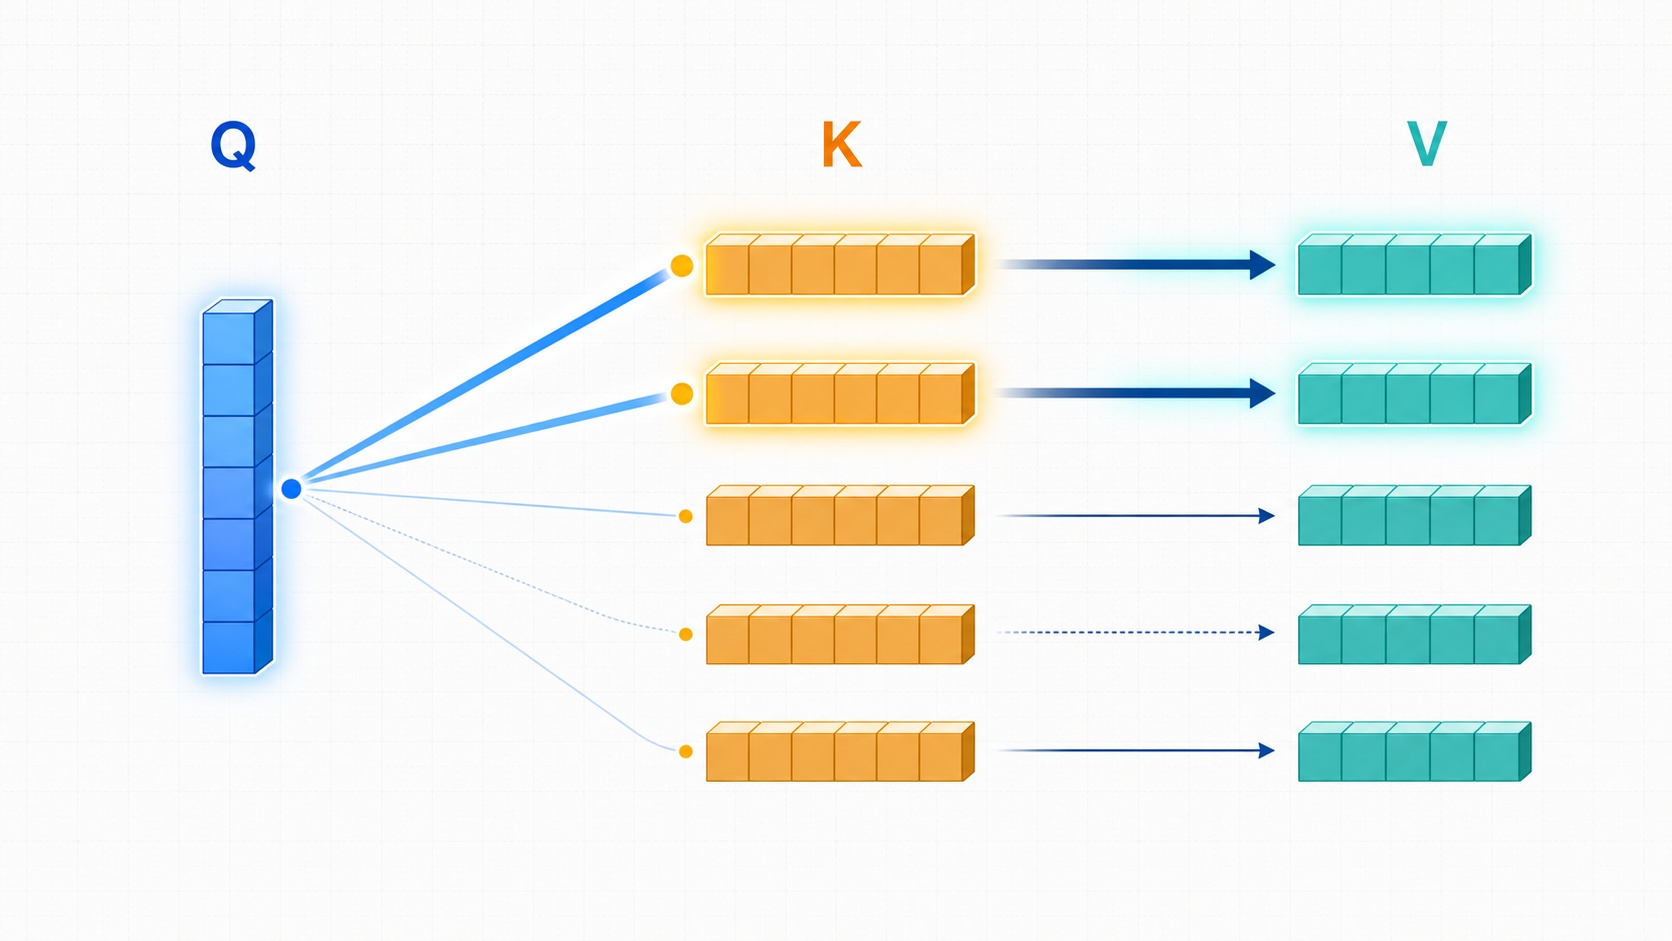
图:Q和K的比较强度变化如何决定V的反映权重
例如,假设我们正在处理以下句子:
대한민국의 수도는 서울이다如果在Prefill或训练过程中计算“서울”(首尔)位置的表示,那么Q_서울可以与前面Token的K进行比较。
Q서울 · K대한민국 → 국가 문맥과의 관련도
Q서울 · K수도     → 수도 개념과의 관련도
Q서울 · K는       → 문법적 관계와의 관련도
Q서울 · K서울     → 현재 위치 자체와의 관련도
假设相关度分数已按如下方式归一化:
대한민국의 K → 0.30
수도의 K     → 0.50
는의 K       → 0.10
서울의 K     → 0.10
那么,“서울”(首尔)位置的Attention输出可以看作是以下加权和:
Attention 출력
= V대한민국 × 0.30
 + V수도    × 0.50
 + V는      × 0.10
 + V서울    × 0.10
这个结果会传递给后续的计算,例如残差连接(Residual Connection)、归一化(Normalization)和前馈网络(Feed Forward Network)。经过多个层后,Token表示会逐渐更多地反映周围的上下文。
这里需要区分一点。如果模型尚未生成“서울”(首尔),那么未来Token“서울”的Q是不存在的。那时,模型会使用提示词中最后一个Token位置的表示来预测下一个Token“서울”的概率。Q_서울的解释适用于“서울”Token已包含在输入中,或者在生成后计算其位置的上下文表示的情况。
Scaled Dot-Product Attention是如何计算的
Attention的代表性公式如下:
Attention(Q, K, V)
= softmax(QKᵀ / √dₖ + M) V
其中,dₖ是一个Attention Head中Key向量的维度,M是Attention Mask。Decoder-only模型的Causal Mask会在未来位置的分数上加上一个非常大的负数,概念上是-∞,使得Softmax结果变为0。
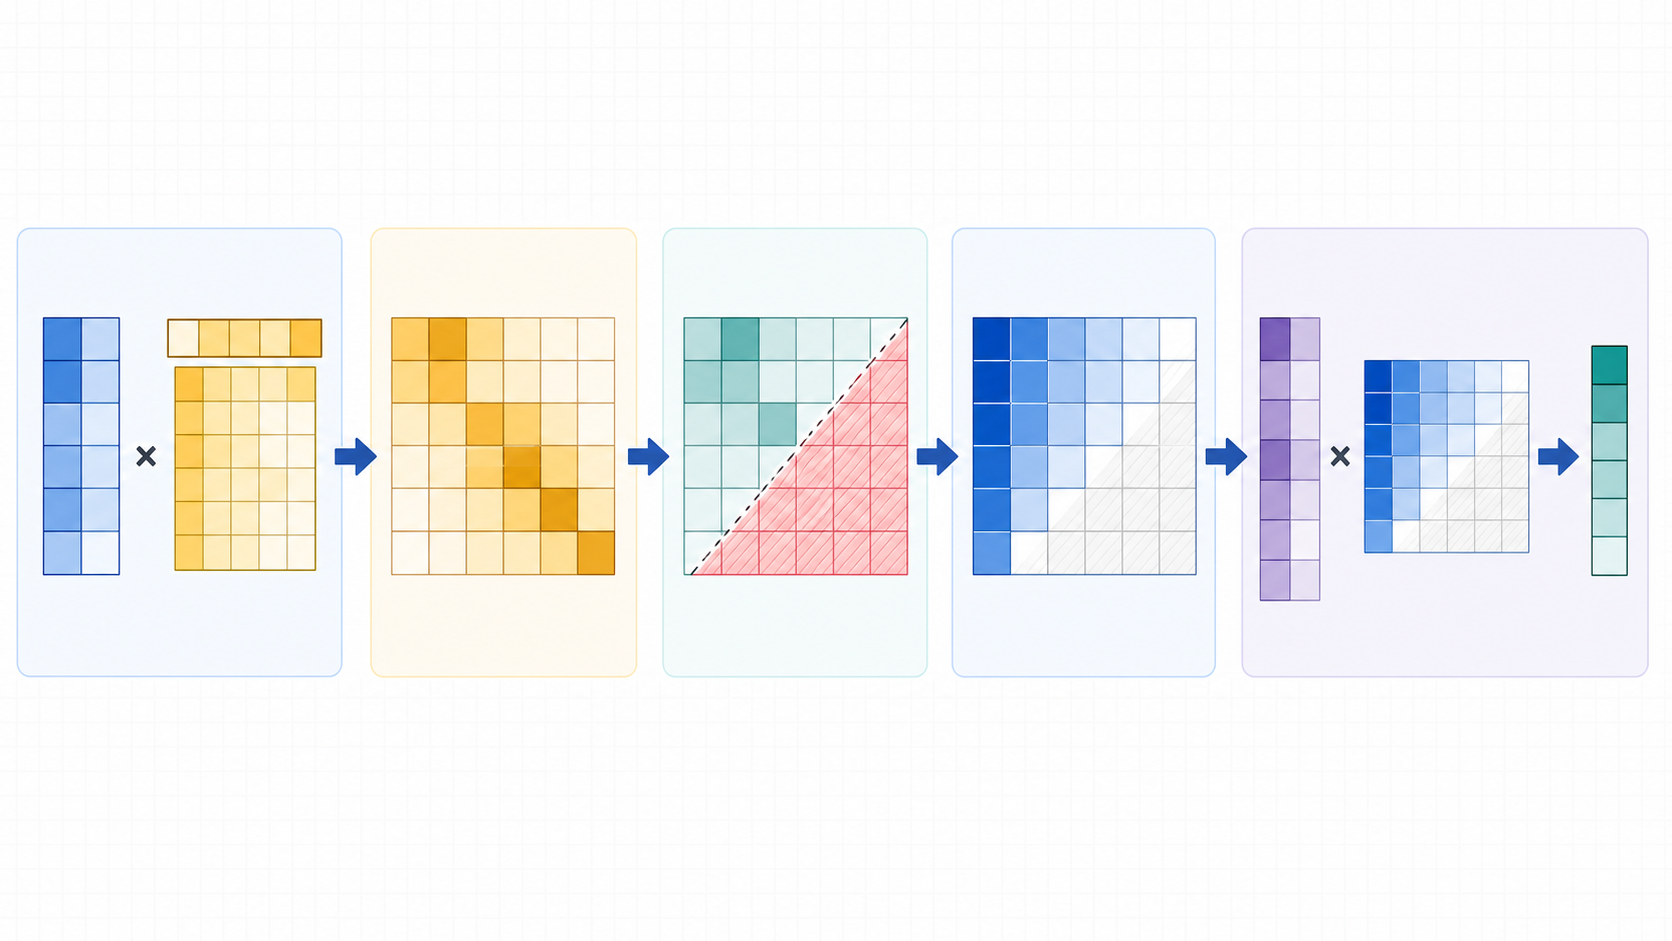
图:Attention管道,从分数矩阵生成、缩放、因果掩码、Softmax到V加权求和
计算可以分为以下几个步骤:
1. 通过Q和K的点积创建相关度分数
scores = QKᵀQ的一行与K的一行的点积成为两个向量之间的相关度分数。当多个Token同时计算时,会生成一个包含Token之间分数的矩阵。
2. 除以√dₖ
当向量维度增大时,点积值的大小也可能增大。如果分数过大,Softmax可能会向一侧饱和,导致训练不稳定。因此,通过除以√dₖ来调整大小。
scaled_scores = scores / √dₖ3. 应用Mask
Decoder-only模型需要预测下一个Token,因此不应参考当前位置之后的未来Token。
allowed position → 점수 유지
future position  → -∞를 더함
4. 使用Softmax创建权重
weights = softmax(masked_scores)每行的分数都会转换为总和为1的权重。未来位置的权重变为0,而相关度高的过去和当前位置的权重会增大。
5. 对V进行加权求和
context = weights × V最终结果是一个新的上下文向量,它更多地反映了相关度高的Value。
Multi-Head Attention有何不同
实际的Transformer并非只从一个角度比较Q·K·V。多个Attention Head在不同的子空间中学习关系。
有些Head可能更侧重于语法依赖性,而另一些Head可能更好地捕捉远距离主语和谓语之间的关系或特定实体的重复。
Head 1 → Q1, K1, V1 → Attention 결과 1
Head 2 → Q2, K2, V2 → Attention 결과 2
Head 3 → Q3, K3, V3 → Attention 결과 3
...
将每个Head的结果拼接起来,并通过输出投影矩阵WO,就得到了该层的Multi-Head Attention输出。
MultiHead(Q, K, V)
= Concat(head1, head2, ..., headh) WO
在现代LLM中,不仅使用每个Query Head都拥有独立K·V Head的MHA(Multi-Head Attention),还广泛使用多个Query Head共享K·V的GQA(Grouped Query Attention)或MQA(Multi-Query Attention)。这种结构在减小KV Cache大小和内存带宽方面起着关键作用。
Prefill阶段:一次性处理整个提示词
假设输入如下:
생성형 AI는 문장을Token化结果可以简单表示为:
생성형 / AI / 는 / 문장 / 을在Prefill阶段,GPU并行处理提示词中的所有Token。每个层为所有位置创建Q·K·V,并计算应用了Causal Mask的Self-Attention。
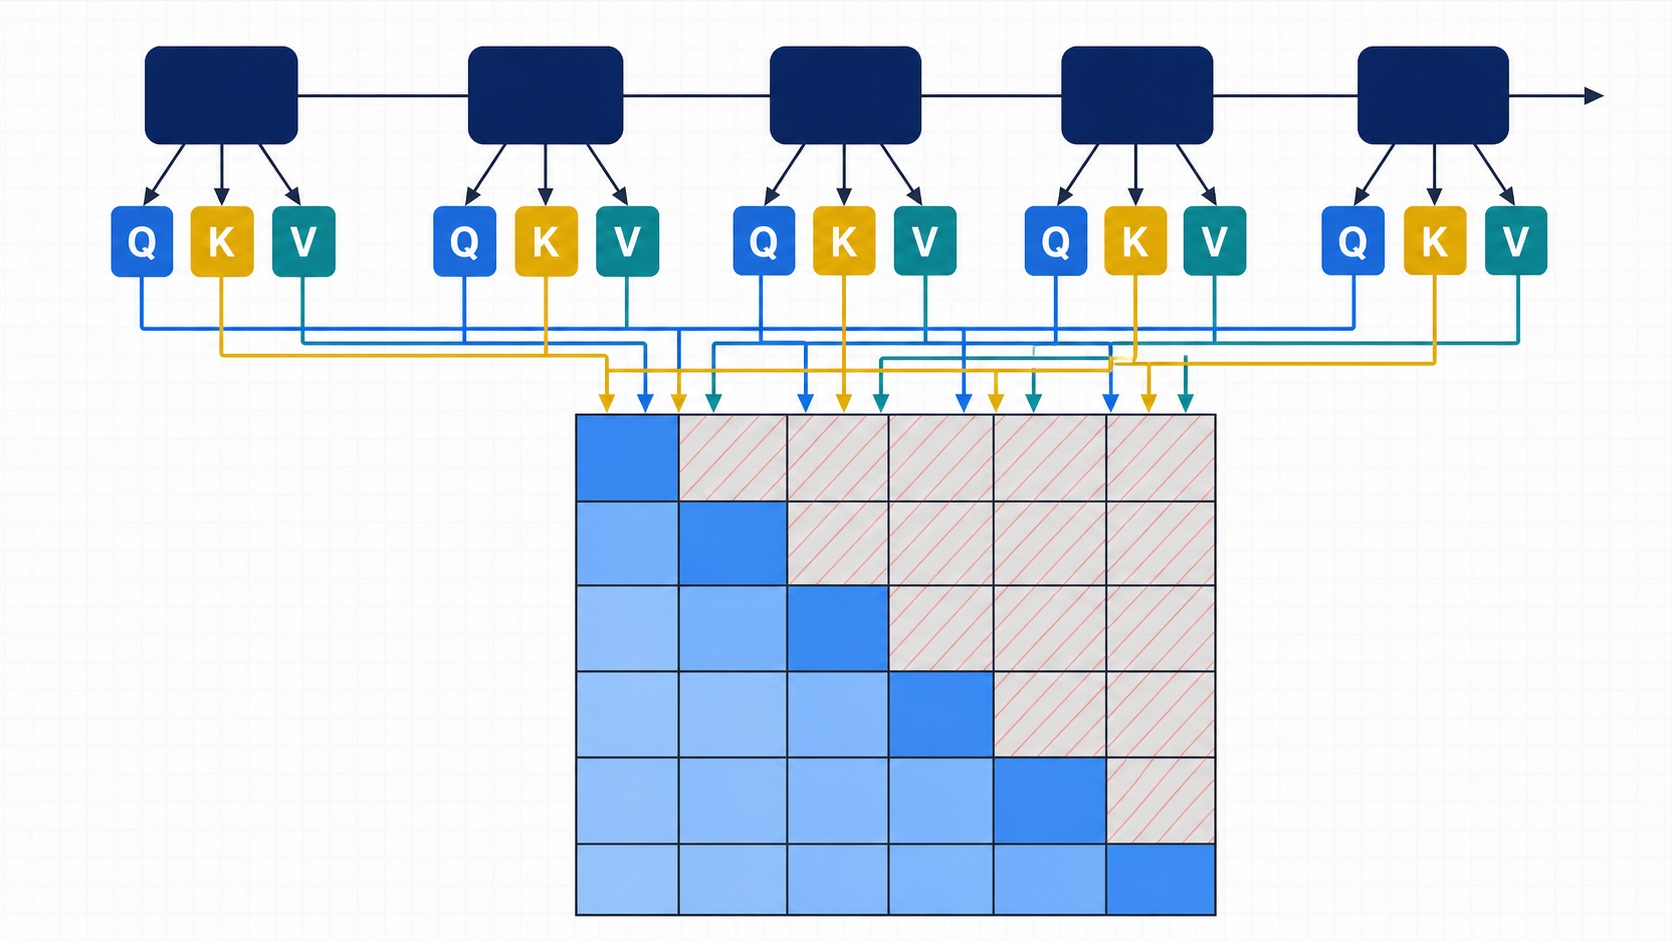
图:Prefill,并行计算所有提示词位置的Q·K·V,但未来位置被三角形Mask阻挡
생성형 → Q1, K1, V1
AI     → Q2, K2, V2
는     → Q3, K3, V3
문장   → Q4, K4, V4
을     → Q5, K5, V5
每个位置可以参考的范围如下:
Q1 → K1
Q2 → K1, K2
Q3 → K1, K2, K3
Q4 → K1, K2, K3, K4
Q5 → K1, K2, K3, K4, K5
从矩阵来看,只允许下三角部分。
        K1  K2  K3  K4  K5
Q1      O   X   X   X   X
Q2      O   O   X   X   X
Q3      O   O   O   X   X
Q4      O   O   O   O   X
Q5      O   O   O   O   O
Prefill完成后,每个层中提示词Token的K和V会存储在KV Cache中。在计算下一个Token的概率时,通常使用最后一个输入位置的最终隐藏状态(Hidden State)产生的Logits。
생성형 AI는 문장을
→ 다음 토큰 후보의 확률
→ "처리" 선택Prefill是一个可以并行计算大量Token的阶段,因此它积极利用了GPU的计算能力。它与TTFT(Time To First Token)密切相关,这也是读取长提示词时第一个Token出现较慢的原因。
Decode阶段:逐个生成新Token
假设“처리”(处理)被选为第一个输出Token。在下一个Decode步骤中,不再将整个提示词重新输入模型,而是只输入新Token“처리”。
每个层都会计算新Token的Q·K·V。
"처리"
→ q6, k6, v6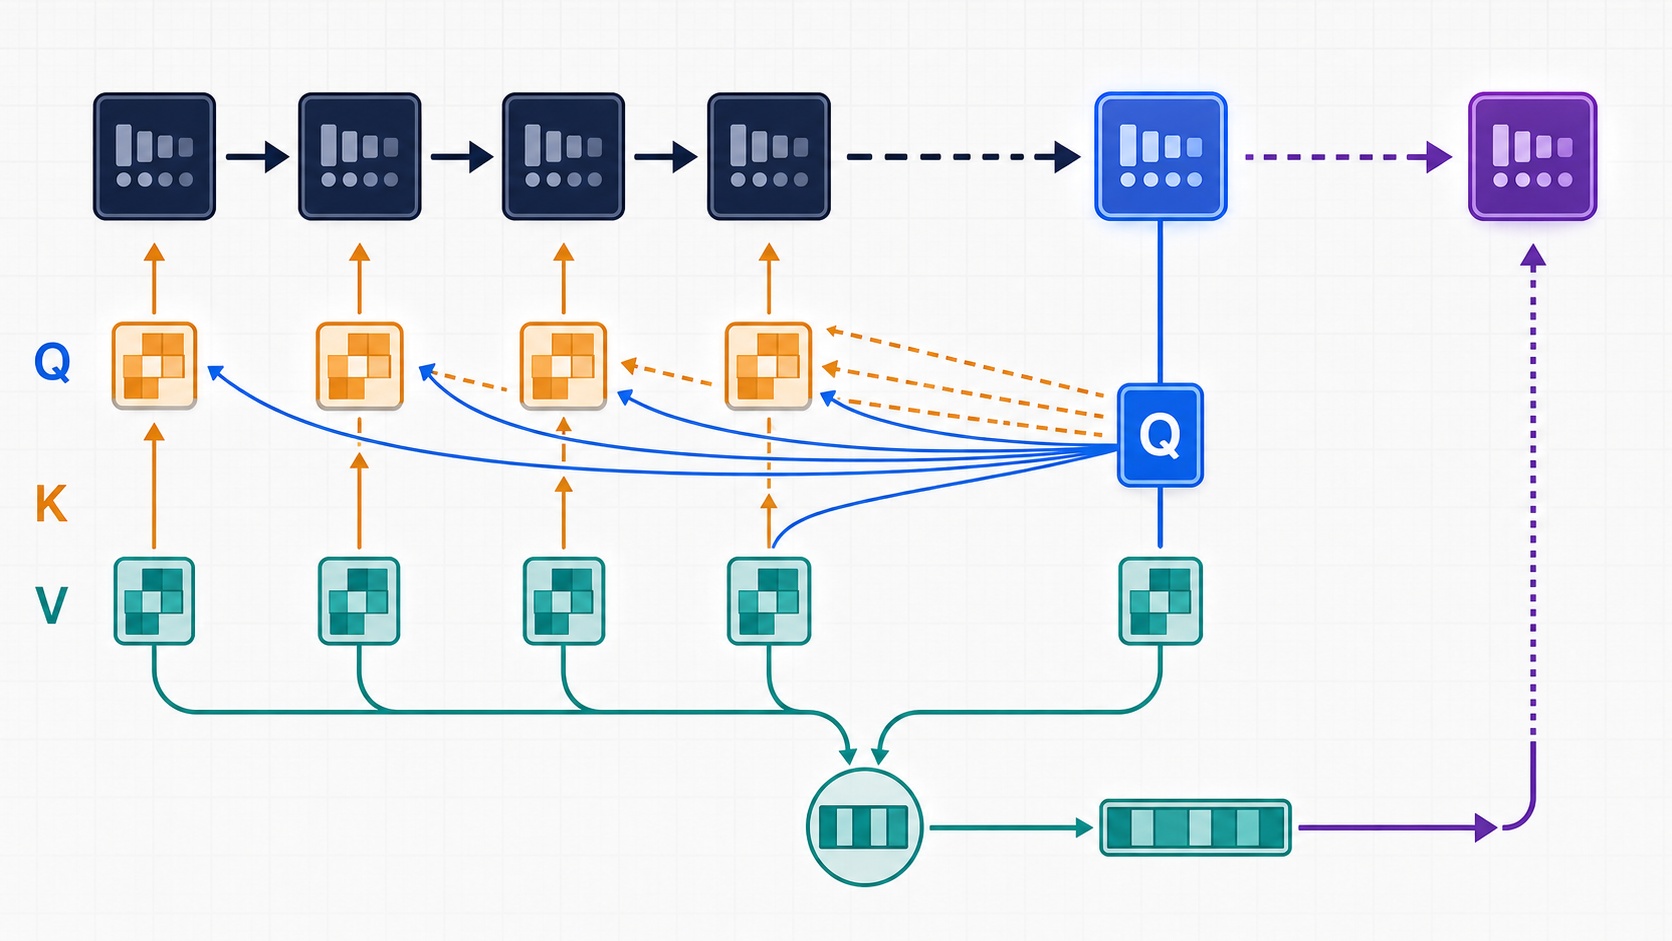
图:串行解码过程,其中当前单个Token的Q查询过去的K,并加权求和V以生成下一个Token
在当前层中,q6会同时与缓存中存储的过去K和新的k6进行比较。
q6
→ [k1, k2, k3, k4, k5, k6]과 비교
然后用这些分数对过去和当前的V进行加权求和。
[v1, v2, v3, v4, v5, v6]
→ Attention 가중합
→ "처리" 위치의 문맥 벡터
此计算通过所有Transformer层后,最终的隐藏状态(Hidden State)将转换为词汇表大小的Logits。
문맥 벡터
→ LM Head
→ 다음 토큰별 Logit
→ Softmax 또는 Sampling
→ "한다" 선택现在,以“한다”(做)作为输入,重复相同的过程。这种将之前生成的Token再次用作输入,逐个生成下一个Token的方式称为自回归解码(Autoregressive Decoding)。
与Prefill不同,Decode的下一步需要等待上一步的结果。Token无法完全并行生成,并且每一步都需要读取KV Cache,因此它受到内存带宽和每个Token延迟的显著影响。
KV Cache存储什么
KV Cache是按层存储已处理Token的Key和Value的内存。
Layer 1 KV Cache
K1, K2, K3, K4, K5
V1, V2, V3, V4, V5

Layer 2 KV Cache
K1, K2, K3, K4, K5
V1, V2, V3, V4, V5

...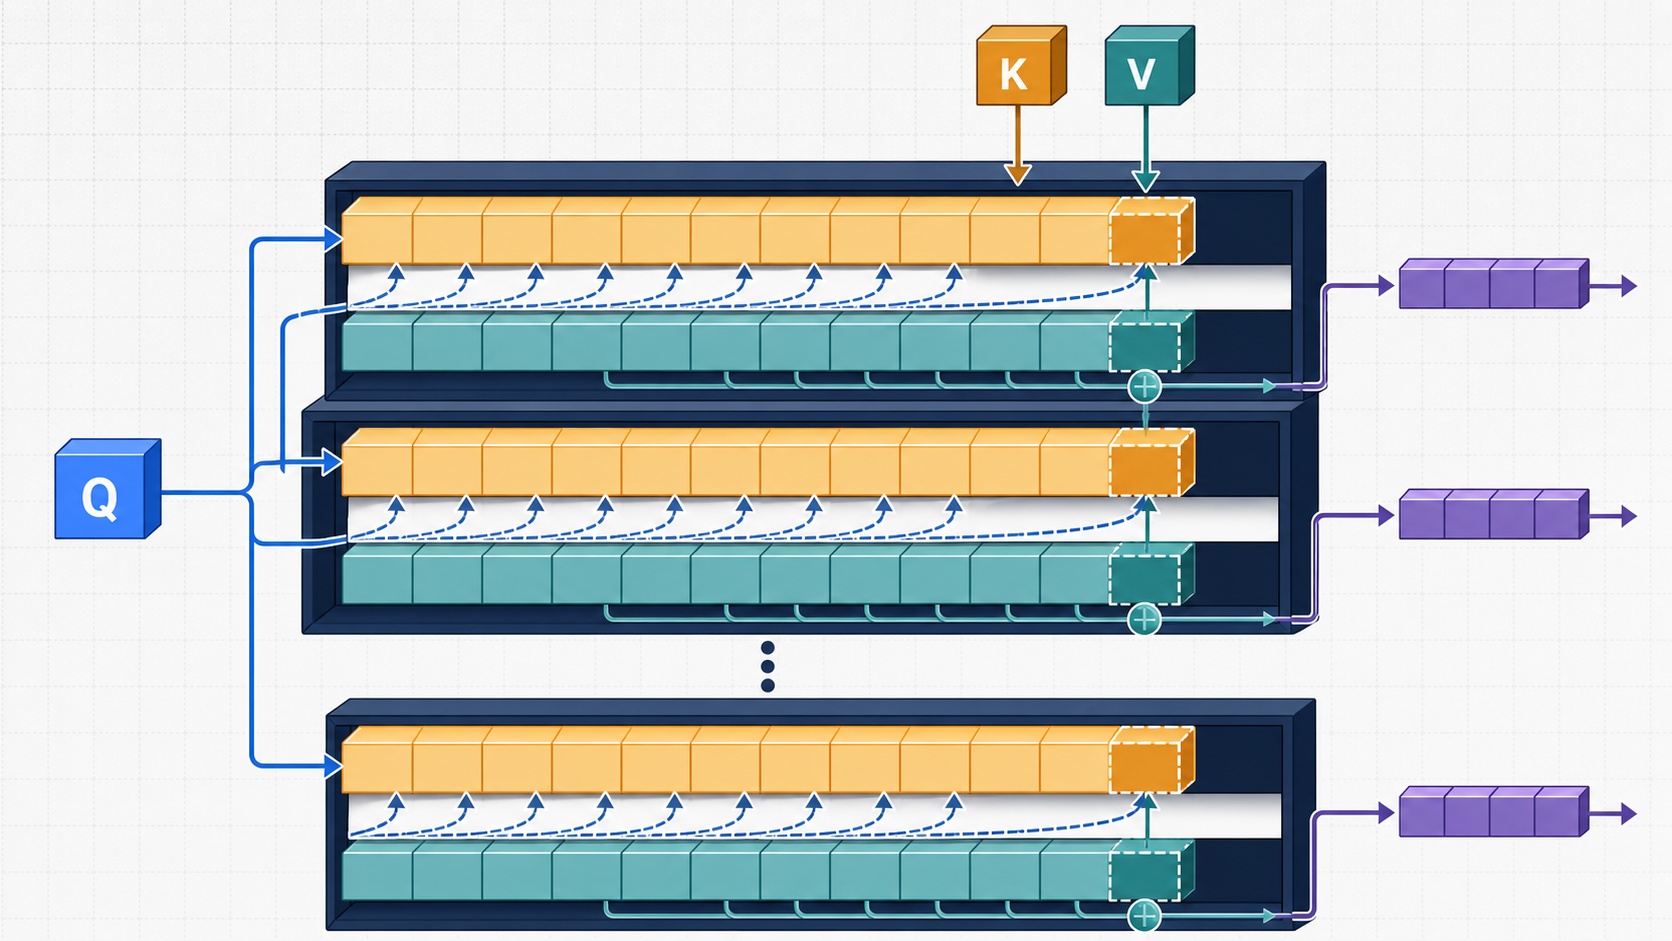
图:KV Cache,它重新读取每层存储的过去K·V,并仅将当前Token的新K·V添加到末尾
当新Token到来时,每个层只将该Token的K和V添加到缓存中。
Kcache ← concat(Kpast, k현재)
Vcache ← concat(Vpast, v현재)
当前Token的Q会立即用于Attention计算,但在下一个Token步骤中无需再次使用。
| 向量 | 当前解码步骤 | 后续步骤中的处理 |
| — | — | — |
| 当前Q | 与缓存的K计算相关度 | 通常不存储 |
| 当前K | 与当前Q比较 | 添加到KV Cache |
| 当前V | 参与当前输出的加权求和 | 添加到KV Cache |
| 过去K·V | 被当前Q查询 | 从缓存中重复重用 |
| 过去Q | 不使用 | 无需重新计算或存储 |
整个流程如下:
현재 토큰
  ↓
q현재, k현재, v현재 계산
  ↓
q현재 × [K과거 + k현재]ᵀ
  ↓
Attention 가중치
  ↓
[V과거 + v현재] 가중합
  ↓
현재 위치의 문맥 벡터
  ↓
다음 토큰 확률 계산
如果没有KV Cache,哪些计算会重复
如果没有KV Cache,每生成一个Token,就必须重新处理到目前为止的整个序列。
첫 번째 생성
프롬프트 전체 계산

두 번째 생성
프롬프트 + 첫 출력 전체 계산

세 번째 생성
프롬프트 + 첫 출력 + 두 번째 출력 전체 계산
使用KV Cache可以重用已处理位置的K和V投影结果。
첫 번째 생성
프롬프트의 K·V 저장

두 번째 생성
새 토큰의 q·k·v만 계산
+ 과거 K·V 재사용

세 번째 생성
다시 새 토큰의 q·k·v만 계산
+ 더 길어진 과거 K·V 재사용
然而,KV Cache并不能使Attention计算的成本完全恒定。随着序列的增长,新的Query仍然需要与更多的过去Key进行比较并读取更多的Value。
없어지는 비용
→ 과거 토큰의 K·V를 다시 투영하는 계산

남아 있는 비용
→ 현재 Q와 전체 캐시 K의 비교
→ 전체 캐시 V의 가중합
→ 길어진 Cache를 읽는 메모리 비용
换句话说,KV Cache虽然大大减少了重复计算,但它并不能完全消除随着上下文变长而增加的Attention查询量和内存使用量问题。
KV Cache的内存为何会增大
基本的KV Cache大小与以下因素成正比:
KV Cache 크기
≈ 2
× Transformer Layer 수
× KV Head 수
× Head 차원
× 저장 토큰 수
× 배치 크기
× 원소당 바이트
前面的“2”是因为同时存储了K和V。如果上下文变长或同时处理的请求增多,Cache会迅速增大。
因此,在实际的LLM服务中会采用以下优化措施:
- 通过GQA·MQA减少KV Head数量
- 将KV Cache量化到更低的精度
- 将部分层Cache卸载到CPU
- 通过Sliding Window Attention限制旧Token的范围
- 通过Paged Attention以页为单位管理Cache内存
- 在多个请求中重用公共Prefix的KV Cache
每种方法都在速度、内存、准确性和实现复杂性之间存在权衡。
理解KV Cache时常见的误解
KV Cache并非模型的长期记忆
KV Cache是当前请求中已处理Token的Attention中间结果。当对话结束且Cache被废弃时,模型参数中并不会留下新的知识。
Cache中不只存储Token原文
它不是简单地存储Token ID或字符串,而是存储每个Transformer层计算出的K·V张量。因此,模型大小、层结构和KV Head数量直接影响内存使用量。
如果过去的句子发生变化,Cache不能直接使用
KV依赖于之前的Token、位置信息以及前一层计算。如果前部分的Token发生变化,其后的Cache将不再代表相同的上下文,因此必须重新计算更改点之后的部分。
KV Cache主要用于推理
在训练中,需要计算整个序列的梯度,因此不会以相同的方式使用一般的生成式KV Cache。Hugging Face文档也指出Cache应在推理中使用。
一幕总结
将Q·K·V和KV Cache按时间顺序连接起来如下:
1. 프롬프트 토큰화
2. Prefill에서 모든 프롬프트 위치의 Q·K·V 계산
3. Causal Mask를 적용해 미래 토큰 참조 차단
4. 각 레이어의 프롬프트 K·V를 Cache에 저장
5. 마지막 위치의 Logits로 첫 출력 토큰 선택
6. 새 토큰의 q·k·v만 계산
7. q로 캐시된 K를 조회하고 V를 가중합
8. 새 k·v를 Cache 끝에 추가
9. 다음 토큰을 선택하고 6번부터 반복
核心内容概括如下:
Q是当前位置要参考什么的向量,K表示每个位置与何种信息相关,V是当被选中时实际传递的信息。
而从推理性能角度来看的核心是:
过去Token的K和V存储在按层划分的KV Cache中以供重用,并且每当生成新Token时,只添加当前Token的K和V。然而,新的Q仍然需要查询整个Cache中的K和V,因此长上下文的计算量和内存成本并未完全消除。
Q·K·V可以理解为LLM选择上下文的原理,而KV Cache则是使这种选择能够以实际速度逐Token重复进行的推理优化。
发表回复