LLMが文章を生成する様子を見ると、すでに読んだ内容を記憶しながら自然に次の単語を選ぶように見えます。しかし、Decoder-only Transformerの中には、人間が文章を記憶するような記憶装置は入っていません。
代わりに、各トークンはQuery, Key, Value、略してQ・K・Vというベクトルに変換されます。現在の位置のQが以前のトークンたちのKとの関連度を計算し、関連度が高いトークンのVをより多く取り込むことで文脈を構成します。
これに推論速度を向上させるためのKVキャッシュが組み合わされます。すでに処理したトークンのKとVを保存しておき、次のトークンを生成する際に再利用する方式です。
この記事では、Q・K・Vが作られる過程からSelf-Attention計算、PrefillとCausal Mask、トークン別デコーディング、KVキャッシュが性能に与える影響までを一つの流れで見ていきます。
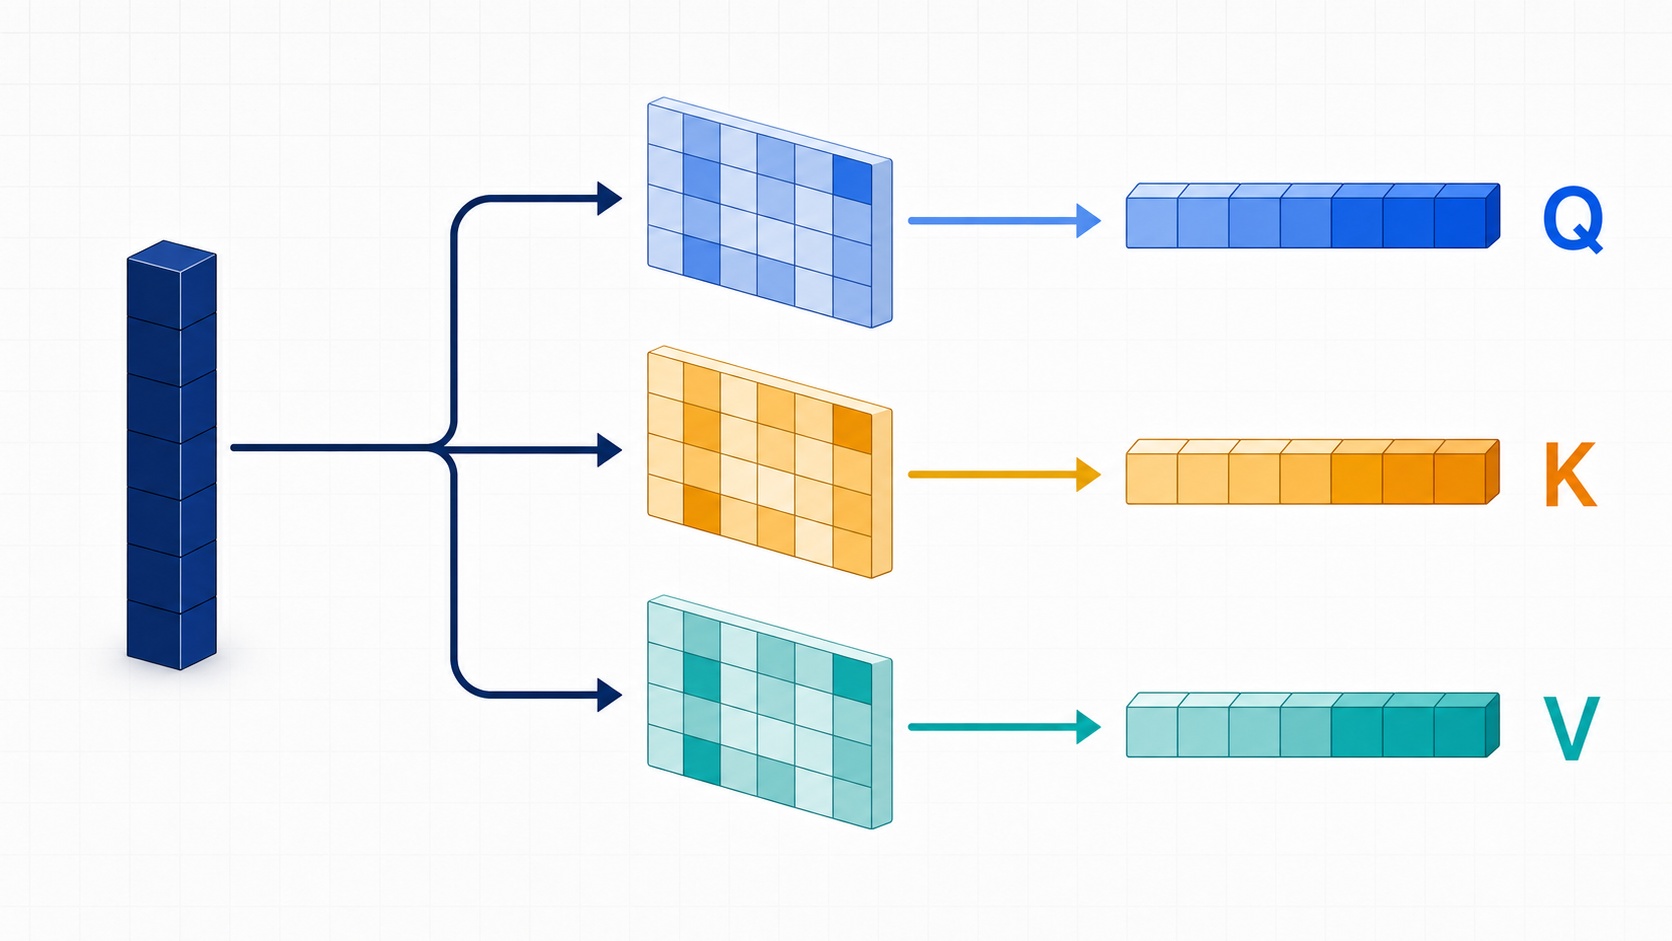
図:一つのトークン表現からQ・K・Vが作られる三方向への射影過程
Q・K・Vはどこで登場するのか
Decoder-only Transformerは、複数のTransformer Layerを積み重ねた構造です。各レイヤーにはSelf-AttentionとFeed Forward Networkが含まれています。
Q・K・Vは、このうちSelf-Attentionで登場します。重要な点は、入力文章全体に対してQ・K・Vを一度だけ作るのではなく、各レイヤーでレイヤーの現在の入力を再度射影して新しいQ・K・Vを作るということです。
あるレイヤーに入力されたトークン表現をXとすると、次のように表現できます。
Q = XWQ
K = XWK
V = XWV
WQ, WK, WVは、学習を通じて決定される異なる重み行列です。同じトークン表現Xを使用しても、どのような観点で比較し、どのような内容を伝達するかによって、異なるベクトルが生成されます。
토큰의 현재 표현 X
 ├─ WQ와 곱함 → Q
 ├─ WK와 곱함 → K
 └─ WV와 곱함 → V
これら3つのベクトルを検索システムに例えると理解しやすいです。
| ベクトル | Attentionでの役割 | 検索システム比喩 |
| — | — | — |
| Q, Query | 現在の位置が探したい情報 | 検索語 |
| K, Key | 各位置がどのような情報と関連するかを示す標識 | 文書の索引・キーワード |
| V, Value | 選択されたときに実際に伝達する情報 | 文書の本文 |
ただし、この比喩を文字通りに受け取りすぎてはいけません。Kが人間が読めるキーワードを保存し、Vが文章をそのまま保管するわけではありません。すべて学習された高次元ベクトルであり、モデルがタスクを実行するのに適した内部表現です。
QはKを比較し、Vを取り込む
Self-Attentionの核心は、一文でまとめることができます。
現在の位置のQで、すべての許容された位置のKを比較し、そのスコアに応じてVを重み付け合計する。
QとKは関連度を計算するためのペアであり、Vは関連度が計算された後に実際に混ぜ合わされる情報です。この役割を区別すると、なぜKとVがキャッシュされ、Qは通常キャッシュされないのかも自然に理解できます。
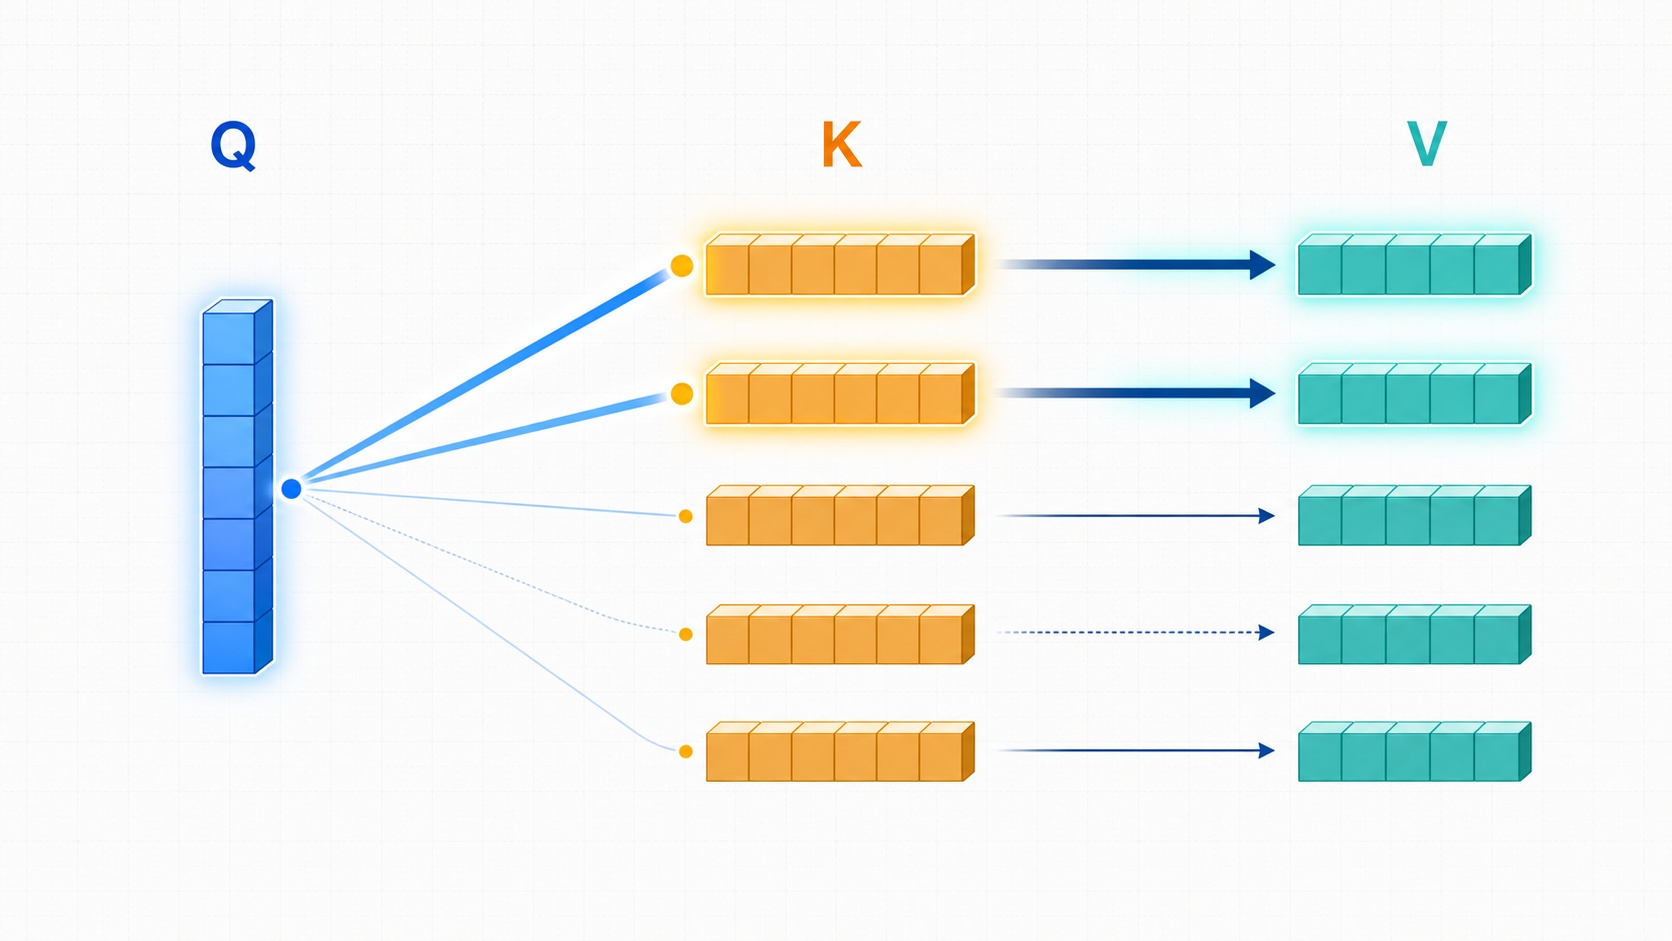
図:QとKの比較強度が変化することで、Vの反映比重が決定される過程
例えば、次の文章を処理するとします。
대한민국의 수도는 서울이다Prefillや学習過程で「서울(ソウル)」の位置の表現を計算する場合、Q_ソウルは自身と前方のトークンのKを比較できます。
Q서울 · K대한민국 → 국가 문맥과의 관련도
Q서울 · K수도     → 수도 개념과의 관련도
Q서울 · K는       → 문법적 관계와의 관련도
Q서울 · K서울     → 현재 위치 자체와의 관련도
関連度スコアが次のように正規化されたと仮定してみましょう。
대한민국의 K → 0.30
수도의 K     → 0.50
는의 K       → 0.10
서울의 K     → 0.10
すると、「서울(ソウル)」位置のAttention出力は、次のような重み付け合計として考えることができます。
Attention 출력
= V대한민국 × 0.30
 + V수도    × 0.50
 + V는      × 0.10
 + V서울    × 0.10
この結果は、Residual Connection、正規化、Feed Forward Networkなどの次の計算に渡されます。複数のレイヤーを通過するにつれて、トークン表現は周囲の文脈をますます反映するようになります。
ここで一つ区別する必要があります。モデルがまだ「서울(ソウル)」を生成する前であれば、未来のトークンである「서울(ソウル)」のQは存在しません。その時は、プロンプトの最後のトークン位置の表現で次のトークン「서울(ソウル)」の確率を予測します。Q_ソウルという説明は、「서울(ソウル)」トークンが入力にすでに含まれているか、生成された後にその位置の文脈表現を計算する状況に該当します。
Scaled Dot-Product Attentionはどのように計算されるのか
Attentionの代表的な公式は次の通りです。
Attention(Q, K, V)
= softmax(QKᵀ / √dₖ + M) V
ここでdₖは一つのAttention Headで使用するKeyベクトルの次元であり、MはAttention Maskです。Decoder-onlyモデルのCausal Maskは、未来の位置のスコアに非常に大きな負の数、概念的には-∞を加えてSoftmaxの結果が0になるようにします。
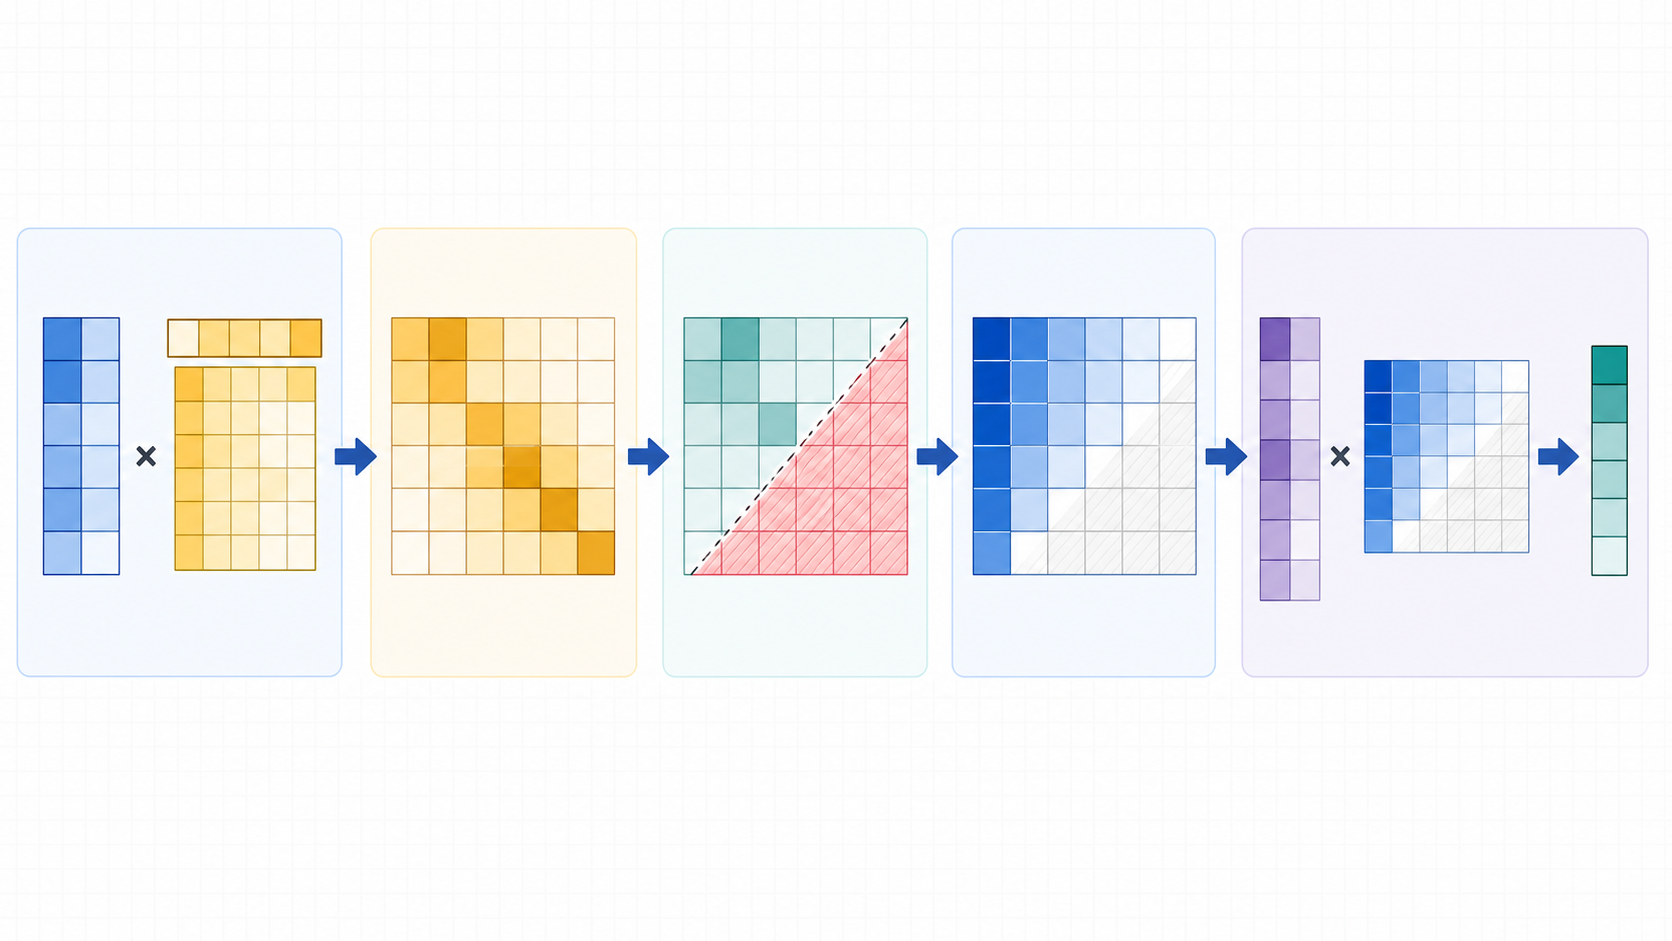
図:スコア行列生成、スケーリング、Causal Mask、Softmax、V重み付け合計へと続くAttentionパイプライン
計算を段階別に分けると次の通りです。
1. QとKの内積で関連度スコアを作成する
scores = QKᵀQの1行とKの1行の内積が、2つのベクトルの関連度スコアになります。複数のトークンを一度に計算すると、トークンとトークンの間のスコアが含まれる行列が作成されます。
2. √dₖで割る
ベクトル次元が大きくなると、内積値の大きさも大きくなる可能性があります。スコアが過度に大きくなると、Softmaxが一方向に飽和し、学習が不安定になる可能性があるため、√dₖで割って大きさを調整します。
scaled_scores = scores / √dₖ3. マスクを適用する
Decoder-onlyモデルは次のトークンを予測する必要があるため、現在の位置より後ろにある未来のトークンを参照してはいけません。
allowed position → 점수 유지
future position  → -∞를 더함
4. Softmaxで重みを作成する
weights = softmax(masked_scores)各行のスコアは合計が1になる重みに変わります。未来の位置の重みは0になり、関連度が高い過去・現在の位置の重みは大きくなります。
5. Vを重み付け合計する
context = weights × V最終結果は、関連度が高いValueをより多く反映した新しい文脈ベクトルです。
Multi-Head Attentionでは何が変わるのか
実際のTransformerは、Q・K・Vを一度の観点だけで比較するわけではありません。複数のAttention Headが異なる部分空間で関係を学習します。
あるHeadは文法的な依存関係を強く見ることができ、別のHeadは遠く離れた主語と述語の関係や特定の個体の繰り返しをよりよく捉えることができます。
Head 1 → Q1, K1, V1 → Attention 결과 1
Head 2 → Q2, K2, V2 → Attention 결과 2
Head 3 → Q3, K3, V3 → Attention 결과 3
...
各Headの結果を連結し、出力射影行列WOを通過させると、レイヤーのMulti-Head Attention出力になります。
MultiHead(Q, K, V)
= Concat(head1, head2, ..., headh) WO
現代のLLMでは、すべてのQuery Headが独立したK・V Headを持つMHAだけでなく、複数のQuery HeadがK・Vを共有するGQA (Grouped Query Attention)やMQA (Multi-Query Attention)も多く使用されます。この構造は、KVキャッシュのサイズとメモリ帯域幅を削減する上で重要な役割を果たします。
Prefill段階:プロンプト全体を一度に処理する
入力が次のようであるとします。
생성형 AI는 문장을トークン化結果を単純に表現すると次の通りです。
생성형 / AI / 는 / 문장 / 을Prefill段階では、プロンプトのすべてのトークンをGPUが並列的に処理します。各レイヤーで、すべての位置のQ・K・Vを作成し、Causal Maskを適用したSelf-Attentionを計算します。
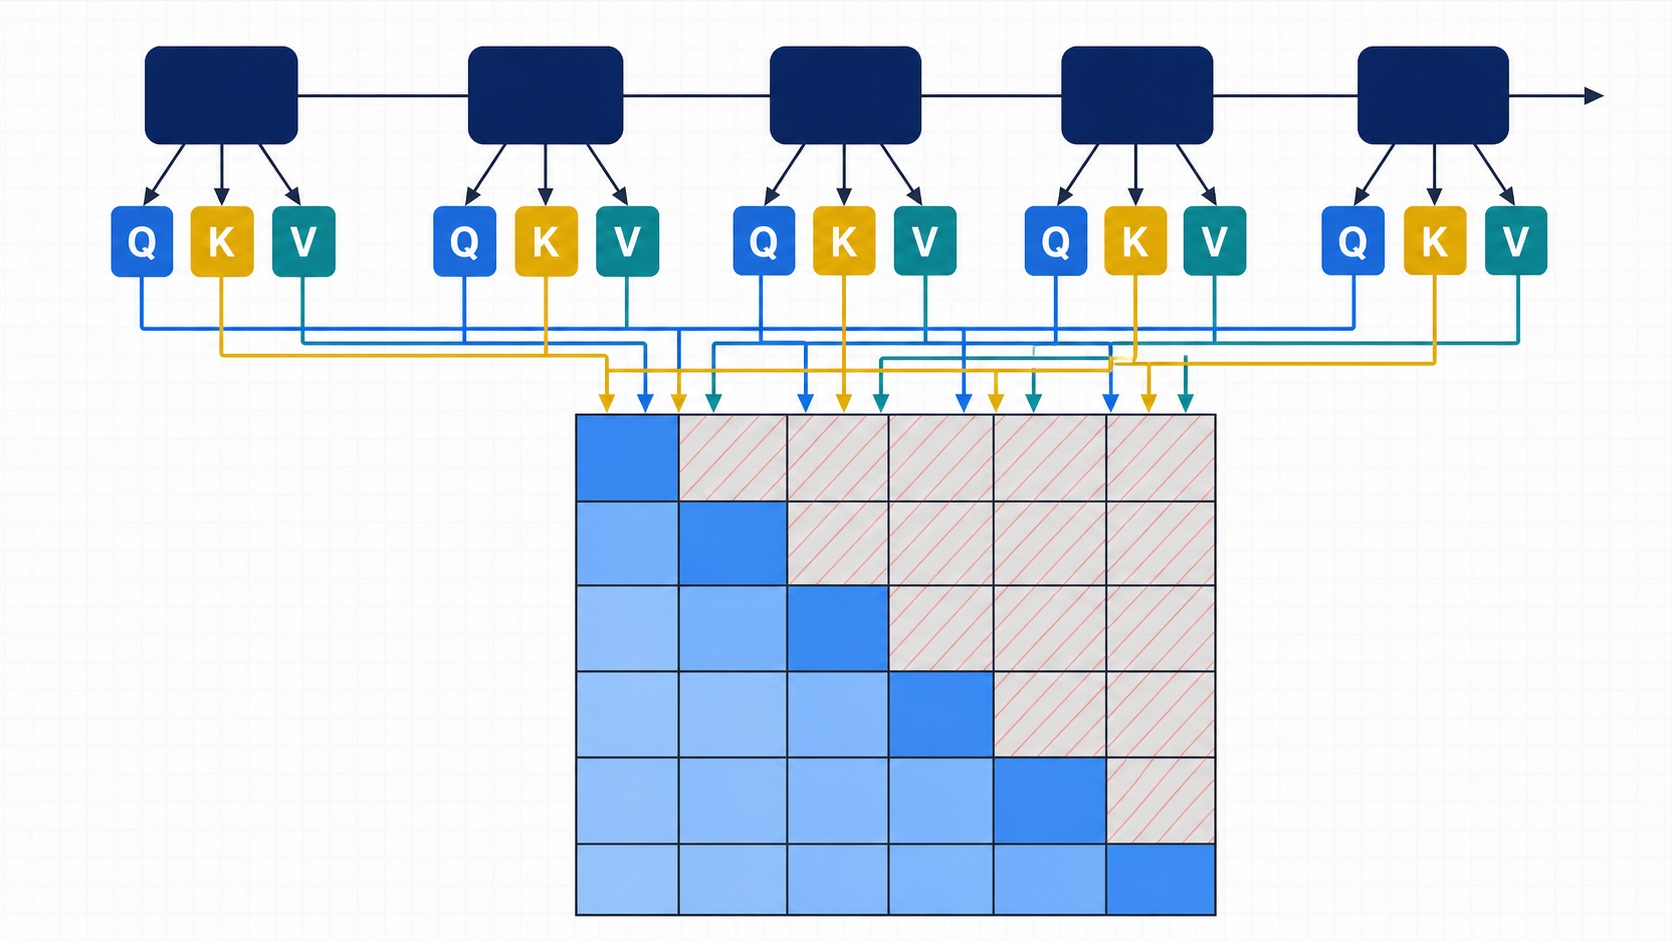
図:すべてのプロンプト位置のQ・K・Vを並列計算するが、未来の位置は三角形マスクで遮断するPrefill
생성형 → Q1, K1, V1
AI     → Q2, K2, V2
는     → Q3, K3, V3
문장   → Q4, K4, V4
을     → Q5, K5, V5
各位置で参照できる範囲は次の通りです。
Q1 → K1
Q2 → K1, K2
Q3 → K1, K2, K3
Q4 → K1, K2, K3, K4
Q5 → K1, K2, K3, K4, K5
行列で見ると、下側の三角形のみが許容される形です。
        K1  K2  K3  K4  K5
Q1      O   X   X   X   X
Q2      O   O   X   X   X
Q3      O   O   O   X   X
Q4      O   O   O   O   X
Q5      O   O   O   O   O
Prefillが完了すると、各レイヤーでプロンプトトークンのKとVがKVキャッシュに保存されます。次のトークンの確率を計算する際には、通常、最後の入力位置の最終Hidden Stateから得られたLogitsを使用します。
생성형 AI는 문장을
→ 다음 토큰 후보의 확률
→ "처리" 선택Prefillは、多くのトークンを並列計算できるため、GPU演算量を積極的に活用する区間です。長いプロンプトを読み込む際に最初のトークンが遅れて出てくる理由であるTTFT (Time To First Token)と密接に関連しています。
Decode段階:新しいトークンを一つずつ生成する
最初の出力トークンとして「처리(処理)」が選択されたとします。次のDecode Stepでは、プロンプト全体を再度モデルに入力する代わりに、新しいトークン「처리(処理)」のみを入力します。
各レイヤーは新しいトークンのQ・K・Vを計算します。
"처리"
→ q6, k6, v6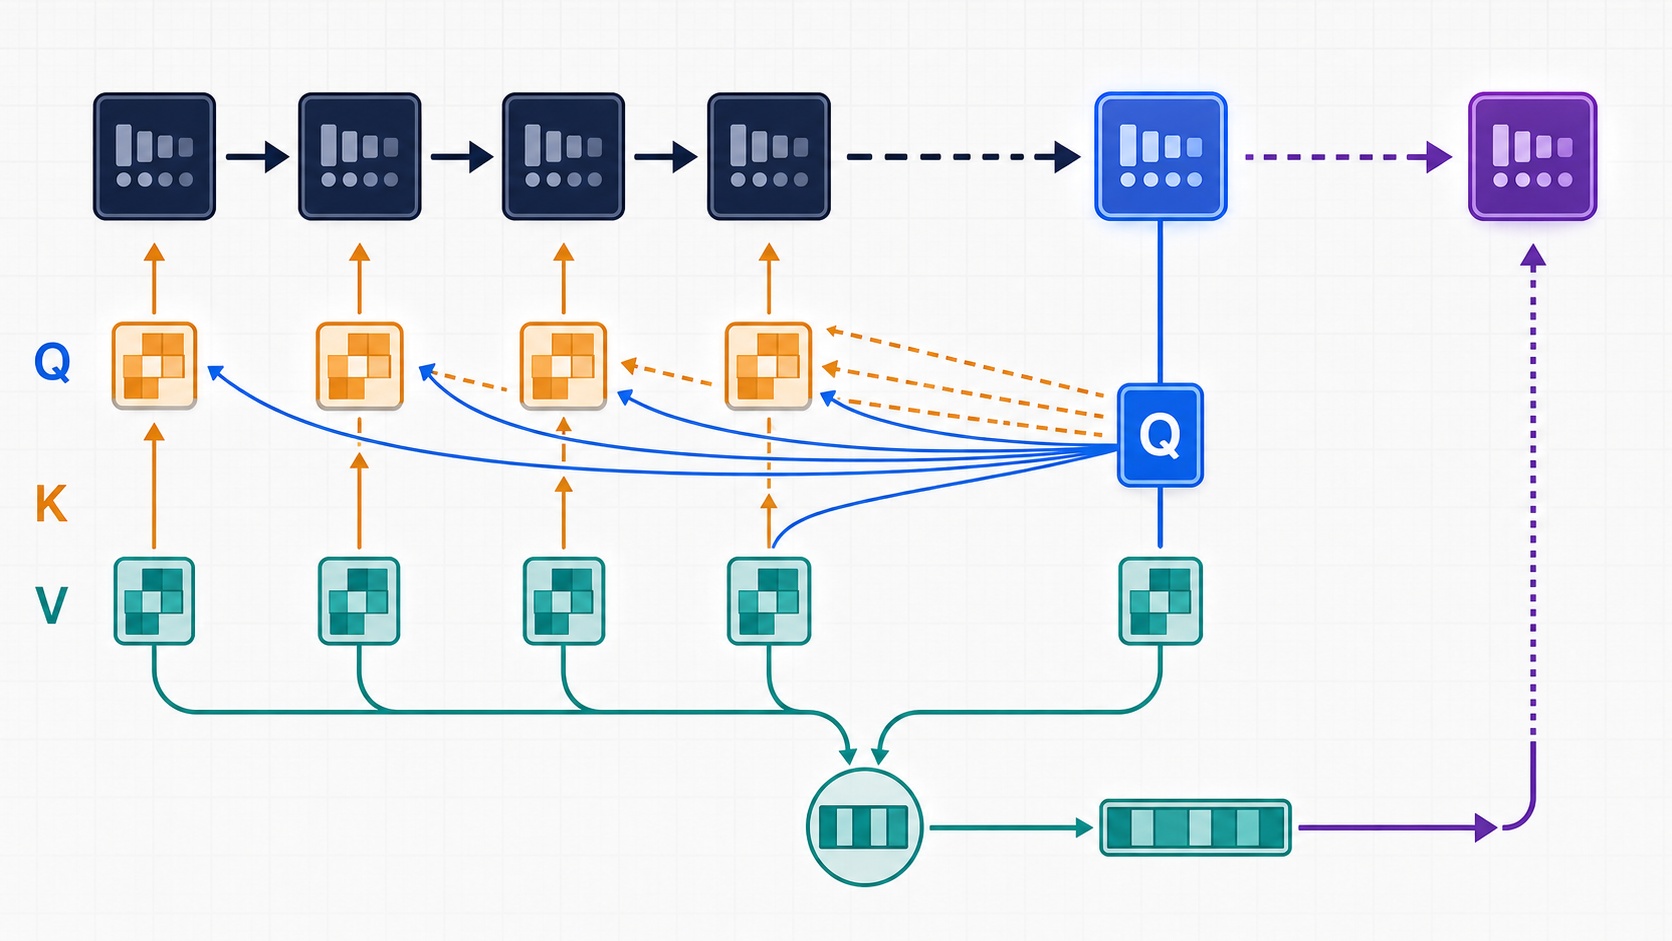
図:現在のトークン一つのQが過去のKを照会し、Vを重み付け合計して次のトークンを生成する直列Decode過程
現在のレイヤーでは、q6はキャッシュに保存された過去のKと新しいk6を一緒に比較します。
q6
→ [k1, k2, k3, k4, k5, k6]과 비교
そのスコアで過去と現在のVを重み付け合計します。
[v1, v2, v3, v4, v5, v6]
→ Attention 가중합
→ "처리" 위치의 문맥 벡터
この計算がすべてのTransformer Layerを通過した後、最後のHidden StateがVocabularyサイズのLogitsに変換されます。
문맥 벡터
→ LM Head
→ 다음 토큰별 Logit
→ Softmax 또는 Sampling
→ "한다" 선택次に「한다(する)」を入力として同じ過程を繰り返します。このように、以前に生成されたトークンを再度入力として使用し、次のトークンを一つずつ生成する方式をAutoregressive Decodingと呼びます。
Prefillとは異なり、Decodeは次の段階が前の段階の結果を待つ必要があります。トークンを完全に並列で生成することはできず、毎段階でKVキャッシュを読み込む必要があるため、メモリ帯域幅とトークンごとの遅延時間の影響を大きく受けます。
KVキャッシュは何を保存するのか
KVキャッシュは、すでに処理したトークンのKeyとValueをレイヤーごとに保存するメモリです。
Layer 1 KV Cache
K1, K2, K3, K4, K5
V1, V2, V3, V4, V5

Layer 2 KV Cache
K1, K2, K3, K4, K5
V1, V2, V3, V4, V5

...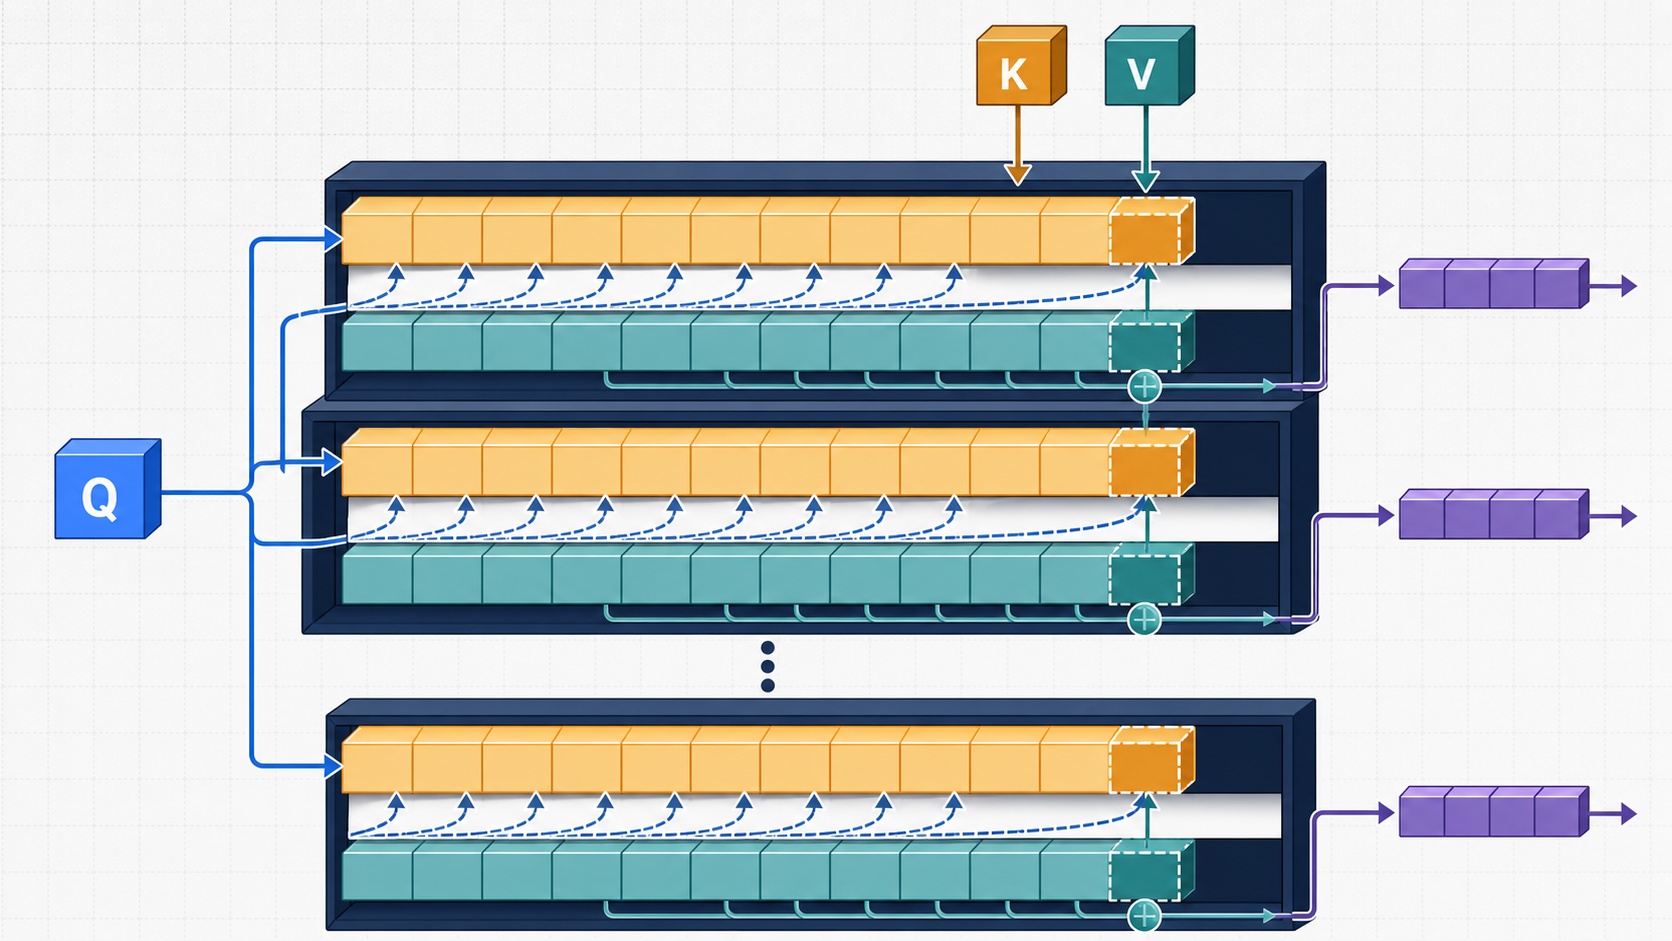
図:レイヤーごとに保存された過去のK・Vを再度読み込み、現在のトークンの新しいK・Vのみを末尾に追加するKVキャッシュ
新しいトークンが入力されると、各レイヤーはそのトークンのKとVのみをキャッシュに追加します。
Kcache ← concat(Kpast, k현재)
Vcache ← concat(Vpast, v현재)
現在のトークンのQはAttention計算にすぐに使用されますが、次のトークン段階で再度使用する必要はありません。
| ベクトル | 現在のDecode Step | 以降のStepでの処理 |
| — | — | — |
| 現在のQ | キャッシュされたKと関連度計算 | 一般的に保存しない |
| 現在のK | 現在のQと比較 | KVキャッシュに追加 |
| 現在のV | 現在の出力の重み付け合計に参加 | KVキャッシュに追加 |
| 過去のK・V | 現在のQが照会 | キャッシュから繰り返し再利用 |
| 過去のQ | 使用しない | 再計算または保存する必要なし |
全体の流れは次の通りです。
현재 토큰
  ↓
q현재, k현재, v현재 계산
  ↓
q현재 × [K과거 + k현재]ᵀ
  ↓
Attention 가중치
  ↓
[V과거 + v현재] 가중합
  ↓
현재 위치의 문맥 벡터
  ↓
다음 토큰 확률 계산
KVキャッシュがなければどのような計算が繰り返されるのか
KVキャッシュがなければ、トークンを一つ生成するたびに、これまでのシーケンス全体を再度処理する必要があります。
첫 번째 생성
프롬프트 전체 계산

두 번째 생성
프롬프트 + 첫 출력 전체 계산

세 번째 생성
프롬프트 + 첫 출력 + 두 번째 출력 전체 계산
KVキャッシュを使用すると、すでに処理した位置のKとVの射影結果を再利用できます。
첫 번째 생성
프롬프트의 K·V 저장

두 번째 생성
새 토큰의 q·k·v만 계산
+ 과거 K·V 재사용

세 번째 생성
다시 새 토큰의 q·k·v만 계산
+ 더 길어진 과거 K·V 재사용
しかし、KVキャッシュがAttention計算を完全に一定のコストにするわけではありません。新しいQueryは、シーケンスが長くなるにつれて、より多くの過去のKeyと比較し、Valueを読み込む必要があります。
없어지는 비용
→ 과거 토큰의 K·V를 다시 투영하는 계산

남아 있는 비용
→ 현재 Q와 전체 캐시 K의 비교
→ 전체 캐시 V의 가중합
→ 길어진 Cache를 읽는 메모리 비용
つまり、KVキャッシュは重複計算を大幅に削減しますが、コンテキストが長くなるにつれてAttentionの参照量とメモリ使用量が増加する問題まで解消するわけではありません。
KVキャッシュのメモリはなぜ大きくなるのか
基本的なKVキャッシュのサイズは、次の要素に比例します。
KV Cache 크기
≈ 2
× Transformer Layer 수
× KV Head 수
× Head 차원
× 저장 토큰 수
× 배치 크기
× 원소당 바이트
前の2は、KとVの両方を保存するためです。コンテキストが長くなったり、同時に処理するリクエストが多くなると、キャッシュが急速に大きくなる可能性があります。
そのため、実際のLLM Servingでは次のような最適化が使用されます。
- GQA・MQAでKV Head数を減らす
- KVキャッシュをより低い精度で量子化する
- 一部のレイヤーキャッシュをCPUにオフロードする
- Sliding Window Attentionで古いトークンの範囲を制限する
- Paged Attentionでキャッシュメモリをページ単位で管理する
- 共通PrefixのKVキャッシュを複数のリクエストで再利用する
各方法には、速度、メモリ、精度、実装の複雑さの間にトレードオフがあります。
KVキャッシュを理解する際によくある誤解
KVキャッシュはモデルの長期記憶ではない
KVキャッシュは、現在のリクエストで既に処理されたトークンのAttention用中間結果です。会話が終わりキャッシュが破棄されても、モデルパラメータに新しい知識が残るわけではありません。
キャッシュにはトークン原文だけが保存されるわけではない
トークンIDや文字列を保管する単純な記録ではなく、各Transformer Layerで計算されたK・Vテンソルが保存されます。したがって、モデルサイズとレイヤー構造、KV Head数がメモリ使用量に直接影響を与えます。
過去の文章が変わるとキャッシュをそのまま使用できない
KVは以前のトークンと位置情報、先行するレイヤー計算に依存します。前部分のトークンが変わると、その後のキャッシュももはや同じ文脈を示さないため、変更点以降を再計算する必要があります。
KVキャッシュは主に推論用である
学習では、シーケンス全体のGradientを計算する必要があるため、一般的な生成用KVキャッシュを同じ方法で使用しません。Hugging Faceのドキュメントも、キャッシュは推論で使用すべきだと案内しています。
一つの場面で再度整理する
Q・K・VとKVキャッシュを時系列順に繋げると次の通りです。
1. 프롬프트 토큰화
2. Prefill에서 모든 프롬프트 위치의 Q·K·V 계산
3. Causal Mask를 적용해 미래 토큰 참조 차단
4. 각 레이어의 프롬프트 K·V를 Cache에 저장
5. 마지막 위치의 Logits로 첫 출력 토큰 선택
6. 새 토큰의 q·k·v만 계산
7. q로 캐시된 K를 조회하고 V를 가중합
8. 새 k·v를 Cache 끝에 추가
9. 다음 토큰을 선택하고 6번부터 반복
核心だけを圧縮すると次の通りです。
Qは現在の位置が何を参照するかを問うベクトルであり、Kは各位置がどのような情報と関連するかを示すものであり、Vは選択されたときに実際に伝達する情報である。
そして、推論性能の観点からの核心は次の通りです。
過去トークンのKとVはレイヤー別KVキャッシュに保存して再利用し、新しいトークンが生成されるたびに現在のトークンのKとVのみを追加する。ただし、新しいQは依然として全体のキャッシュのKとVを照会する必要があるため、長いコンテキストの計算量とメモリコストが完全に消えるわけではない。
Q・K・VはLLMが文脈を選択する原理であり、KVキャッシュはその選択を毎トークンごとに現実的な速度で繰り返させる推論最適化であると理解できます。
コメントを残す