皆さん、こんにちは!本日は、Kubernetes環境でシステムを監視および追跡する際に誰もが一度は直面したであろう問題を解決する、OpenTelemetry Collectorの主要なプロセッサについて深く掘り下げていきます。
もしかして、こんな経験はありませんか?🤔
「アプリケーションのログとトレースデータが大量に流れ込んできているのに…一体どのPod、どのNamespaceからのデータなのか分からない!デバッグが大変すぎる…😭」
このような途方に暮れる状況を一発で解決してくれるヒーローが、本日私たちが一緒に学ぶプロセッサたちです。特に、質問の答えであるk8sattributesを中心に、他のプロセッサがどのような役割を果たし、どのように組み合わせて使用するのか、すべてお伝えします!
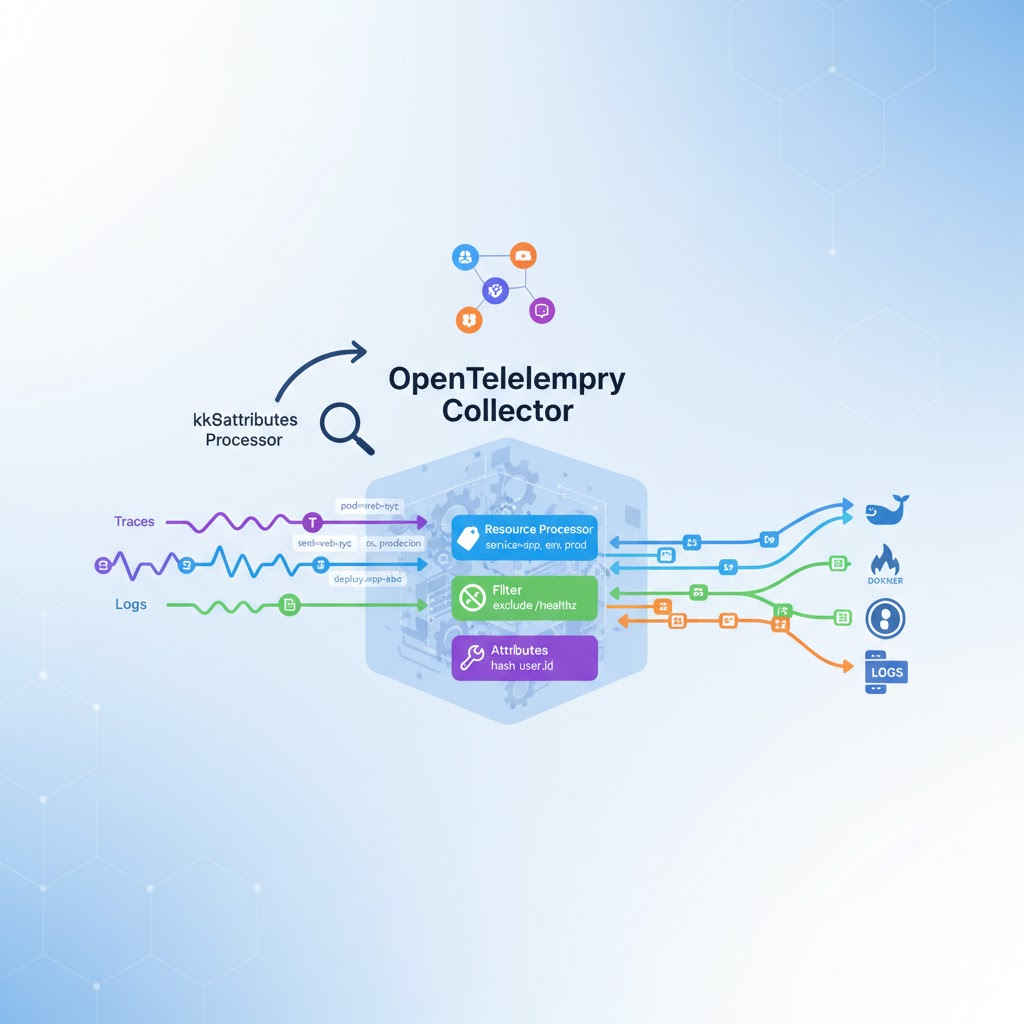
⭐ 今日の主役:Kubernetes Attributes Processor (k8sattributes)
質問の答えであったk8sattributesプロセッサは、その名の通りKubernetes環境のための専用プロセッサです。このプロセッサの役割は非常に明確で強力です。
- 役割: OTel Collectorに入ってくるテレメトリーデータ(Traces, Metrics, Logs)に、Kubernetesメタデータを自動で豊富に追加します。
- 動作方式: Collectorが実行されている環境のKubernetes APIサーバーと通信します。データが発生したIPアドレスを基に、そのIPがどのPodに属するかをAPIサーバーに問い合わせ、そのPodの名前、ネームスペース、ラベル、アノテーション、デプロイ情報などを取得し、データに「タグ」のように付与します。🕵️♂️
このプロセッサを経由すると、私たちのデータは以下のような素晴らしい属性を持つようになります。
- k8s.pod.name
- k8s.pod.uid
- k8s.pod.ip
- k8s.namespace.name
- k8s.node.name
- k8s.deployment.name
- k8s.replicaset.name
- … などなど!
これらの情報のおかげで、GrafanaやJaegerのようなツールで「特定のNamespaceで発生したエラーログのみを表示する」や「特定のDeploymentに属するPodの平均応答時間を測定する」といった強力なフィルタリングとグループ化が可能になります。
📝 設定例 (otel-collector-config.yaml)
processors:
  k8sattributes:
    # passthroughモードをfalseに設定すると、Collectorが直接K8s APIと通信して
    # IPアドレスに基づいてメタデータを見つけ出します。
    passthrough: false
    # APIサーバーから取得するメタデータルールを定義できます。
    extract:
      metadata:
        - k8s.pod.name
        - k8s.pod.uid
        - k8s.deployment.name
        - k8s.namespace.name
        - k8s.node.name

service:
  pipelines:
    traces:
      receivers: [otlp]
      # パイプラインにk8sattributesプロセッサを追加します。
      processors: [k8sattributes, batch]
      exporters: [logging]
🎛️ 他の候補も見てみましょうか? (Resource, Filter, Attributes)
k8sattributesが正解である理由は分かりましたが、他のプロセッサがどのような役割を果たすのかを知ってこそ、真の専門家と言えるでしょう?
1. Resource Processor (resource) 🏷️
このプロセッサは、入ってくるすべてのデータに静的(Static)なリソース属性を追加する役割を果たします。k8sattributesのように動的に何かを探し出すのではなく、設定ファイルに事前に定義しておいた値を一括で付与します。
- 使用例:
- service.name: my-awesome-app (私たちのサービス名)
- service.version: 1.2.3 (現在のデプロイバージョン)
- environment: production (本番環境か開発環境か)
k8sattributesが「データがどこから来たか」を教えてくれるとすれば、resourceプロセッサは「データを処理するシステムのアイデンティティ」を教えてくれると考えると分かりやすいでしょう。
📝 設定例
processors:
  resource:
    attributes:
      - key: service.version
        value: "1.2.3"
        action: insert
      - key: environment
        value: "production"
        action: insert
2. Filter Processor (filter) 🚫
名前が示す通り、このプロセッサはデータをフィルタリングする役割を果たします。特定の条件に合致するデータを含めたり、除外したりすることができます。
- 使用例:
- /healthzのような頻繁に入ってくるヘルスチェックトレースを除外したい場合
- 特定のIP帯域から入ってくるテストデータは収集したくない場合
デバッグに不要であったり、ストレージコストだけを消費するデータを初期段階で排除する「門番」の役割を果たします。
📝 設定例
processors:
  filter:
    # tracesデータに対するフィルタリングルール
    traces:
      # /healthzという名前を持つspanを除外(exclude)
      span:
        - 'name == "/healthz"'
      action: exclude
3. Attributes Processor (attributes) 🔧
このプロセッサは、すでにデータに存在する属性(Attribute)を操作するための汎用ツールです。特定の属性の追加、変更、削除など、様々な作業を行うことができます。
- 使用例:
- user.id属性値が個人情報保護のために必要であれば、その値をハッシュ処理してuser.id_hashedという新しい属性に置き換える場合
- 複数の属性を組み合わせて新しい属性を作成する場合
- もはや不要な属性を削除(delete)してデータサイズを削減する場合
k8sattributesがKubernetesメタデータの「追加」に特化しているとすれば、attributesプロセッサは既存の属性を「加工」することに重点が置かれています。
📝 設定例
processors:
  attributes:
    actions:
      # http.url属性をhttp.full_urlに名前変更 (rename)
      - key: http.url
        action: update
        new_key: http.full_url
      # user.email属性は機密情報のため削除 (delete)
      - key: user.email
        action: delete
🔗 パイプライン:プロセッサを組み合わせて使用する
実際の環境では、これらのプロセッサをパイプラインに組み込んで順次使用します。
データ受信 (Receiver) -> k8sattributes -> filter -> attributes -> データ送信 (Exporter)
- k8sattributes: まず、Kubernetesメタデータを豊富に追加し、
- filter: 追加されたメタデータに基づいて、「Aネームスペースのヘルスチェックデータは除外してほしい」といった、より精密なフィルタリングを行い、
- attributes: 必要な属性を整理・加工した後、
- Exporter: 最終目的地にデータを送信します。
✨ 結論
これで、Kubernetes環境においてk8sattributesプロセッサがなぜ不可欠なのか、そして他のプロセッサとどのように連携して私たちのデータをより価値あるものにするのか、ご理解いただけたでしょうか?
- Kubernetes Attributes Processor: Kubernetes環境の自動メタデータ追加を担当
- Resource Processor: サービスバージョン、環境など静的情報追加を担当
- Filter Processor: 不要なデータ除外を担当
- Attributes Processor: 既存属性の編集および加工を担当
これらのプロセッサをうまく活用することで、複雑なマイクロサービス環境においてもデータの出所を明確にし、必要なデータだけを効率的に収集して、問題解決能力を飛躍的に向上させることができます。これであなたもOTel Collectorの専門家です!
コメントを残す