大家好!今天,我们将深入探讨OpenTelemetry Collector的核心处理器,它们能够解决在Kubernetes (Kubernetes) 环境中监控和追踪系统时,大家可能都遇到过的问题。
您是否有过这样的经历?🤔
“应用程序日志和追踪数据源源不断地涌入… 但我根本不知道这些数据来自哪个Pod、哪个Namespace!调试太难了… 😭”
能够一举解决这种困境的英雄,正是我们今天将要一起了解的处理器们。特别是,我们将以问题的答案——k8sattributes为中心,向大家介绍其他处理器扮演的角色以及如何协同使用它们!
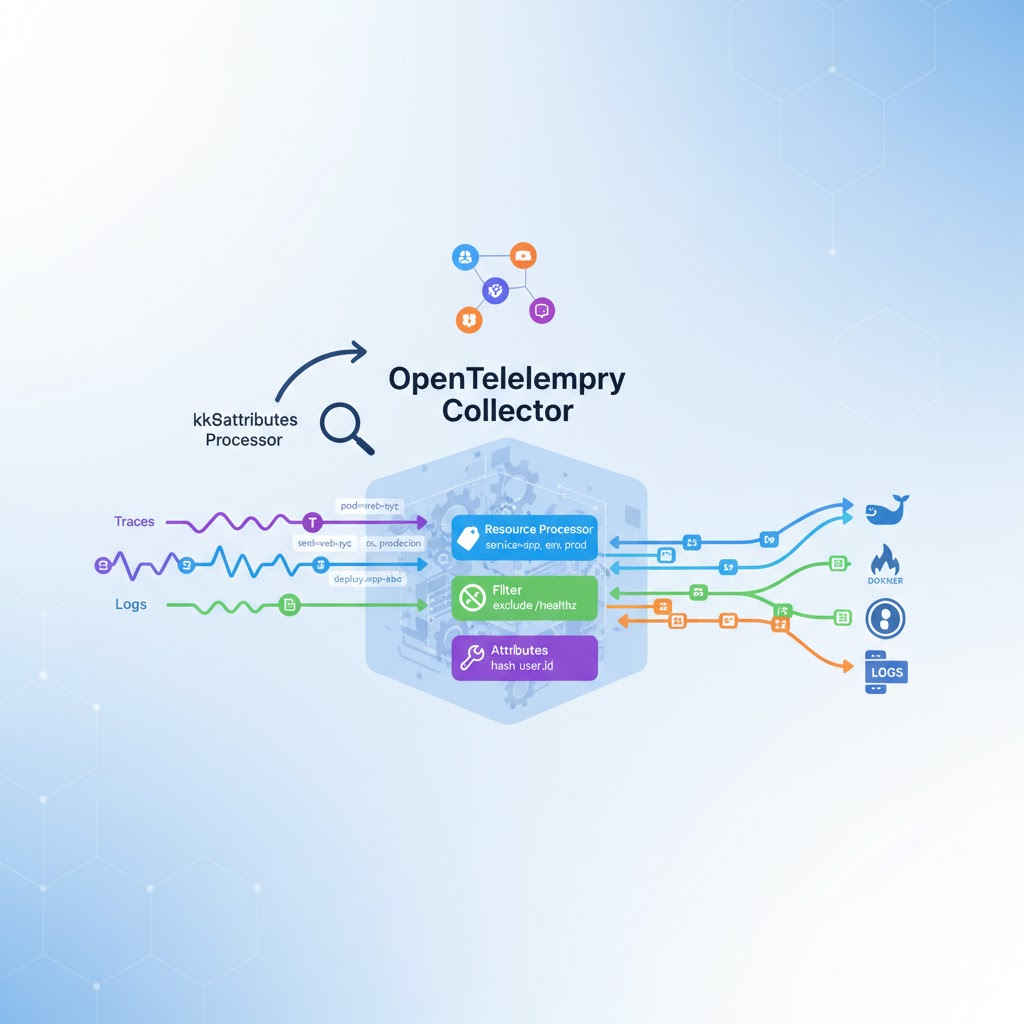
⭐ 今日主角:Kubernetes Attributes Processor (k8sattributes)
k8sattributes 处理器,正是问题的答案,顾名思义,它是专为 Kubernetes 环境设计的专用处理器。它的作用非常明确且强大。
- 作用:它会自动且丰富地将Kubernetes元数据添加到流入OTel Collector的遥测数据(Traces, Metrics, Logs)中。
- 工作方式:Collector与运行环境中的Kubernetes API服务器通信。它根据数据产生的IP地址,查询API服务器以确定该IP属于哪个Pod,然后获取该Pod的名称、命名空间、标签、注解、部署信息等,并像“标签”一样附加到数据上。🕵️♂️
经过这个处理器处理后,我们的数据将拥有以下出色的属性:
- k8s.pod.name
- k8s.pod.uid
- k8s.pod.ip
- k8s.namespace.name
- k8s.node.name
- k8s.deployment.name
- k8s.replicaset.name
- … 等等!
得益于这些信息,我们可以在 Grafana、Jaeger 等工具中进行强大的过滤和分组,例如“只查看特定命名空间中发生的错误日志”或“测量属于特定部署的 Pod 的平均响应时间”。
📝 配置示例 (otel-collector-config.yaml)
processors:
  k8sattributes:
    # 将 passthrough 模式设置为 false,Collector 将直接与 K8s API 通信以
    # 基于 IP 地址查找元数据。
    passthrough: false
    # 可以定义从 API 服务器获取元数据的规则。
    extract:
      metadata:
        - k8s.pod.name
        - k8s.pod.uid
        - k8s.deployment.name
        - k8s.namespace.name
        - k8s.node.name

service:
  pipelines:
    traces:
      receivers: [otlp]
      # 将 k8sattributes 处理器添加到管道中。
      processors: [k8sattributes, batch]
      exporters: [logging]
🎛️ 让我们看看其他候选者? (Resource, Filter, Attributes)
我们已经知道了 k8sattributes 是答案,但要成为真正的专家,了解其他处理器扮演的角色也是必不可少的,对吗?
1. Resource Processor (resource) 🏷️
这个处理器负责为所有传入数据添加静态(Static)资源属性。它不像 k8sattributes 那样动态地查找信息,而是将配置文件中预定义的值统一附加到数据上。
- 使用示例:
- service.name: my-awesome-app (我们的服务名称)
- service.version: 1.2.3 (当前部署版本)
- environment: production (是生产环境还是开发环境)
如果说 k8sattributes 告诉我们“数据来自何处”,那么 resource 处理器则可以理解为告诉我们“处理数据的系统的身份”。
📝 配置示例
processors:
  resource:
    attributes:
      - key: service.version
        value: "1.2.3"
        action: insert
      - key: environment
        value: "production"
        action: insert
2. Filter Processor (filter) 🚫
顾名思义,这个处理器负责过滤数据。它可以包含或排除符合特定条件的数据。
- 使用示例:
- 当您想排除过多涌入的 /healthz 等健康检查追踪数据时。
- 当您不想收集来自特定 IP 范围的测试数据时。
它扮演着“看门人”的角色,在早期阶段就剔除那些对调试无用或只会增加存储成本的数据。
📝 配置示例
processors:
  filter:
    # 追踪数据的过滤规则
    traces:
      # 排除 (exclude) 名为 /healthz 的 span
      span:
        - 'name == "/healthz"'
      action: exclude
3. Attributes Processor (attributes) 🔧
这个处理器是一个通用的工具,用于操作数据中已有的属性(Attribute)。它可以执行各种操作,例如添加、修改或删除特定属性。
- 使用示例:
- 如果 user.id 属性值出于隐私保护需要,可以对其进行哈希处理,并替换为一个名为 user.id_hashed 的新属性。
- 当组合多个属性以创建新属性时。
- 当删除(delete)不再需要的属性以减小数据大小时。
如果说 k8sattributes 专注于“添加”Kubernetes 元数据,那么 attributes 处理器则更侧重于“处理”现有属性。
📝 配置示例
processors:
  attributes:
    actions:
      # 将 http.url 属性重命名 (rename) 为 http.full_url
      - key: http.url
        action: update
        new_key: http.full_url
      # user.email 属性是敏感信息,因此删除 (delete)
      - key: user.email
        action: delete
🔗 管道:协同使用处理器
在实际环境中,这些处理器会通过管道(Pipeline)串联起来,按顺序使用。
数据接收 (Receiver) -> k8sattributes -> filter -> attributes -> 数据发送 (Exporter)
- k8sattributes:首先,它丰富地添加 Kubernetes 元数据,
- filter:然后,基于添加的元数据,进行更精细的过滤,例如“排除来自命名空间 A 的健康检查数据”,
- attributes:整理并处理所需的属性后,
- Exporter:最后,将数据发送到最终目的地。
✨ 结论
现在,您是否理解了为什么 k8sattributes 处理器在 Kubernetes 环境中至关重要,以及它如何与其他处理器协作,使我们的数据更具价值?
- Kubernetes Attributes Processor:负责 Kubernetes 环境的自动元数据添加。
- Resource Processor:负责添加静态信息,如服务版本、环境等。
- Filter Processor:负责排除不必要的数据。
- Attributes Processor:负责编辑和处理现有属性。
善用这些处理器,即使在复杂的微服务环境中,您也能明确数据的来源,高效地收集所需数据,从而显著提升问题解决能力。现在,您也是 OTel Collector 专家了!
发表回复