こんにちは!MSA(マイクロサービスアーキテクチャ)環境において、システムの状況を把握し問題を解決するために、「分散トレーシング(Distributed Tracing)」はもはや選択肢ではなく必須の技術となっています。しかし、すべてのリクエストを追跡して保存することは、膨大な量のデータを発生させ、コストとパフォーマンスに負担をかける可能性があります。😥
この問題を解決するために、私たちは 「サンプリング(Sampling)」 という手法を使用します。つまり、全体のトレースの中から一部だけを選別して保存するのです。サンプリングには大きく分けて2つの方式があり、それが ヘッドベース(Head-based) と テールベース(Tail-based) サンプリングです。
今日は、これら2つの方式がどのように異なり、それぞれどのような長所と短所を持っているのかを、分かりやすく詳しく見ていきましょう!
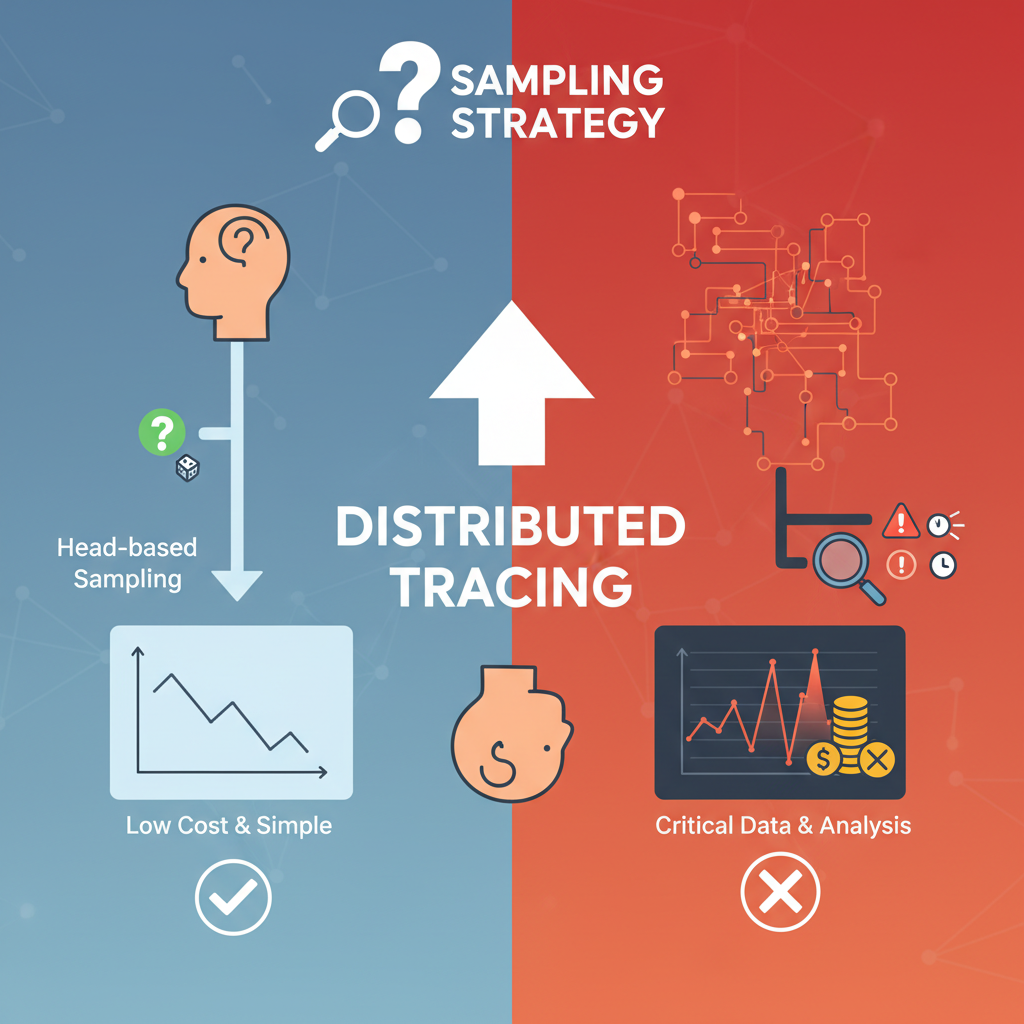
🚀 事前決定!ヘッドベースサンプリング (Head-based Sampling)
ヘッドベースサンプリングは、その名の通り、トレースの 「頭(Head)」 で全てを決定する方式です。
もう少し詳しく説明すると、 分散トレーシングの最初のリクエスト(スパン)が開始されるまさにその瞬間に、「このトレースを記録するか、しないか?」を決定 します。この決定はトレースが完全に終了する前に行われ、一度決定されると、そのトレースに属するすべての下位リクエスト(スパン)に同じように伝播されます。
🤔 どのように動作しますか?
- システムに最初のリクエストが入り、トレースが開始されます。
- この時、事前に設定されたサンプリング比率(例:10%のトレースのみ保存)に従って、確率的にサンプリングの有無を決定します。🎲
- 「サンプリング決定」情報はコンテキスト(Context)に格納され、次のサービスへと継続的に伝達されます。
- もし最初に「保存しない」と決定された場合、このトレースに関連するすべてのリクエストデータは収集されません。
👍 長所:
- 軽量で高速です: トレース開始と同時に決定するため、システム負荷が少なく、実装が簡単です。
- リソース効率的: 全体のトレースをメモリに保持する必要がないため、リソース使用量が非常に低いです。
- 予測可能なコスト: 決められた比率でサンプリングするため、データ保存コストを予測しやすいです。
👎 短所:
- 重要なデータを見逃す可能性があります: サンプリング決定が無作為に行われるため、ごく稀に発生する重要なエラーや深刻な遅延現象を含むトレースを見逃す可能性が高いです。(宝くじの当選者に入場券を渡さないようなものです!)
🧐 事後決定!テールベースサンプリング (Tail-based Sampling)
テールベースサンプリングは、ヘッドベースとは正反対です。トレースの 「尾(Tail)」、つまり すべての作業が完了した後にサンプリングの有無を決定 する方式です。
すべてのスパン(span)が収集され、一つの完全なトレースが作成された後、そのトレースの全体的な内容を詳細に確認し、保存する価値があるかどうかを判断します。
🤔 どのように動作しますか?
- 一つのトレースに属するすべてのリクエスト(スパン)データを、まず一時的に収集して全体のトレースを再構成します。🧩
- 完成したトレース情報に基づいて、事前に定義されたルールに従ってサンプリングの有無を決定します。
- ルール例:
- トレースに「エラー(Error)」が含まれているか?🚨
- 全体の処理時間が500msを超過したか?🐢
- 「決済」のような特定の重要ビジネスロジックを含んでいるか?💰
- ルールに合致する「価値のある」トレースのみを最終的に保存します。
👍 長所:
- 高い可視性を確保: エラーが発生したり、特に遅いリクエストなど、分析に不可欠な重要なトレースを100%収集できます。
- 正確な分析: システムの異常状況を見逃さないため、デバッグや性能分析に非常に有用です。
👎 短所:
- 高いリソース使用量: すべてのトレースデータを一旦メモリやバッファに保持する必要があるため、より多くのコンピューティングリソースとストレージスペースが必要です。
- 実装の複雑性: すべてのスパンを収集し、再構成して分析するロジックが必要なため、実装がより複雑になります。
📊 一目でわかる比較!
| 区分 | ヘッドベースサンプリング (Head-based) | テールベースサンプリング (Tail-based) |
| 決定時点 | トレース 開始前 (最初のスパン生成時) | トレース 完了後 (すべてのスパン収集後) |
| 判断基準 | 確率(例:10%比率) | トレースの全体内容(エラー、遅延時間など) |
| 長所 | ✅ 低コスト、シンプル、リソース効率的 | ✅ 重要なデータ確保、正確な分析 |
| 短所 | ❌ 重要なデータ見逃しの可能性 | ❌ 高コスト、複雑、高いリソース使用量 |
| 推奨対象 | システムの全体的なトラフィックフロー把握 | 障害分析、SLO/SLAモニタリングなど |
## ✨ 結論
結論として、 ヘッドベースサンプリング はトレースが 完了する前 に決定を下し、 テールベースサンプリング はトレースが 完了した後 に決定を下す、というのが最も核心的な違いです。
どちらの方式が絶対的に優れているとは言えません。システムの規模、コスト、そして何を観察したいのかによって、適切なサンプリング戦略を選択することが重要です。
- 「私たちのシステムが普段どのように動作しているか、大まかな統計だけを見たい」 のであれば、 ヘッドベースサンプリング が良い出発点となるでしょう。
- 「絶対に見逃してはならないエラーや性能低下をすべて捕捉したい!」 のであれば、 テールベースサンプリング を積極的に検討すべきです。
皆様のシステムにぴったりのサンプリング戦略を選択し、より安定した信頼性の高いサービスを構築していかれることを願っています!😊
コメントを残す