大家好!随着微服务架构(MSA)和云原生环境成为主流,理解系统状态并快速解决问题的能力,即可观测性(Observability),其重要性比以往任何时候都更加突出。👨💻
在海量数据中寻找有意义的洞察,许多人可能正在使用Grafana。今天,我们将超越简单的仪表盘,深入探讨以Grafana为中心构建完整可观测性的开源复仇者联盟——LGTM堆栈!
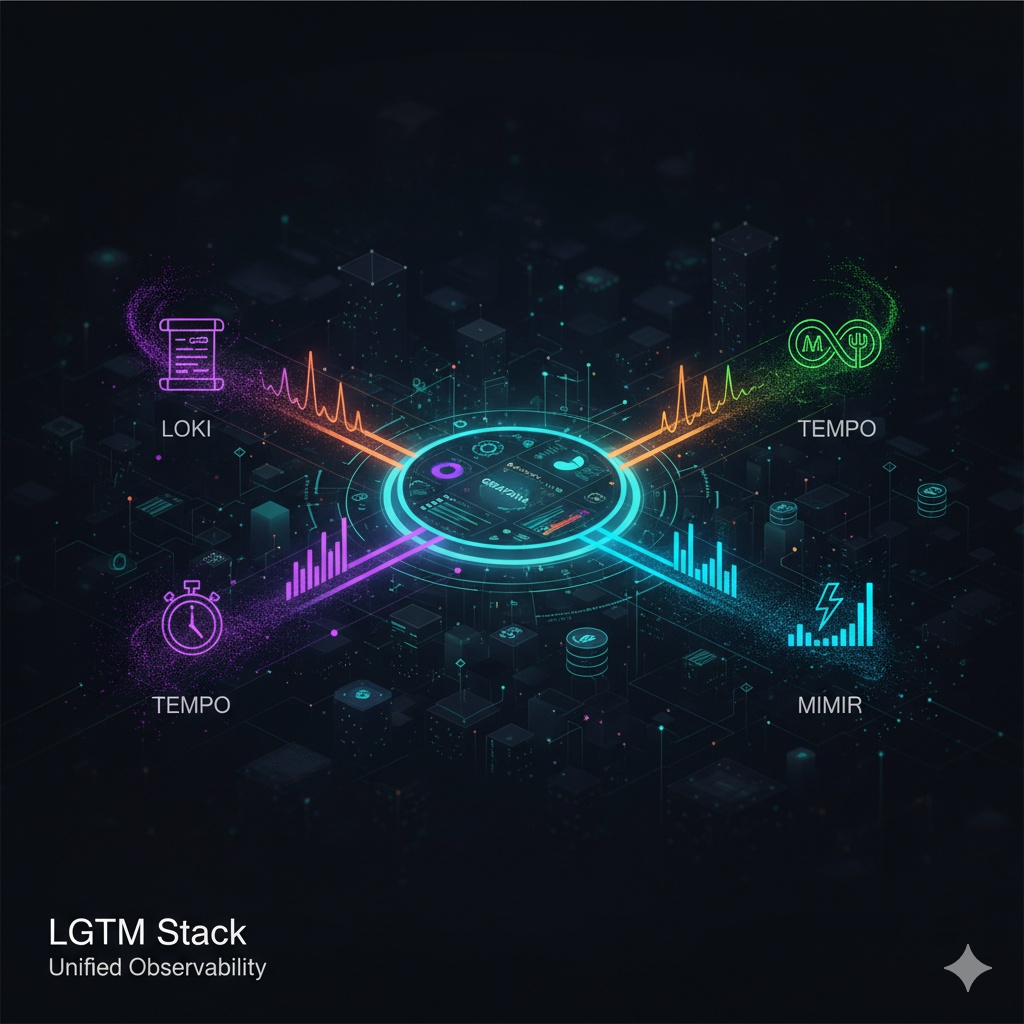
🤔 什么是LGTM堆栈?
LGTM在代码审查中常被用作“Looks Good To Me”,但在可观测性领域,它是Grafana Labs主导的一个强大开源堆栈的缩写。
- Loki: Logging (日志收集与查询) 📜
- Grafana: Graphing & Visualization (图表与可视化) 📊
- Tempo: Tracing (分布式追踪) ⛓️
- Mimir: Metrics (指标存储与查询) 📈
这四个工具分别负责可观测性的三大支柱:日志、指标和追踪。它们通过Grafana这一单一界面,将所有数据有机地连接起来并进行分析。这就像散落的拼图碎片被拼凑在一起!🧩
1️⃣ L for Loki: 日志领域的新生力量 📜
传统的日志解决方案(例如ELK堆栈)通过对所有收集到的日志进行全文索引来提供强大的搜索功能,但这带来了不菲的存储成本和资源消耗。
Loki是改变这一范式的关键角色。它始于一个想法:“不索引日志内容,只索引元数据!”
- 核心特点:
- 轻量 & 成本效益: 不索引整个日志内容,只索引诸如namespace=”production”, app=”api-server”之类的标签(元数据)。这显著降低了存储成本和索引所需的资源。💰
- 易于操作: 结构简单,安装和操作非常容易。
- LogQL: 使用受Prometheus的PromQL启发的查询语言,可以基于标签快速高效地搜索和过滤日志。
使用Loki,您可以像Prometheus处理指标一样,经济高效地存储日志并在需要时快速查找。
2️⃣ G for Grafana: 面向所有人的可视化工具 📊
Grafana是可观测性领域当之无愧的超级明星。🌟 它最初专注于可视化Prometheus等时序数据库(TSDB)的数据,但现在已发展成为一个支持几乎所有类型数据源的多功能可视化平台。
- 核心特点:
- 支持多种数据源: 以插件形式支持超过100种数据源,包括Prometheus、MySQL、PostgreSQL、Elasticsearch、AWS CloudWatch等。
- 美观灵活的仪表盘: 任何人都可以通过拖放方式轻松创建专业的仪表盘。它提供了各种面板和可视化选项。
- 强大的告警功能: 可以在仪表盘的特定面板上设置阈值,并通过Slack、PagerDuty、电子邮件等多种渠道发送告警。🚨
- 统一的用户界面: 作为网关,它允许在单一用户界面中探索和关联LGTM堆栈的所有数据(日志、指标、追踪)。
3️⃣ T for Tempo: 简单且大规模的分布式追踪 ⛓️
在微服务环境中,一个用户请求通常涉及多个服务之间复杂的调用。在此过程中,要找出瓶颈点或错误发生的位置非常困难。分布式追踪(Distributed Tracing)正是为解决这个问题而生的技术。
Tempo旨在大规模存储和查询这些追踪数据。
- 核心特点:
- 无索引设计: 与Loki类似,它不索引所有追踪数据,而是通过Trace ID直接查询。这使得可以在廉价的对象存储(如S3、GCS等)上存储和操作海量的追踪数据。
- 简便性: 相较于Jaeger、Zipkin等现有复杂的追踪系统,其结构非常简单,易于操作。
- 与日志、指标的联动: 在Grafana仪表盘中,可以从特定的日志或指标直接“下钻”到相关的追踪。这使得您可以立即回答诸如“记录此错误日志时,整个请求流程是怎样的?”之类的问题。🧐
4️⃣ M for Mimir: 无限扩展的Prometheus 📈
Prometheus已成为容器环境中指标收集的标准,但单个实例在长期存储和处理大规模环境中的所有指标方面存在局限性。
Mimir的诞生正是为了解决Prometheus的这些可扩展性问题。它充当一个中央存储库,汇集来自多个Prometheus服务器的指标。
- 核心特点:
- 水平扩展性: 采用微服务架构设计,当负载增加时,可以独立地横向扩展各个组件。它拥有处理数十亿时间序列数据的强大性能。💪
- 高可用性: 数据以多个副本存储,即使部分组件发生故障,也能保证服务不中断运行。
- 100% PromQL兼容: 现有Prometheus用户无需更改查询语言(PromQL)或仪表盘即可继续使用。
- 长期存储: 利用廉价的对象存储,可以将指标数据保留数年。
✨ LGTM堆栈,合力更强大!
LGTM堆栈的真正力量在于每个工具在Grafana中实现有机联动时才能发挥出来。
- 📈 在仪表盘中发现异常: 在Grafana仪表盘上发现特定服务的错误率(指标,Mimir)急剧上升。
- 📜 检查相关日志: 单击一下,即可立即过滤并查看该时间段的错误日志(Loki)。
- ⛓️ 追踪整个请求流程: 点击错误日志中记录的Trace ID,通过追踪数据(Tempo)一目了然地了解该请求经过了哪些服务,以及具体在哪个环节发生了延迟或失败。
所有这些过程只需几次点击,在一个屏幕内流畅完成。这就是LGTM堆栈提供的集成式可观测性体验。
✅ 总结
LGTM堆栈是Grafana Labs提出的现代可观测性蓝图。
- 基于开源: 无需担心厂商锁定。
- 成本效益高: 最大限度地减少索引并利用廉价的对象存储,从而降低TCO(总拥有成本)。
- 卓越的可扩展性: 能够覆盖从小型项目到面向数百万用户的大规模服务。
- 集成体验: 通过Grafana,可以在日志、指标和追踪之间无缝切换,实现真正的数据驱动调试和分析。
无论是刚刚开始引入可观测性的团队,还是正在为现有系统的复杂性和成本问题而烦恼的团队,LGTM堆栈无疑都将是最佳选择之一。为您的系统增添强大的洞察力吧!🚀
标签: Grafana, LGTM, Observability, Loki, Tempo, Mimir, Prometheus, Monitoring, MSA, DevOps, SRE
发表回复