各位开发者和DevOps工程师,大家好!在MSA(微服务架构)环境中,您是如何管理无数应用程序产生的日志、指标和追踪数据的呢?🤔 也许很多人都被海量数据所困扰,或者难以整合不同格式的数据。
为了解决这些问题,OpenTelemetry (OTel) 标准应运而生。而在OTel生态系统的核心,控制数据流动的强大组件,正是OpenTelemetry Collector。
今天,我们将深入探讨Collector是什么,特别是它如何聚合和处理数据。
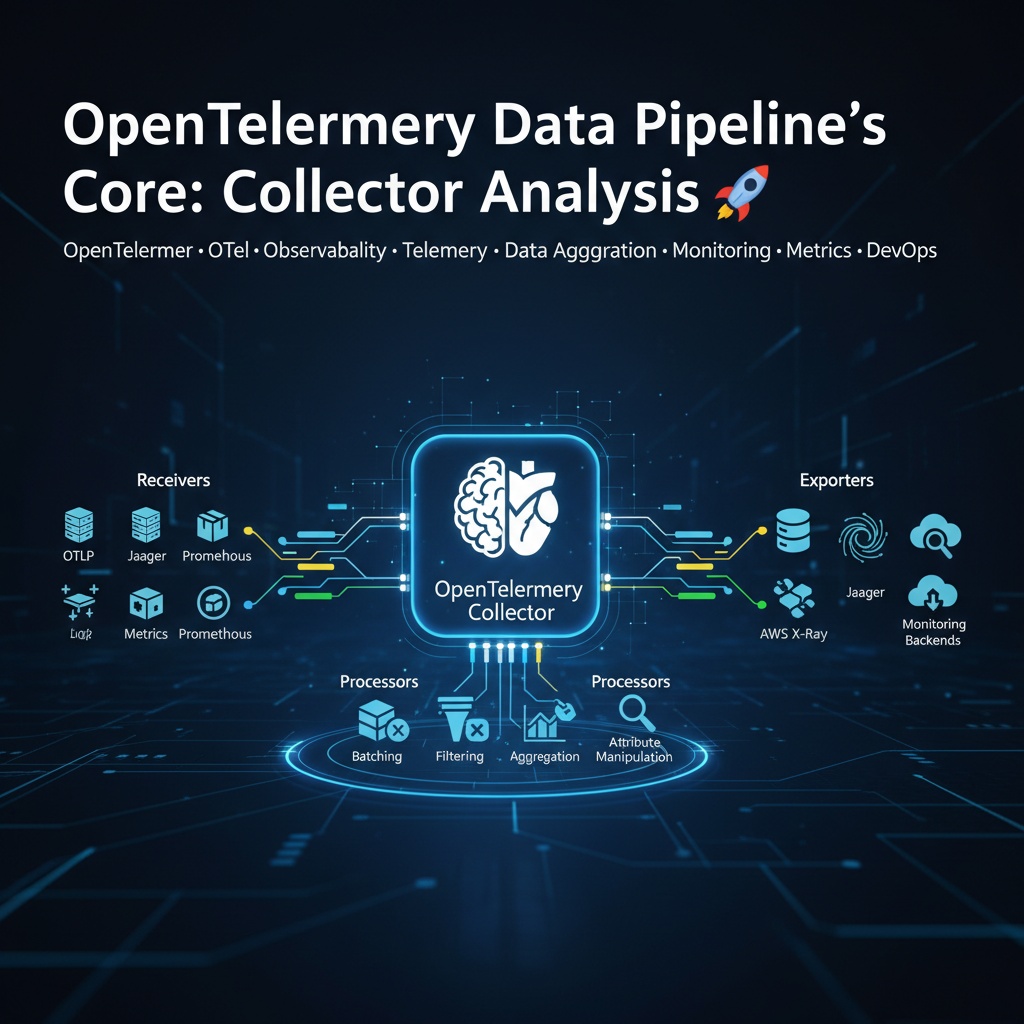
❓ 什么是OpenTelemetry Collector?
最简单的比喻是,Collector就像一个专门处理遥测数据的邮局 📫。它接收来自多个地方(应用程序)的信件(数据),进行分类(处理),然后将其投递到最终目的地(监控后端)。
Collector是一个不依赖于特定供应商的独立服务,它经历以下三个核心管道阶段:
- 接收器 (Receivers) 📥: 这是接收各种格式(OTLP、Jaeger、Prometheus等)遥测数据的部分。它定义了将使用哪种协议来接收数据。
- 处理器 (Processors) ⚙️: Collector的最强大功能就在这个阶段。它是将接收到的数据在导出之前进行加工的过程。
- 导出器 (Exporters) 📤: 将处理后的数据发送到最终的后端(Jaeger、Prometheus、AWS X-Ray等)进行存储和分析。
✨ 数据聚合和处理的魔术师:处理器
“定义数据聚合方式的组件是什么?”这个问题的核心就在于处理(Processing)阶段。Collector可以通过Processors在将数据发送到后端之前执行各种操作。
主要的处理操作包括:
- 批处理 (Batching): 不逐个发送数据,而是收集一定量或一定时间的数据后一次性发送。这可以显著减少网络开销。就像为了高效的快递配送,将货物集中起来用大卡车一次性发送一样。🚚
- 过滤 (Filtering): 移除不必要的数据。例如,用于检查系统状态的/health检查请求的追踪数据对分析意义不大,因此可以排除。📜 -> 🗑️
- 聚合 (Aggregation): 汇总多个数据点以生成新的指标。例如,每秒传入的数百个请求成功/失败指标可以聚合为“每分钟请求成功率”等有意义的指标。
- 属性操作 (Attribute Manipulation): 为数据添加额外的上下文信息。例如,为所有span添加environment: production或k8s.cluster.name: my-cluster等属性,以便后续更容易地过滤和分析数据。
📝 Collector配置文件(config.yaml)示例
让我们通过代码来看看这些过程是如何配置的。以下是一个简单的Collector配置,它通过OTLP接收数据,进行批处理,然后以控制台日志的形式输出。
# config.yaml

# 1. 定义数据接收方式。
receivers:
  otlp:
    protocols:
      grpc:
      http:

# 2. 定义如何处理数据。(核心!)
processors:
  batch:
    # 每200毫秒或当累积100个span时,将数据打包发送。
    timeout: 200ms
    send_batch_size: 100
  memory_limiter:
    # 限制Collector使用的最大内存以提高稳定性。
    check_interval: 1s
    limit_mib: 4000

# 3. 定义处理后的数据发送到哪里。
exporters:
  logging:
    # 以日志形式输出到控制台,便于调试。
    loglevel: debug

# 4. 将上述组件连接到管道中。
service:
  pipelines:
    traces: # 跟踪数据管道
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [logging]
    metrics: # 指标数据管道
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [logging]
在上述配置中,查看service.pipelines.traces部分,可以清晰地看到数据流。
otlp接收器接收到的数据 -> 经过memory_limiter和batch处理器 -> 然后发送到logging导出器组件。因此,定义数据聚合(批处理)等处理方式的主体正是Collector的配置文件。
🤔 为什么其他组件不是答案?
将Collector的角色与OpenTelemetry生态系统中的其他元素进行比较,其功能将更加清晰。
1. SDK (Software Development Kit)
- 作用: 安装在应用程序代码内部,用于
生成(instrumentation)遥测数据的库。👩💻
- 为什么不是?: SDK位于数据产生的源头。虽然可以进行简单的采样或基本的属性添加,但它不适合集中聚合来自多个服务的数据或应用复杂的路由规则。SDK的作用侧重于数据生成,而Collector则侧重于生成数据的集中处理和管理。
2. Exporters (导出组件)
- 作用: 负责将数据按照特定后端的格式进行传输。📤
- 为什么不是?: Exporter负责管道的最后一个阶段。它仅仅是扮演将数据发送到最终目的地的“快递员”角色,不包含在中间加工或聚合数据的逻辑。数据处理已在Processor阶段完成。
🌟 结论:Collector在整体上下文中的重要性
在使用OpenTelemetry构建可观测性系统时,Collector不仅仅是一个传输数据的代理。
Collector是遥测数据管道的大脑 🧠 和心脏 ❤️。
应用程序可以通过SDK专注于数据生成,将数据处理和传输的所有复杂性委托给Collector。这带来了以下好处:
- 关注点分离: 应用程序代码可以专注于业务逻辑。
- 灵活性和可扩展性: 在添加新的监控后端或更改数据处理规则时,无需重新部署应用程序,只需修改Collector配置即可。
- 性能优化: 通过批处理等方式减少网络流量,降低后端负载。
- 数据标准化: 可以将来自多个来源的数据精炼成一致的格式,然后发送到后端。
因此,如果您想定义遥测数据的聚合、过滤、增强等数据处理方式,答案就在于OpenTelemetry Collector。
发表回复