Amazon Bedrock Guardrails 是一项功能,用于对进入和离开生成式 AI 的内容应用安全策略。在这里,HIGH 的含义会根据上下文而变化。设置中的 HIGH 表示严格的检查强度,而结果中的 HIGH 则表示内容被归类为属于有害类别的置信度很高。
因此,对于“如果将过滤器设置为 HIGH,是否只阻止被检测为 HIGH 的内容?”的答案是否定的。在启用阻止操作的前提下,HIGH 强度会针对被归类为 LOW、MEDIUM 和 HIGH 置信度的有害内容。然而,提高检查强度并不意味着所有输入都会被检查,或者所有检测都会导致实际阻止。强度、操作和检查范围必须分开理解。官方过滤器强度说明
将设置和结果视为不同的问题
过滤器强度 inputStrength 和 outputStrength 是由操作员设置的值。可以为输入和响应设置不同的强度。例如,如果输入配置为 HIGH,响应配置为 MEDIUM,即使置信度同为 LOW,策略判断也可能因检查方向而异。设置 API
另一方面,执行结果中的 confidence 表示特定内容被归类为特定有害内容类别的程度。由于同一句话在不同类别中可能具有不同的置信度,因此将整个请求总结为一个值(例如“此请求的置信度为 HIGH”)会失去判断依据。必须与类别 type 一起查看。下表总结了官方文档中的关系。分类和强度
| 已配置的过滤器强度 | 目标过滤的有害置信度 | 该类别中允许的置信度 |
| — | — | — |
| NONE | 无 | NONE, LOW, MEDIUM, HIGH |
| LOW | HIGH | NONE, LOW, MEDIUM |
| MEDIUM | MEDIUM, HIGH | NONE, LOW |
| HIGH | LOW, MEDIUM, HIGH | NONE |
如果将此表中的 HIGH 解释为“只接受更高置信度的保守检测”,那么方向就反了。当设置提高到 HIGH 时,即使较低的有害置信度也会进入过滤范围。这是为了更广泛地过滤危险内容的选择。由于正常的业务语句也可能更频繁地受到影响,因此最好同时检查应允许的合成示例,而不是无条件地设置为最大值。
LOW、MEDIUM、HIGH 是 API 公开的分类值。不应仅凭这些名称推断内部概率或精确的数值边界。诸如“HIGH 表示 90% 或更高”之类的数字无法仅凭本文档和 API 字段确认。
“已检测”与“已阻止”的含义
阅读强度后,接下来阅读操作。设置中的 inputAction·outputAction 可以使用 BLOCK 或 NONE。NONE 是一种返回检测信息但不通过该过滤器进行阻止的模式。它也不同于关闭评估的 inputEnabled·outputEnabled。将仅检测和禁用评估混为一谈,可能会错过根本没有进行检查的情况。设置 API 中的 action·enabled
执行结果中的 GuardrailContentFilter 包含 type、confidence 和 action,而 detected 和 filterStrength 是可选字段。还需要区分的是,设置中使用 BLOCK,结果中使用 BLOCKED。以下 JSON 是为了解释字段作用而新创建的合成评估项,并非实际的 AWS 响应或检测性能指标。执行结果 API
{
  "type": "HATE",
  "confidence": "LOW",
  "filterStrength": "HIGH",
  "detected": true,
  "action": "BLOCKED"
}
此项解释了“分类置信度为 LOW,但符合 HIGH 强度的阻止策略”的关系。在相同条件下,如果配置的操作是 NONE,则不应仅仅因为存在置信度就记录为已阻止。实际处理必须结合服务返回的 action 和调用 API 的响应进行确认。
例如,在 Converse 中,如果 Guardrails 介入了响应,stopReason 可能会显示为 guardrail_intervened。如果启用了跟踪,则可以结合相应的评估信息来确认原因。不应仅凭一个过滤器项的 action: NONE 就断定整个请求已被允许,因为其他策略可能已介入。Converse 响应处理
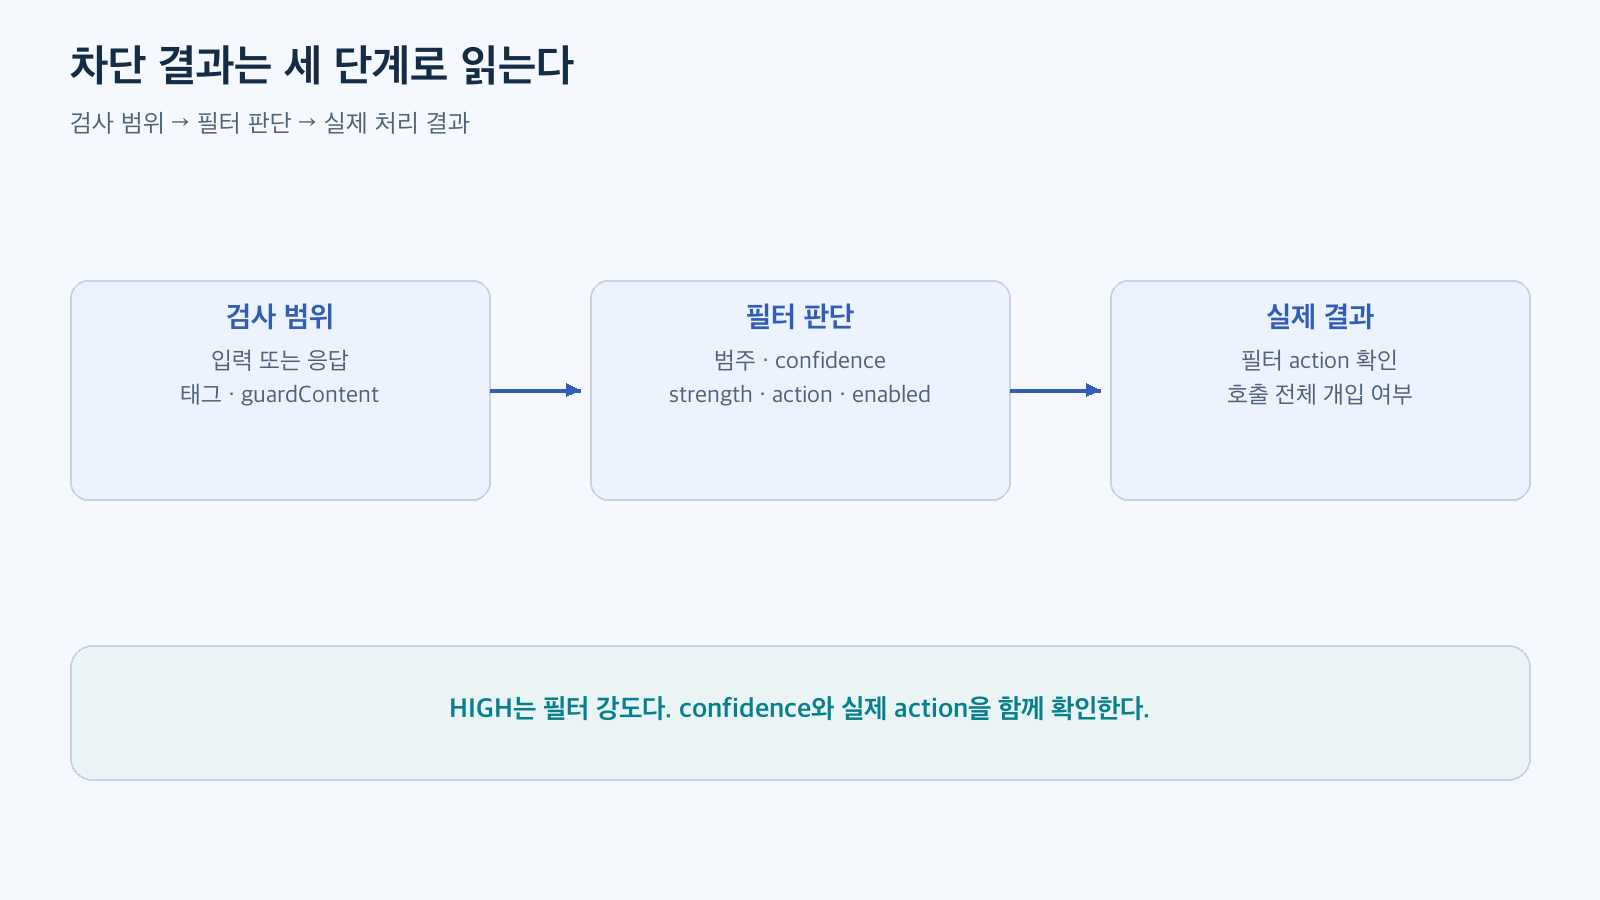
图:检查范围 → 过滤器判断 → 实际处理结果 · 根据官方文档重构
在 HIGH 之前需要确认的检查范围
PROMPT_ATTACK 是一种过滤器,用于检查试图更改开发者指令或绕过安全机制的输入。提示攻击设置是根据 inputStrength·inputAction 读取的。不应假定其与一般有害内容类别的输入/输出检查具有相同的适用范围,也不应将其视为替代附加到响应中的一般有害内容策略。
特别是在使用 InvokeModel 和 InvokeModelWithResponseStream 时,用户输入必须用 Guardrail 输入标签标记,以便提示攻击过滤器检查该部分。如果此路径中没有标签,则不会检查 PROMPT_ATTACK。这是一种区分范围的机制,以避免将开发者指令与用户攻击输入混淆。此外,官方文档明确指出,提示攻击过滤器不评估 toolResult 和 toolSpec。不能仅仅因为“附加了 Guardrails”就记录工具结果也已检查。提示攻击过滤器
输入标签的格式如下。这同样是一个虚拟输入结构,而非实际请求。
개발자 지시: 공개 문서의 내용을 설명한다.
<amazon-bedrock-guardrails-guardContent_demoA1>
가상 문서의 요점을 알려 주세요.
</amazon-bedrock-guardrails-guardContent_demoA1>
在实际请求正文中,amazon-bedrock-guardrailConfig.tagSuffix 也必须与标签的后缀匹配。示例中的 demoA1 是用于说明的固定值,在生产环境中,官方建议为每个请求使用一个难以预测的新后缀。如果使用标签,标签之外的内容将排除在检查范围之外。如果完全不使用标签,则通用 Guardrails 会处理整个输入,但前面提到的 PROMPT_ATTACK 是一个例外。输入标签使用规则
Converse 不直接使用这些 XML 标签。Guardrail 连接通过 guardrailConfig 完成,选择要检查的部分消息时使用 guardContent 块。系统消息的检查状态也必须与消息正文的检查状态分开确认。本文中的示例不涉及 contextual grounding 等限定符设置。如果同时使用其他改变检查范围的策略,也应查阅相应的策略文档。Converse 检查范围
通过本地回归测试固定策略表
将文档中的表格转换为代码,可以轻松捕获设置解释颠倒的错误。以下示例不连接到 AWS。它仅检查已分类的合成置信度与设置之间的关系,并非用于判断实际语句有害性的检测器。
import unittest

BLOCKED_CONFIDENCES = {
    "NONE": set(),
    "LOW": {"HIGH"},
    "MEDIUM": {"MEDIUM", "HIGH"},
    "HIGH": {"LOW", "MEDIUM", "HIGH"},
}

def policy_action(strength, confidence, configured_action="BLOCK"):
    # 将策略表应用于已分类的值。不重现AWS检测模型。
    if strength not in BLOCKED_CONFIDENCES:
        raise ValueError("알 수 없는 강도")
    if confidence not in {"NONE", "LOW", "MEDIUM", "HIGH"}:
        raise ValueError("알 수 없는 신뢰도")
    if configured_action not in {"BLOCK", "NONE"}:
        raise ValueError("알 수 없는 설정 동작")
    if configured_action == "NONE":
        return "NONE"
    return "BLOCKED" if confidence in BLOCKED_CONFIDENCES[strength] else "NONE"

class FilterMatrixTests(unittest.TestCase):
    def test_all_sixteen_pairs(self):
        # 每行按置信度NONE、LOW、MEDIUM、HIGH的顺序排列。
        expected = {
            "NONE": ["NONE", "NONE", "NONE", "NONE"],
            "LOW": ["NONE", "NONE", "NONE", "BLOCKED"],
            "MEDIUM": ["NONE", "NONE", "BLOCKED", "BLOCKED"],
            "HIGH": ["NONE", "BLOCKED", "BLOCKED", "BLOCKED"],
        }
        for strength, actions in expected.items():
            for confidence, action in zip(("NONE", "LOW", "MEDIUM", "HIGH"), actions):
                with self.subTest(strength=strength, confidence=confidence):
                    self.assertEqual(policy_action(strength, confidence), action)

    def test_detect_only_does_not_block(self):
        self.assertEqual(policy_action("HIGH", "HIGH", "NONE"), "NONE")

    def test_invalid_value_is_not_silently_allowed(self):
        with self.assertRaises(ValueError):
            policy_action("HIGH", "UNKNOWN")

if __name__ == "__main__":
    unittest.main()
将其保存为 test_filter_matrix.py,然后运行 python3 test_filter_matrix.py。在准备本文时,我本地验证了三个测试和 16 种强度-置信度组合。结果是“Ran 3 tests”和“OK”。这不代表 AWS API 调用、实际分类结果或付费评估的成功。
如果将此测试集成到应用程序中,请将服务响应解释代码与文档中的策略表分开维护。不要猜测响应中不存在的置信度,也不要将本地计算结果存储为实际 Guardrail 的 action。
操作中应遵循的读取顺序
当设置不产生所需结果时,请按以下顺序检查:
- 确认实际调用连接的是预期的 Guardrail 和版本。
- 检查相关类别以及输入/响应方向的 strength·action·enabled 设置。
- 确认与调用 API 匹配的标签或 guardContent 范围。
- 检查实际评估项的 type·confidence·action 以及整个调用的处理结果。
- 将正常合成示例与违反策略的合成示例分开,并比较设置更改前后。
HIGH 在强度设置中意味着过滤更广泛的有害置信度范围。最终的服务安全性不能仅凭强度来判断,而需要确认检查了什么、采取了什么操作以及应用程序如何使用结果。
发表回复