Amazon Bedrock Guardrailsは、生成AIに入力されるコンテンツと出力されるコンテンツに安全ポリシーを適用する機能です。ここで言うHIGHは、文脈によって意味が異なります。設定におけるHIGHは厳格な検査強度を意味し、結果におけるHIGHは、その有害カテゴリに属すると分類された高い信頼度を意味します。
したがって、「フィルターをHIGHに設定すると、HIGHと検出されたコンテンツだけがブロックされるのか?」という問いに対する答えは「いいえ」です。ブロックアクションを使用することを前提として、HIGH強度はLOW・MEDIUM・HIGHの信頼度で分類された有害コンテンツを対象とします。ただし、検査強度を高めたからといって、すべての入力が検査されたり、すべての検出が実際のブロックにつながるわけではありません。強度、アクション、検査範囲は個別に読み取る必要があります。公式フィルター強度説明
設定と結果を異なる質問として読み解く
フィルター強度であるinputStrengthとoutputStrengthは、オペレーターが設定する値です。入力と応答に異なる強度を設定できます。例えば、入力はHIGH、応答はMEDIUMと構成した場合、同じ信頼度LOWであっても、検査方向によってポリシー判断が異なる可能性があります。設定API
一方、実行結果のconfidenceは、特定のコンテンツが特定のカテゴリの有害コンテンツとして分類された程度を示します。同じ文章が複数のカテゴリで異なる信頼度を持つ可能性があるため、「このリクエストの信頼度はHIGH」のようにリクエスト全体を一つの値に要約すると、判断根拠を失います。カテゴリであるtypeと合わせて確認する必要があります。以下の表は、公式ドキュメントの関係をまとめたものです。分類と強度
| 設定したフィルター強度 | フィルタリング対象の有害信頼度 | 該当カテゴリで許容される信頼度 |
| — | — | — |
| NONE | なし | NONE, LOW, MEDIUM, HIGH |
| LOW | HIGH | NONE, LOW, MEDIUM |
| MEDIUM | MEDIUM, HIGH | NONE, LOW |
| HIGH | LOW, MEDIUM, HIGH | NONE |
この表のHIGHを「より高い信頼度のみを受け入れる保守的な検出」と解釈すると、方向が逆になります。設定をHIGHに上げると、低い有害信頼度までフィルタリング範囲に入ってきます。これは危険な内容をより広くフィルタリングするための選択です。通常の業務文章もより頻繁に影響を受ける可能性があるため、無条件に最大値に設定するのではなく、許容すべき合成例も一緒に検査する方が良いでしょう。
LOW・MEDIUM・HIGHはAPIが公開する分類値です。この名前だけで内部確率や正確な数値境界を推定すべきではありません。「HIGHは90%以上」のような数字は、このドキュメントとAPIフィールドだけでは確認できません。
「検出された」という言葉と「ブロックされた」という言葉
強度を読み取った後には、アクションを読み取ります。設定のinputAction・outputActionにはBLOCKまたはNONEを使用できます。NONEは、検出情報を返すものの、そのフィルターでブロックしないモードです。評価をオフにするinputEnabled・outputEnabledとも異なります。検出専用と評価無効化を一つにまとめると、検査自体が行われなかったケースを見落とします。設定APIのaction・enabled
実行結果のGuardrailContentFilterにはtype、confidence、actionがあり、detectedとfilterStrengthはオプションフィールドです。設定ではBLOCK、結果ではBLOCKEDという名前を使用するという点も区別する必要があります。次のJSONは、フィールドの役割を説明するために新しく作成された合成評価項目であり、実際のAWS応答や検出性能測定値ではありません。実行結果API
{
  "type": "HATE",
  "confidence": "LOW",
  "filterStrength": "HIGH",
  "detected": true,
  "action": "BLOCKED"
}
この項目は、「分類信頼度はLOWだが、HIGH強度のブロックポリシーに該当した」という関係を説明します。同じ条件で設定アクションがNONEであれば、信頼度があるという理由だけでブロックと記録すべきではありません。実際の処理は、サービスが返したactionと呼び出しAPIの応答を合わせて確認する必要があります。
例えば、Converseでガードレールが介入した応答は、stopReasonがguardrail_intervenedとして表示されることがあります。トレースを有効にしている場合、該当する評価情報とともに原因を確認します。一つのフィルター項目のaction: NONEだけを見て、リクエスト全体が許可されたと結論付けてはなりません。他のポリシーが介入した可能性があるからです。Converse応答処理
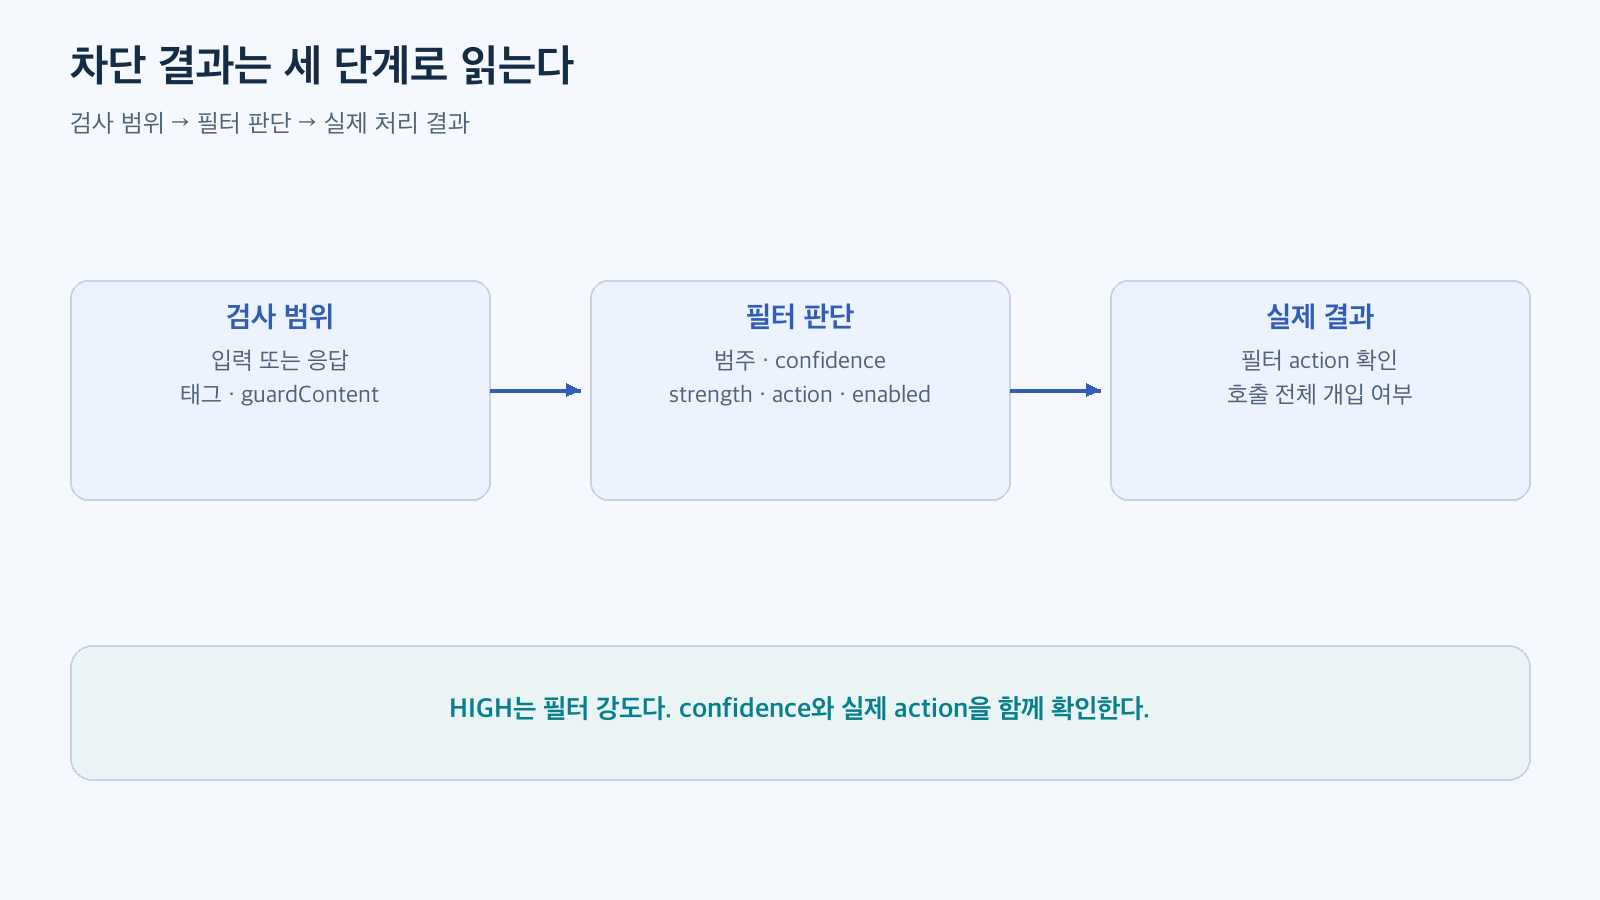
図:検査範囲 → フィルター判断 → 実際の処理結果 · 公式ドキュメントに基づいて再構成
HIGHよりも先に確認すべき検査範囲
PROMPT_ATTACKは、開発者の指示を変更したり、安全装置を回避しようとする入力を検査するフィルターです。プロンプト攻撃の設定はinputStrength・inputActionを基準に読み取ります。一般の有害コンテンツカテゴリの入出力検査と同じ適用範囲であると仮定したり、応答に付与する一般の有害コンテンツポリシーの代わりになると考えるべきではありません。
特にInvokeModelとInvokeModelWithResponseStreamを使用する際は、ユーザー入力をガードレール入力タグでマークする必要があります。そうしないと、プロンプト攻撃フィルターはその部分を検査しません。このパスでタグがない場合、PROMPT_ATTACKは検査されません。これは、開発者の指示文をユーザー攻撃入力と混同しないように範囲を区別する仕組みです。また、公式ドキュメントは、プロンプト攻撃フィルターがtoolResultとtoolSpecを評価しないと明記しています。「Guardrailsを付けた」という事実だけで、ツール結果まで検査されたと記録することはできません。プロンプト攻撃フィルター
入力タグの形式は次のとおりです。これも実際の要求ではなく、仮想的な入力構造です。
개발자 지시: 공개 문서의 내용을 설명한다.
<amazon-bedrock-guardrails-guardContent_demoA1>
가상 문서의 요점을 알려 주세요.
</amazon-bedrock-guardrails-guardContent_demoA1>実際の要求本文では、amazon-bedrock-guardrailConfig.tagSuffixもタグのサフィックスと一致させる必要があります。例のdemoA1は説明用の固定値であり、運用では要求ごとに予測しにくい新しいサフィックスを使用するという公式の推奨事項に従います。タグを使用すると、タグ外のコンテンツは検査範囲から外れます。タグを全く使用しない場合、一般的なガードレールは入力全体を処理しますが、前述のPROMPT_ATTACKは例外です。入力タグ使用規則
Converseでは、このXMLタグをそのまま持ち込みません。ガードレールの接続はguardrailConfigで行い、検査するメッセージの一部を選択する際にはguardContentブロックを使用します。システムメッセージの検査の有無も、メッセージ本文の検査の有無とは別に確認する必要があります。この記事の例では、contextual groundingなどのqualifiers設定は扱いません。検査範囲を変更する他のポリシーを併用する場合は、該当するポリシーのドキュメントも確認する必要があります。Converse検査範囲
ポリシーテーブルをローカル回帰テストで固定する
ドキュメントの表をコードに落とし込むことで、設定解釈が逆転するミスを容易に捕捉できます。次の例はAWSに接続しません。既に分類された合成信頼度と設定の関係のみを検査し、実際の文章の有害性を判定する検出器ではありません。
import unittest

BLOCKED_CONFIDENCES = {
    "NONE": set(),
    "LOW": {"HIGH"},
    "MEDIUM": {"MEDIUM", "HIGH"},
    "HIGH": {"LOW", "MEDIUM", "HIGH"},
}

def policy_action(strength, confidence, configured_action="BLOCK"):
    # 既に分類された値にポリシーテーブルを適用する。AWS検出モデルを再現するものではない。
    if strength not in BLOCKED_CONFIDENCES:
        raise ValueError("알 수 없는 강도")
    if confidence not in {"NONE", "LOW", "MEDIUM", "HIGH"}:
        raise ValueError("알 수 없는 신뢰도")
    if configured_action not in {"BLOCK", "NONE"}:
        raise ValueError("알 수 없는 설정 동작")
    if configured_action == "NONE":
        return "NONE"
    return "BLOCKED" if confidence in BLOCKED_CONFIDENCES[strength] else "NONE"

class FilterMatrixTests(unittest.TestCase):
    def test_all_sixteen_pairs(self):
        # 各行は信頼度NONE、LOW、MEDIUM、HIGHの順である。
        expected = {
            "NONE": ["NONE", "NONE", "NONE", "NONE"],
            "LOW": ["NONE", "NONE", "NONE", "BLOCKED"],
            "MEDIUM": ["NONE", "NONE", "BLOCKED", "BLOCKED"],
            "HIGH": ["NONE", "BLOCKED", "BLOCKED", "BLOCKED"],
        }
        for strength, actions in expected.items():
            for confidence, action in zip(("NONE", "LOW", "MEDIUM", "HIGH"), actions):
                with self.subTest(strength=strength, confidence=confidence):
                    self.assertEqual(policy_action(strength, confidence), action)

    def test_detect_only_does_not_block(self):
        self.assertEqual(policy_action("HIGH", "HIGH", "NONE"), "NONE")

    def test_invalid_value_is_not_silently_allowed(self):
        with self.assertRaises(ValueError):
            policy_action("HIGH", "UNKNOWN")

if __name__ == "__main__":
    unittest.main()
test_filter_matrix.pyとして保存した後、python3 test_filter_matrix.pyを実行します。この記事を準備するにあたり、3つのテストと16の強度・信頼度組み合わせをローカルで確認しました。結果は「Ran 3 tests」と「OK」でした。これはAWS API呼び出し、実際の分類結果、有料評価の成功を意味するものではありません。
このテストをアプリケーションに接続する場合、サービス応答解釈コードとドキュメントのポリシー表を区別して維持します。応答にない信頼度を推測したり、ローカル計算結果を実際のガードレールのアクションの代わりに保存したりしてはなりません。
運用で読み取るべき順序
設定が望む結果を出さない場合は、次の順序で確認します。
- 実際の呼び出しが意図したガードレールとバージョンに接続されていることを確認します。
- 該当するカテゴリと入力/応答方向のstrength・action・enabled設定を確認します。
- 呼び出しAPIに合ったタグまたはguardContentの範囲を確認します。
- 実際の評価項目のtype・confidence・actionと、呼び出し全体の処理結果を確認します。
- 正常な合成例とポリシー違反の合成例を分離し、設定変更前後を比較します。
HIGHは強度設定において、より広い有害信頼度範囲をフィルタリングするという意味です。最終的なサービス安全性は、強度一つだけでなく、何を検査したのか、どのような動作で処理したのか、アプリケーションが結果をどのように使用したのかまで確認して初めて判断できます。
コメントを残す