Presidio 是一个在文本中查找个人信息等敏感区域的工具。回归测试是一种检查,用于确认即使在更改代码或配置后,以前正确处理的示例仍然正确。如果您扩展了韩语检测功能,那么首先要固定检测到何种类型的信息以及在何处检测到,而不是仅仅“检测到了一些东西”。
仅仅安装韩语模型并传递 language=”ko” 并不能验证配置和检测质量。模型、识别器和分析引擎必须使用相同的语言,并且返回的起始和结束位置也必须与正确答案匹配。本文使用虚拟号码-AB12等练习标记来检查这种连接,而不是实际的个人信息。这不是一个衡量韩语姓名、地址、联系方式整体检测率的示例。官方多语言配置
首先匹配三处的语言设置
跟踪一个分析请求,需要检查的连接有三处:
- NLP 引擎:将 ko 输入传递给韩语模型。
- 识别器注册:应用于韩语输入的识别器已注册 supported_language=”ko”。
- AnalyzerEngine:支持语言包含 ko,并且分析请求也使用 language=”ko”。
NLP 是将句子分割成标记或查找姓名等实体的处理过程。正则表达式识别器查找特定的字符串格式。由于两者的作用不同,因此需要分别确认韩语 NLP 模型是否存在以及是否选择了韩语正则表达式识别器。即使正则表达式本身看起来与语言无关,周围的上下文词和识别器的选择也会受到语言设置的影响。按语言划分的识别器设置
spaCy 的 ko_core_news_sm 是一个用于韩语新闻文本的管道。模型名称中的 sm 表示它是小型模型系列,并不意味着保证检测所有类型的个人信息。请同时检查模型版本和 spaCy 兼容范围。本文中,Presidio Analyzer 2.2.364、spaCy 3.8.16 和 ko_core_news_sm 3.8.0 在隔离的 Python 3.12 环境中使用。spaCy 韩语模型、3.8.0 官方模型元数据
创建可重现环境
在新的实践目录中创建虚拟环境,可以在不更改现有应用程序包的情况下进行检查。以下命令会下载公共包和模型,因此需要互联网连接,但分析示例不会调用外部服务。
python3.12 -m venv .venv
.venv/bin/python -m pip install presidio-analyzer==2.2.364 spacy==3.8.16
.venv/bin/python -m spacy download ko_core_news_sm
.venv/bin/python -m pip show presidio-analyzer spacy ko-core-news-sm
模型下载命令会验证所选的模型版本。在本文的执行中,安装了 3.8.0。如果以后选择了不同的模型版本,应重新运行相同的测试,并同时记录结果和安装版本以便进行比较。如果需要保留整个环境,应将 pip freeze 结果保存为依赖文件,但不要公开包含内部存储库凭据的安装 URL。
连接韩语引擎和练习识别器
将以下内容保存为 ko_analyzer.py。DEMO_ID 是本文中创建的仅用于练习的实体类型。它不复制实际的电话号码、账号或组织标识符规则。
from presidio_analyzer import AnalyzerEngine, Pattern, PatternRecognizer, RecognizerRegistry
from presidio_analyzer.nlp_engine import SpacyNlpEngine, NerModelConfiguration
from presidio_analyzer.predefined_recognizers import SpacyRecognizer

def build_analyzer():
    # 显式连接韩语模型标签和 Presidio 实体名称。
    ner = NerModelConfiguration(
        model_to_presidio_entity_mapping={
            "PS": "PERSON", "LC": "LOCATION", "OG": "ORGANIZATION",
        },
        labels_to_ignore=["DT", "TI", "QT"],
    )
    nlp = SpacyNlpEngine(
        models=[{"lang_code": "ko", "model_name": "ko_core_news_sm"}],
        ner_model_configuration=ner,
    )
    nlp.load()
    registry = RecognizerRegistry(supported_languages=["ko"])
    registry.add_recognizer(SpacyRecognizer(supported_language="ko"))
    registry.add_recognizer(PatternRecognizer(
        name="KoreanDemoIdRecognizer",
        supported_entity="DEMO_ID",
        supported_language="ko",
        patterns=[Pattern(
            name="연습 표식",
            regex=r"가상번호-[A-Z]{2}d{2}(?![A-Za-z0-9])",
            score=0.8,
        )],
        context=["연습", "식별자"],
    ))
    return AnalyzerEngine(
        nlp_engine=nlp, registry=registry, supported_languages=["ko"],
    )
PS、LC、OG 是此韩语模型使用的实体标签。它们已映射到 Presidio 的 PERSON、LOCATION、ORGANIZATION,并排除了此示例中未使用的日期、时间、数量标签。如果模型发生变化,也需要检查标签。添加映射并不意味着姓名检测质量有所提高,而是意味着连接了不同的命名体系。模型标签、Presidio spaCy 引擎实现
练习正则表达式的末尾是 (?![A-Za-z0-9])。这是一个条件,用于防止在两位数字后紧跟英文字母或数字时发生匹配。如果省略此条件,可能会导致从“虚拟号码-AB123”中只找到前半部分的“虚拟号码-AB12”的错误。允许后面跟着韩语助词“를”。这种边界条件在检查位置的测试中比仅检查字符串类型的测试中更容易显现。
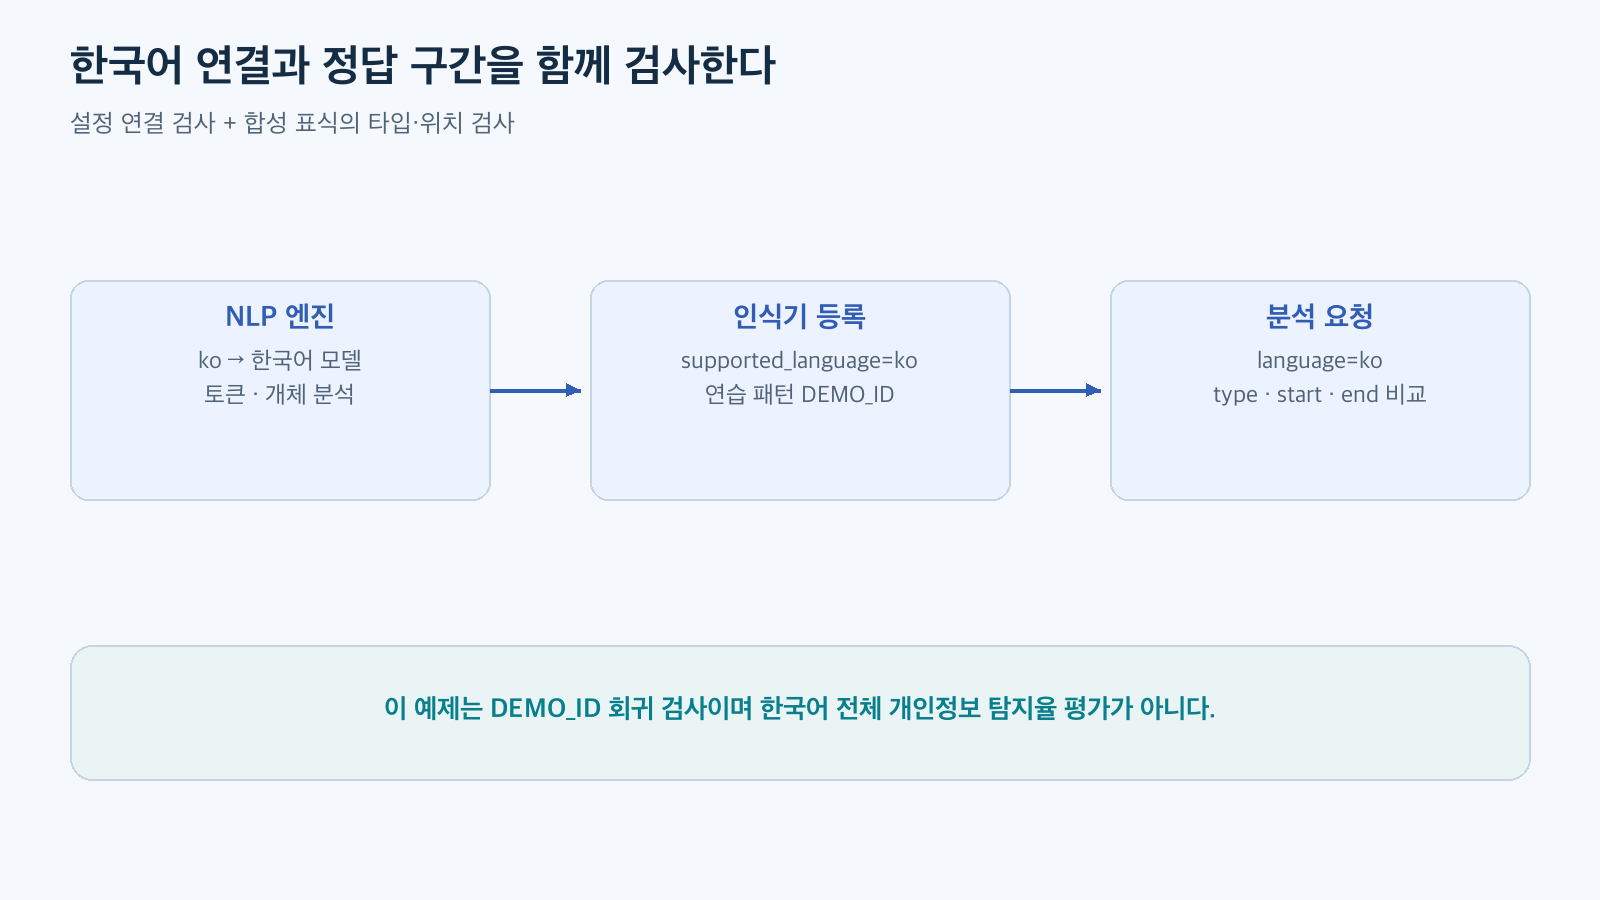
图:配置连接检查 + 合成标记的类型·位置检查 · 根据官方文档重构
同时检查实体类型和正确区域
将 test_ko_regression.py 保存到同一目录中。正确区域不会从识别器的正则表达式结果中自动生成。如果直接将结果用作正确答案,可能会导致相同的错误被计算两次,从而使测试通过。
import unittest
from ko_analyzer import build_analyzer

# end 是一个不包含最后一个字符的 Python 字符串位置。
CASES = [
    ("조사 경계", "연습 식별자 가상번호-AB12를 확인합니다.", [("DEMO_ID", 7, 16)]),
    ("기호 경계", "  가상번호-CD34!", [("DEMO_ID", 2, 11)]),
    ("형식 불일치", "연습 식별자 가상번호-AB123", []),
    ("탐지 대상 없음", "식별자는 다음 문서에 설명되어 있습니다.", []),
]

class KoreanRegressionTests(unittest.TestCase):
    @classmethod
    def setUpClass(cls):
        cls.analyzer = build_analyzer()

    def test_language_model_and_recognizers_are_connected(self):
        self.assertEqual(set(self.analyzer.supported_languages), {"ko"})
        self.assertEqual(set(self.analyzer.nlp_engine.get_supported_languages()), {"ko"})
        active = self.analyzer.registry.get_recognizers(
            language="ko", entities=["DEMO_ID"],
        )
        self.assertTrue(any(r.name == "KoreanDemoIdRecognizer" for r in active))
        self.assertEqual(self.analyzer.nlp_engine.nlp["ko"].lang, "ko")

    def test_exact_type_and_span(self):
        for name, text, expected in CASES:
            with self.subTest(case=name):
                found = self.analyzer.analyze(
                    text=text, language="ko", entities=["DEMO_ID"],
                    score_threshold=0.5, return_decision_process=True,
                )
                actual = sorted((r.entity_type, r.start, r.end) for r in found)
                self.assertEqual(actual, expected)
                for result in found:
                    self.assertTrue(text[result.start:result.end].startswith("가상번호-"))
                    self.assertIsNotNone(result.analysis_explanation)

    def test_wrong_language_fails(self):
        with self.assertRaises(ValueError):
            self.analyzer.analyze(
                text="가상번호-AB12", language="en", entities=["DEMO_ID"],
            )

if __name__ == "__main__":
    unittest.main()
start 和 end 在此 Python 示例中是字符串的字符位置,而不是 UTF-8 字节位置。请确认 text[start:end] 截取出的标记是否准确。前面带有表情符号的示例揭示了仅包含韩语/英语的示例容易忽略的字节/字符混淆。如果将结果发送给其他语言的客户端,还需要单独检查字符串索引系统是否一致。
entities=[“DEMO_ID”] 缩小了本次测试的范围。即使注册了 SpacyRecognizer,此分析也不会测量 PERSON 检测质量。它仅验证 NLP 模型是否实际加载、韩语识别器是否被选中以及练习标记的正确区域是否得到维护。
阅读执行结果和失败原因
执行命令如下:
.venv/bin/python -m unittest -v test_ko_regression.py此代码在上述版本的隔离环境中执行。所有三个测试均通过,输出为“Ran 3 tests”和“OK”。其中包含四个合成句子和对错误语言请求的检查。这些结果并非使用实际个人信息或实际业务文档。
如果连接检查失败,请首先检查支持的语言和已注册的识别器。如果模型加载失败,请检查模型安装情况和 spaCy 兼容版本。如果类型正确但区域检查失败,请查看正则表达式边界、输入预处理和字符索引。降低阈值并非解决这三个问题的通用方法。
return_decision_process=True 有助于确认是哪个识别器和模式产生了相应的结果。但是,决策过程是对已找到项的说明,并不能自动解释所有未找到的原因。仅在合成示例中查看详细说明,并且不公开实际输入的原始文本或跟踪日志。决策过程说明
将小型测试扩展到实际质量检查
如果这四个句子通过,接下来应增加正常句子、分隔符变化、助词和空格变化、重叠检测区域等。姓名、地址等基于模型的项目应使用单独的合成正确答案进行检查。重复增加一个符合正则表达式的句子无助于发现各种遗漏。
将正确答案和预测结果作为实体类型、起始、结束的相同元组进行比较,可以根据精确区域标准计算 TP、FP、FN。在此基础上,精确率(precision)计算为检测到的项中正确答案的比例,召回率(recall)计算为正确答案中找到的项的比例。要比较结果,必须首先确定区域略有不同是否算作失败,或者重叠区域是否算作部分正确答案。不要将不同标准的得分归为相同的检测率。官方评估指南
最小回归测试的价值不在于认证韩语整体处理得很好。它在于以可执行的形式记录需要维护哪些设置和哪些合成示例。即使通过自动检测的文本也不能保证其在再识别可能性或客户归属内容方面的安全性,因此在公开发布之前,应单独保留人工审查意义和上下文的阶段。
发表回复