Presidioは、テキスト内の個人情報のような機密性の高い部分を検出するツールです。回帰テストは、コードや設定を変更した後でも、以前に正しく処理されていた例が引き続き正しいことを確認する検査です。韓国語検出を拡張した場合、「何かが見つかった」というよりも、まずどのような種類がどの位置で見つかったかを固定することが重要です。
韓国語モデルをインストールし、language=”ko”を渡すだけでは、設定と検出品質の両方が検証されるわけではありません。モデル、認識器、分析エンジンが同じ言語を使用している必要があり、返された開始・終了位置も正解と一致している必要があります。この記事では、実際の個人情報ではなく、仮想番号-AB12のような練習用のマーカーを使用してその接続を検査します。韓国語の名前・住所・連絡先全般の検出率を測定する例ではありません。公式多言語設定
まず、3箇所の言語設定を合わせる
1つの分析リクエストを追跡すると、確認すべき接続は3箇所です。
- NLPエンジン: ko入力を韓国語モデルに渡します。
- 認識器登録: 韓国語入力に適用する認識器がsupported_language=”ko”で登録されています。
- AnalyzerEngine: サポート言語にkoが含まれ、分析リクエストもlanguage=”ko”を使用します。
NLPは、文をトークンに分割したり、名前のようなエンティティを検出する処理です。正規表現認識器は、特定の文字列形式を検出します。両者は役割が異なるため、韓国語NLPモデルが存在するという事実と、韓国語正規表現認識器が選択されたという事実を個別に確認する必要があります。正規表現自体は言語に依存しないように見えても、周囲の文脈単語と認識器の選択は言語設定の影響を受けます。言語別認識器設定
spaCyのko_core_news_smは、韓国語ニューステキスト用のパイプラインです。モデル名のsmは小さなモデル系列を意味し、個人情報のあらゆる種類の検出を保証するものではありません。モデルバージョンとspaCyの互換範囲を合わせて確認します。この記事では、Presidio Analyzer 2.2.364、spaCy 3.8.16、ko_core_news_sm 3.8.0を隔離されたPython 3.12環境で使用しました。spaCy韓国語モデル、3.8.0公式モデルメタデータ
再現環境の作成
新しい実習ディレクトリで仮想環境を作成すると、既存のアプリケーションのパッケージを変更せずに検査できます。次のコマンドは公開パッケージとモデルをダウンロードするためインターネット接続が必要ですが、分析例は外部サービスを呼び出しません。
python3.12 -m venv .venv
.venv/bin/python -m pip install presidio-analyzer==2.2.364 spacy==3.8.16
.venv/bin/python -m spacy download ko_core_news_sm
.venv/bin/python -m pip show presidio-analyzer spacy ko-core-news-sm
モデルダウンロードコマンドは、選択されたモデルバージョンを確認します。この記事の実行では3.8.0がインストールされました。後で別のモデルバージョンが選択された場合は、同じテストを再実行し、結果とインストールバージョンを一緒に残すことで比較が可能になります。環境全体を保存する必要がある場合は、pip freezeの結果を依存関係ファイルとして保存しますが、社内リポジトリの認証情報が含まれるインストールURLは公開しません。
韓国語エンジンと練習認識器の接続
次の内容をko_analyzer.pyとして保存します。DEMO_IDは、この記事で作成した練習専用のエンティティ種類です。実際の電話番号・口座番号・組織識別子ルールを複製するものではありません。
from presidio_analyzer import AnalyzerEngine, Pattern, PatternRecognizer, RecognizerRegistry
from presidio_analyzer.nlp_engine import SpacyNlpEngine, NerModelConfiguration
from presidio_analyzer.predefined_recognizers import SpacyRecognizer

def build_analyzer():
    # 韓国語モデルのラベルとPresidioエンティティ名を明示的にリンクする。
    ner = NerModelConfiguration(
        model_to_presidio_entity_mapping={
            "PS": "PERSON", "LC": "LOCATION", "OG": "ORGANIZATION",
        },
        labels_to_ignore=["DT", "TI", "QT"],
    )
    nlp = SpacyNlpEngine(
        models=[{"lang_code": "ko", "model_name": "ko_core_news_sm"}],
        ner_model_configuration=ner,
    )
    nlp.load()
    registry = RecognizerRegistry(supported_languages=["ko"])
    registry.add_recognizer(SpacyRecognizer(supported_language="ko"))
    registry.add_recognizer(PatternRecognizer(
        name="KoreanDemoIdRecognizer",
        supported_entity="DEMO_ID",
        supported_language="ko",
        patterns=[Pattern(
            name="연습 표식",
            regex=r"가상번호-[A-Z]{2}d{2}(?![A-Za-z0-9])",
            score=0.8,
        )],
        context=["연습", "식별자"],
    ))
    return AnalyzerEngine(
        nlp_engine=nlp, registry=registry, supported_languages=["ko"],
)PS・LC・OGは、この韓国語モデルが使用するエンティティラベルです。PresidioのPERSON・LOCATION・ORGANIZATIONにマッピングされており、この例で使用しない日付・時間・数量ラベルは除外しました。モデルが変更された場合は、ラベルも確認する必要があります。マッピングを追加したからといって、名前検出の品質が向上したわけではありません。異なる名前体系を接続したという意味です。モデルラベル、Presidio spaCyエンジン実装
練習正規表現の末尾には(?![A-Za-z0-9])があります。これは、2桁の数字の後に英数字が続く場合に一致しないようにする条件です。これを省略すると、仮想番号-AB123から前半の仮想番号-AB12だけを検出するエラーが発生する可能性があります。後ろに続く韓国語の助詞「を」は許可します。このような境界条件は、文字列の種類だけを確認する検査よりも、位置を確認する検査でより明確になります。
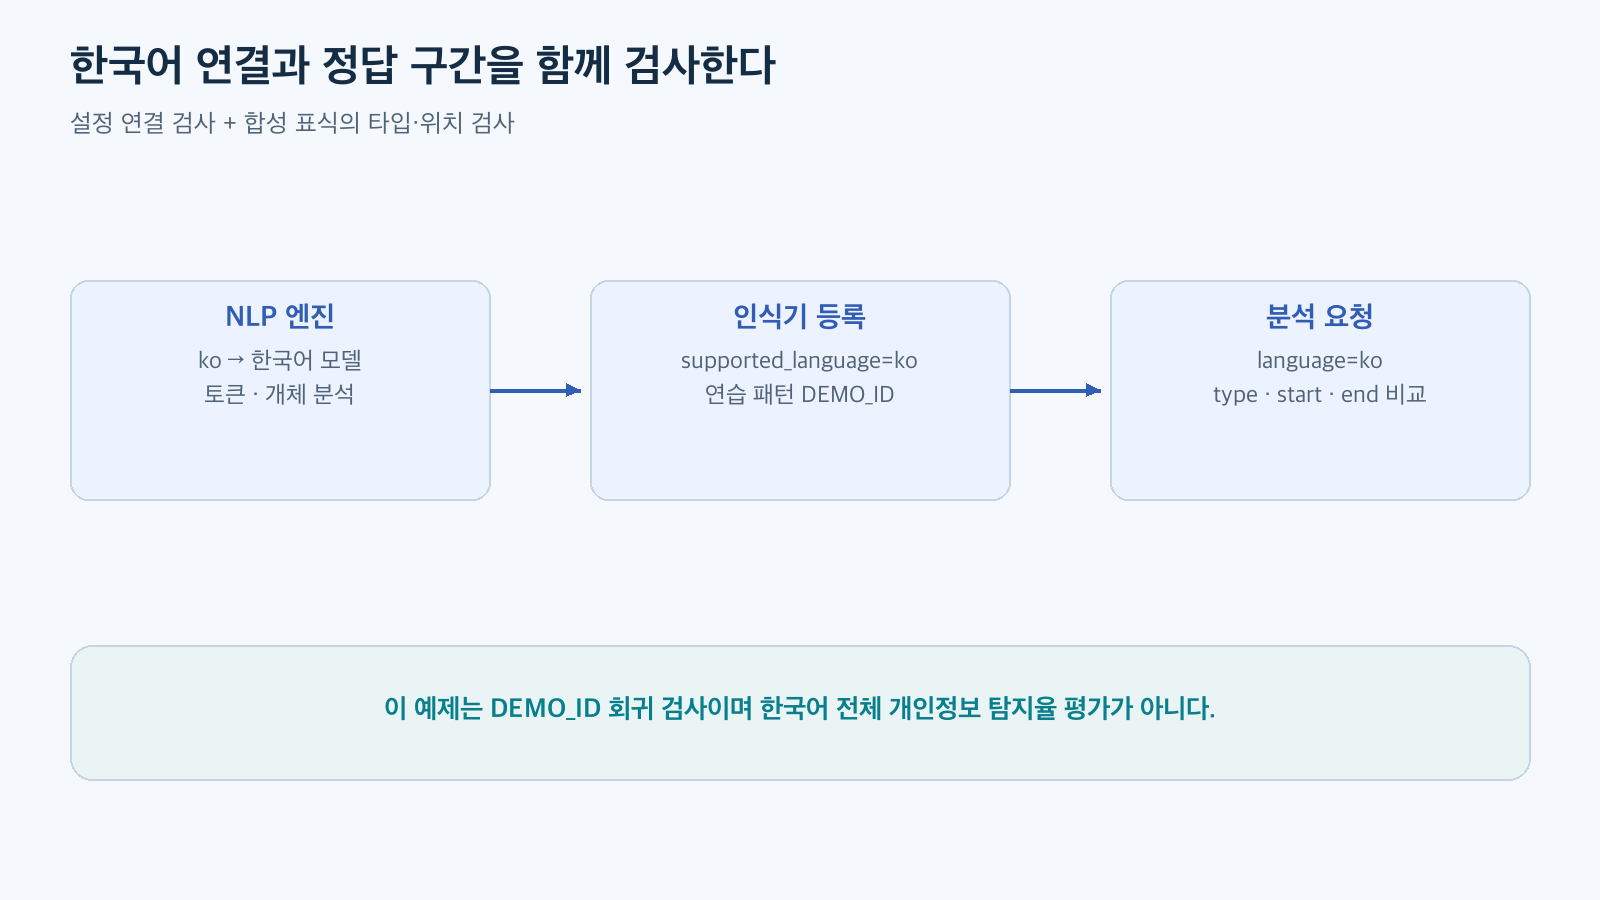
図: 設定接続検査 + 合成マーカーのタイプ・位置検査 · 公式ドキュメントに基づいて再構成
エンティティの種類と正解区間を一緒に検査する
同じディレクトリにtest_ko_regression.pyを保存します。正解区間は認識器の正規表現結果から自動生成しません。結果をそのまま正解として使用すると、同じバグを2回計算してテストがパスしてしまう可能性があるためです。
import unittest
from ko_analyzer import build_analyzer

# endは最後の文字を含まないPython文字列の位置です。
CASES = [
    ("조사 경계", "연습 식별자 가상번호-AB12를 확인합니다.", [("DEMO_ID", 7, 16)]),
    ("기호 경계", "  가상번호-CD34!", [("DEMO_ID", 2, 11)]),
    ("형식 불일치", "연습 식별자 가상번호-AB123", []),
    ("탐지 대상 없음", "식별자는 다음 문서에 설명되어 있습니다.", []),
]

class KoreanRegressionTests(unittest.TestCase):
    @classmethod
    def setUpClass(cls):
        cls.analyzer = build_analyzer()

    def test_language_model_and_recognizers_are_connected(self):
        self.assertEqual(set(self.analyzer.supported_languages), {"ko"})
        self.assertEqual(set(self.analyzer.nlp_engine.get_supported_languages()), {"ko"})
        active = self.analyzer.registry.get_recognizers(
            language="ko", entities=["DEMO_ID"],
        )
        self.assertTrue(any(r.name == "KoreanDemoIdRecognizer" for r in active))
        self.assertEqual(self.analyzer.nlp_engine.nlp["ko"].lang, "ko")

    def test_exact_type_and_span(self):
        for name, text, expected in CASES:
            with self.subTest(case=name):
                found = self.analyzer.analyze(
                    text=text, language="ko", entities=["DEMO_ID"],
                    score_threshold=0.5, return_decision_process=True,
                )
                actual = sorted((r.entity_type, r.start, r.end) for r in found)
                self.assertEqual(actual, expected)
                for result in found:
                    self.assertTrue(text[result.start:result.end].startswith("가상번호-"))
                    self.assertIsNotNone(result.analysis_explanation)

    def test_wrong_language_fails(self):
        with self.assertRaises(ValueError):
            self.analyzer.analyze(
                text="가상번호-AB12", language="en", entities=["DEMO_ID"],
            )

if __name__ == "__main__":
    unittest.main()
startとendは、このPythonの例では文字列の文字位置です。UTF-8バイト位置ではありません。text[start:end]で切り出したときに正確なマーカーが得られるかを確認します。絵文字が前にある例は、ハングル・英字のみの例では見落としがちなバイト/文字の混同を明らかにします。他の言語のクライアントに結果を送信する場合は、文字列インデックス体系が同じであるかどうかも別途検査する必要があります。
entities=[“DEMO_ID”]は、このテストの範囲を狭めます。SpacyRecognizerが登録されていても、この分析ではPERSON検出品質を測定しません。NLPモデルが実際にロードされ、韓国語認識器が選択され、練習マーカーの正解区間が維持されるかのみを検証します。
実行結果と失敗原因の読み方
実行コマンドは次のとおりです。
.venv/bin/python -m unittest -v test_ko_regression.py上記のバージョンの隔離環境でこのコードを実行しました。3つのテストすべてがパスし、出力は「Ran 3 tests」と「OK」でした。その中には、4つの合成文と不正な言語リクエストの検査が含まれます。実際の個人情報や実際の業務文書を使用した結果ではありません。
接続検査が失敗した場合は、まずサポート言語と登録された認識器を確認します。モデルのロードが失敗した場合は、モデルのインストール状況とspaCyの互換バージョンを確認します。タイプは正しいが区間検査が失敗した場合は、正規表現の境界、入力前処理、文字インデックスから確認します。しきい値を下げることは、これら3つの問題を解決する共通の処方箋ではありません。
return_decision_process=Trueは、どの認識器とパターンがその結果を作成したかを確認するのに役立ちます。しかし、決定プロセスは検出された項目の説明であり、検出できなかった理由を自動的にすべて説明するわけではありません。合成例でのみ詳細な説明を確認し、実際の入力の原文や追跡ログを公開しないようにします。決定プロセス説明
小さなテストを実際の品質検査に拡張する
これらの4つの文がパスしたら、次に、通常の文、区切り文字の変化、助詞と空白の変化、重複する検出区間などを増やします。名前・住所のようなモデルベースの項目は、別途合成正解で検査します。正規表現に一致する1つの文だけを繰り返し増やすことは、さまざまな見落としを見つけるのに役立ちません。
正解と予測をエンティティ種類・開始・終了の同一のタプルで比較すると、正確な区間基準のTP・FP・FNを数えることができます。これに基づいて、precisionは検出されたものの中の正解の割合、recallは正解の中の検出された割合として計算されます。区間が少しでも異なる場合に失敗と見なすか、重複する場合に部分正解と見なすかをまず決めることで、結果を比較できます。異なる基準のスコアを同じ検出率としてまとめないでください。公式評価ガイドライン
最小回帰テストの価値は、韓国語全体をうまく処理するという認証にあるのではありません。どのような設定とどのような合成例で何を維持すべきかを実行可能な形で残すことにあります。自動検出を通過したテキストも、再識別可能性や顧客帰属内容まで安全になったと保証することはできないため、公開前に意味と文脈を人が確認する段階は別途維持します。
コメントを残す