Amazon Bedrock(亚马逊 Bedrock)是一项完全托管的生成式AI服务,它允许您在AWS中通过API选择和使用来自多家公司的基础模型。简而言之,您无需直接购买GPU服务器、下载模型和运营推理服务器,而是向所需的模型发送请求并按使用量付费。
在这里,我们必须首先澄清一个最重要的误解。Bedrock并非不使用GPU。在模型背后,GPU或AWS的AI加速器可能正在运行。但是,用户无需选择EC2 GPU实例、匹配CUDA和驱动程序、部署模型以及运营自动扩缩。这并非消除了GPU,而是将GPU的运营转移到了AWS的托管领域。
本文将一次性整理Bedrock的背景和历史、模型种类、请求流程、成本、安全性、RAG和代理、与SageMaker AI的区别以及实际的引入标准。
1. Bedrock为何出现?
直接运营生成式AI应用程序需要比想象中更多的工作。您需要 확보 GPU实例、存储模型权重、匹配推理框架和驱动程序版本,并根据流量增加副本。更改模型时,还需要重新审查输入格式和运营方式。
反之,如果直接使用外部模型公司的API,启动速度会很快,但仍需将AWS的IAM权限、CloudTrail审计、网络边界和现有应用程序运营体系进行集成。在比较或更换多个模型时,不同提供商之间的API差异也会变得很大。
Bedrock的出现正是为了弥补这两者之间的差距。AWS于2023年4月首次发布Bedrock,并于2023年9月28日正式推出。当时的核心是提供来自Amazon以及Anthropic、AI21 Labs、Cohere、Stability AI等多个提供商的模型,全部在一个完全托管的服务中。 AWS Bedrock正式发布公告
此后,Bedrock从一个简单的“模型调用API”扩展成为一个生成式AI应用程序平台。
- 2023年:Bedrock正式发布,扩展了Agents和Knowledge Bases等应用程序功能
- 2024年4月:Guardrails和Model Evaluation正式发布
- 2024年12月:发布Amazon Nova模型系列和连接100多个专业模型的Bedrock Marketplace
- 2025年以后:扩展多模态Guardrails、自动推理检查、模型选择·评估·定制以及包括AgentCore在内的代理运营功能
这段历史很好地展示了Bedrock的本质。最初,它是一个“通过无服务器API调用多个模型的服务”,而现在,它更像是一个将模型、数据、安全防护、评估和代理运营捆绑在AWS权限和审计体系内的平台。 Guardrails正式发布, Amazon Nova发布, Bedrock Marketplace发布
2. “无需GPU使用”的准确含义
Bedrock的无服务器并非指像Lambda那样执行代码,而是指用户无需直接预置模型推理所需的基础设施。应用程序调用HTTPS API,AWS负责后端的容量分配和扩展。
与直接托管相比,省去的工作显而易见。
| 类别 | 直接GPU托管 | Bedrock托管推理 |
| — | — | — |
| 计算选择 | 决定GPU类型、数量、显存 | 选择模型和推理方式 |
| 软件 | 管理驱动程序、CUDA、推理服务器 | 使用API和SDK |
| 部署 | 部署和复制模型权重 | 指定模型ID或推理配置文件 |
| 扩展 | 直接设计副本、批处理、队列 | AWS管理按需容量 |
| 成本单位 | 主要基于实例运行时间 | 按模型输入/输出令牌、图像、秒等 |
| 精细控制 | 控制量化、运行时、甚至GPU | 在提供的模型、区域和功能范围内选择 |
这一优势在PoC和可变流量方面尤为突出。对于每天只调用几次的内部摘要工具,无需24小时开启GPU。在短期评估多个模型时,也无需为每个模型创建单独的推理服务器。
然而,无服务器并不意味着无限。账户和模型配额、每分钟吞吐量、区域可用性以及临时限流仍然需要考虑。如果需要可预测的专用吞吐量,可以选择按小时固定费用的预置吞吐量(Provisioned Throughput)。 Bedrock预置吞吐量文档
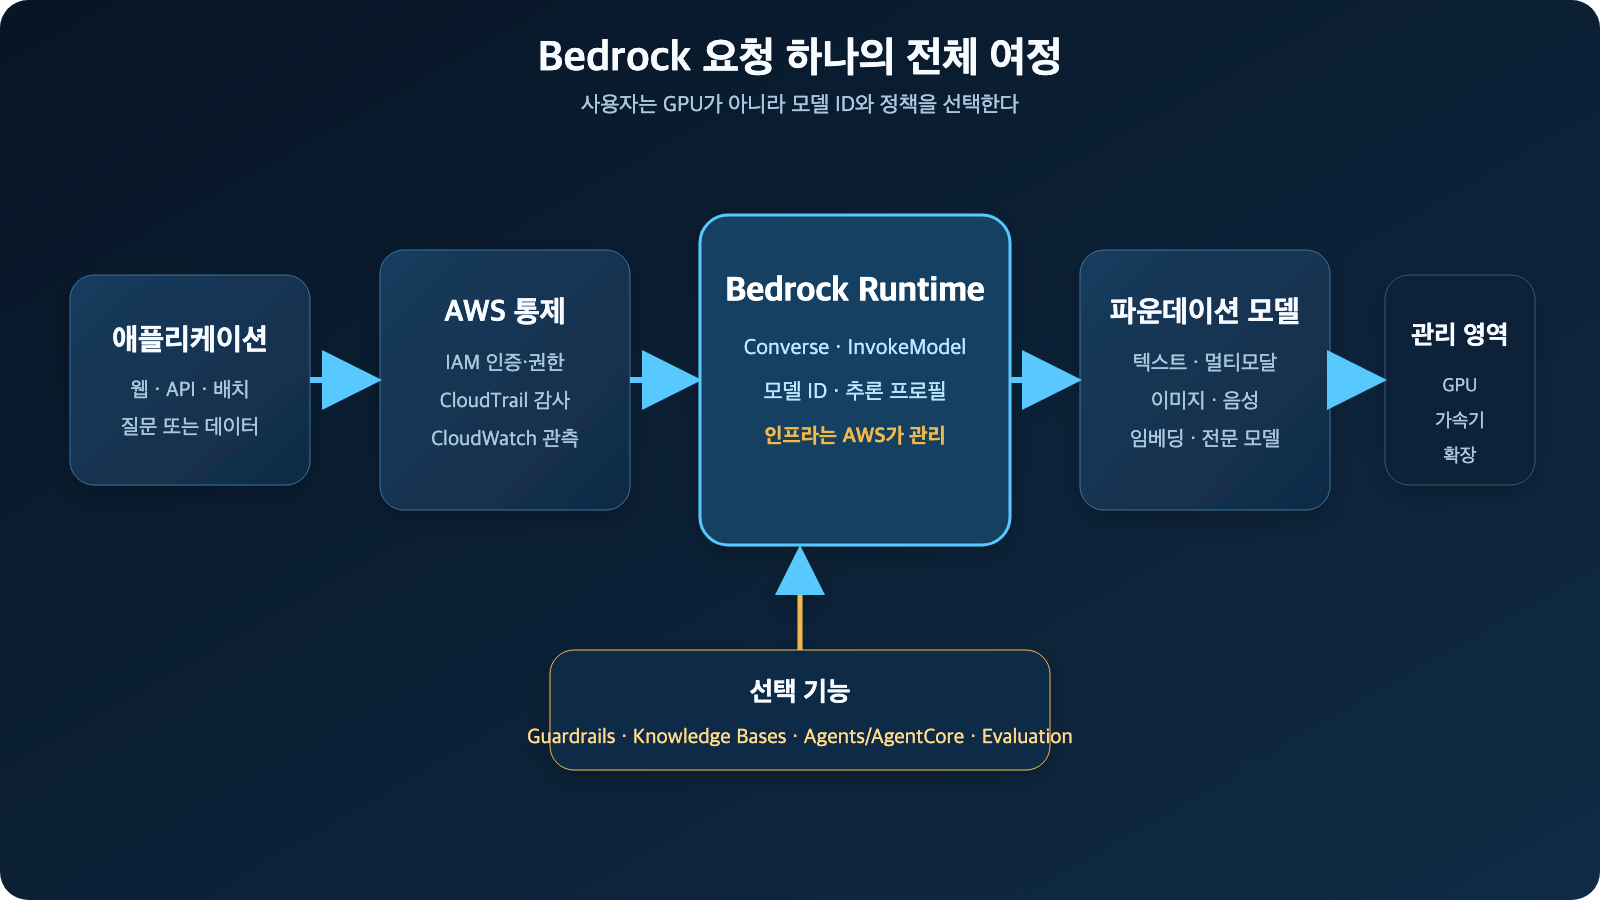
图1. Bedrock的请求路径。GPU和推理服务器并未消失,而是在AWS的托管领域背后。AWS Bedrock正式发布说明和Bedrock API文档重构。
3. 单个请求的处理顺序
理解Bedrock最快的方法是跟踪一个请求。
- 用户在网页或业务系统中输入问题。
- 应用程序使用IAM角色或AWS凭证调用Bedrock Runtime API。
- 如有必要,Guardrails会检查输入中是否存在禁止主题、有害内容、提示攻击和个人信息。
- 如果应用程序使用Knowledge Bases,它会搜索与问题相关的内部文档以创建上下文。
- 指定的模型或推理配置文件处理输入。
- 如果应用了Guardrails,模型输出也会再次被检查或敏感信息被屏蔽。
- 应用程序接收结果和使用信息,显示给用户,并记录必要的指标和审计事件。
Bedrock Runtime有不同目的的API。Converse为支持消息的模型提供通用的对话接口,使得模型切换更容易。InvokeModel用于更直接地控制模型特有的格式和功能,包括图像和嵌入。最新的Bedrock还提供与OpenAI兼容的Responses·Chat Completions API和Anthropic Messages API,但并非所有端点和模型都支持相同的功能,因此需要查看兼容性表。 Bedrock支持的API, Bedrock模型目录, Bedrock价格表中的提供商列表
在实际操作中,按输入和输出类型划分比按公司名称划分更容易理解。
| 模型类型 | 功能 | 典型应用 |
| — | — | — |
| 文本·推理 | 问答、摘要、分类、代码、工具调用 | 聊天机器人、文档处理、业务自动化 |
| 多模态理解 | 理解文本、图像、文档、视频 | 图纸分析、收据处理、视频查询 |
| 图像生成·编辑 | 从文本生成图像、图像修复·超分辨率 | 营销素材、设计辅助 |
| 语音·实时 | 语音输入和输出、对话式流媒体 | 呼叫中心、语音助手 |
| 嵌入 | 将句子·图像转换为可搜索的向量 | 语义搜索、RAG、推荐 |
| 重排序 | 重新排列搜索结果的相关性 | 提高RAG搜索质量 |
| 视频·专业模型 | 视频生成·搜索、特定行业任务 | 媒体制作、专业分析 |
仅Amazon自家的Nova系列就包括专注于成本和延迟的文本模型、多模态理解、图像生成、视频生成、语音对话和嵌入模型。如果再加上其他提供商的模型,选择范围将更加广泛。
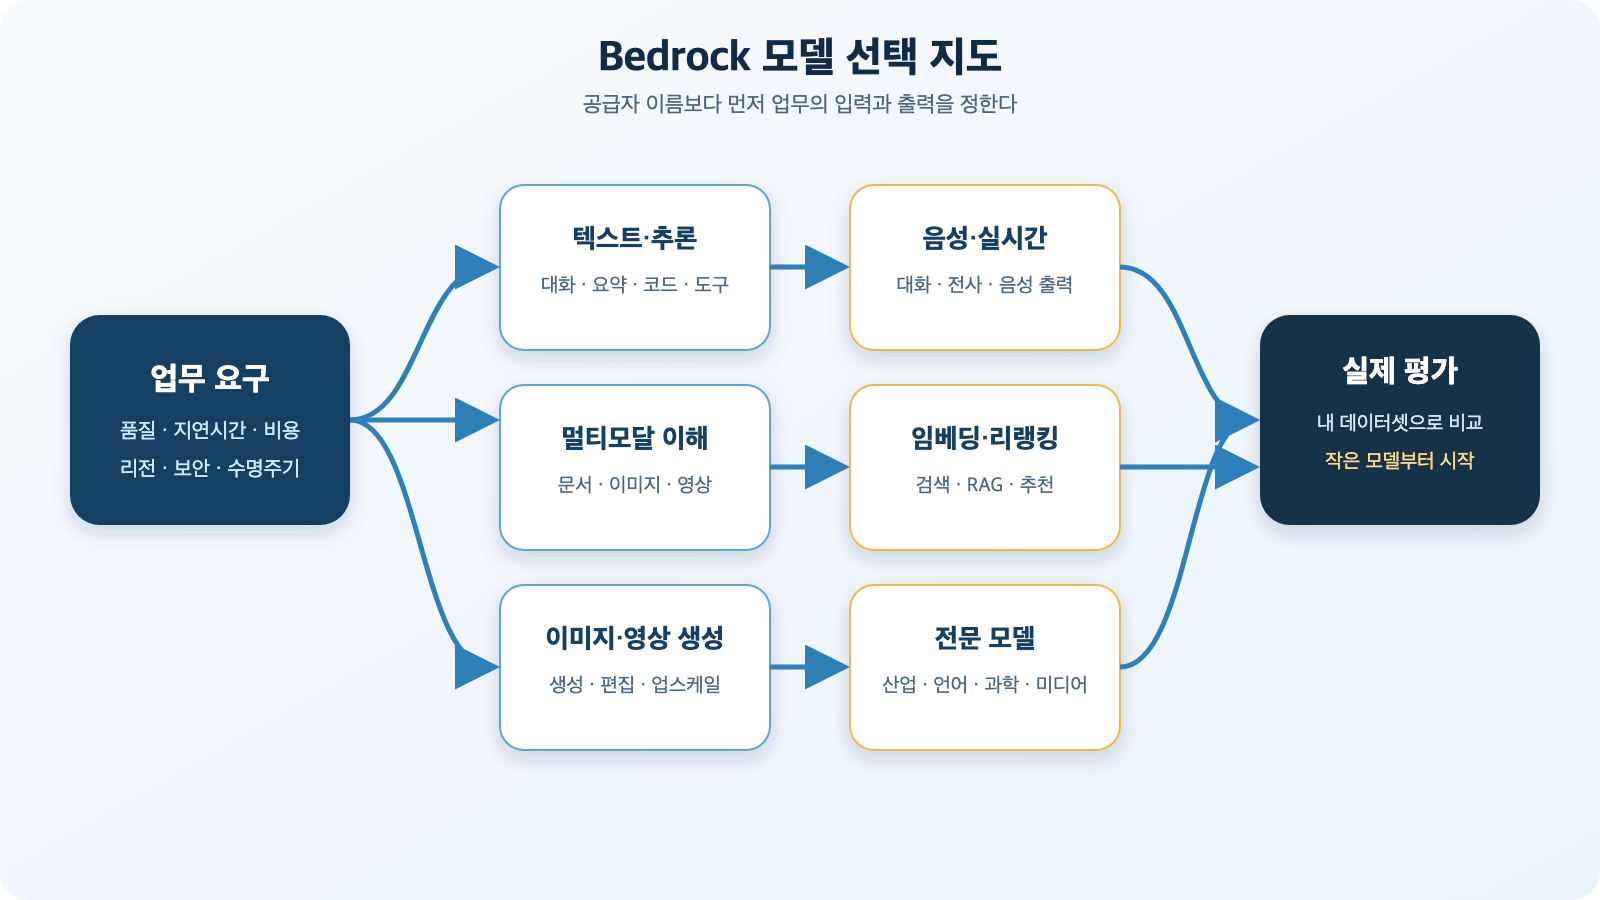
图2. 优先选择输入/输出形式和业务目标,而非模型提供商。AWS Models at a glance重构。
模型选择并非寻找基准测试第一名
最大的模型并非总是最佳选择。您需要使用实际数据集同时衡量以下各项:
- 质量:准确率、忠实度、工具调用成功率、中文质量
- 延迟:首个令牌时间和总响应时间
- 成本:输入·输出令牌、缓存、Guardrails、搜索成本
- 上下文:所需文档长度和多模态输入支持
- 可操作性:所需区域、按需可用性、配额、流式传输支持
- 生命周期:Active·Legacy·EOL状态和迁移计划
Bedrock模型以Active、Legacy和End-of-Life状态进行管理。AWS文档规定,模型从Bedrock发布到EOL至少有12个月,但如果变为Legacy,可能需要限制新使用并制定迁移计划。在运营代码中将模型ID作为配置分离并自动化回归评估更为安全。 Bedrock模型生命周期
您可以通过CLI查看当前账户和区域中实际可用的基础模型。
aws bedrock list-foundation-models
  --region us-east-1
  --query 'modelSummaries[].{provider:providerName,name:modelName,id:modelId,status:modelLifecycle.status}'
  --output table
此结果比博客或旧示例中的模型列表更准确。即使是相同的模型,其区域、推理方式和功能支持也可能不同。 Bedrock模型查询方法
5. Bedrock在模型周边提供什么?
Bedrock的实际价值不仅在于模型调用,更在于其周边功能。
Knowledge Bases:连接内部文档的托管RAG
RAG(Retrieval-Augmented Generation)是一种方法,它首先查找与问题相关的内部文档,然后将其内容附加到模型输入中,以增强答案的依据。Knowledge Bases连接了文档收集、分割、嵌入生成、向量搜索和模型调用。
此功能减轻了RAG的组装负担,但不能自动保证准确性。分块方式、元数据过滤器、嵌入和重排序器、访问控制、依据评估都需要通过实际数据进行验证。
Guardrails:模型之外的通用安全策略
Guardrails检查用户输入和模型响应。您可以组合内容过滤器、禁止主题、单词过滤器、敏感信息、图像过滤器等策略,并将其应用于模型推理、Knowledge Bases、代理和Flow。如果输入被阻止,模型调用本身可能不会执行;如果输出违反策略,它将被替换为阻止消息或屏蔽结果。 Bedrock Guardrails工作方式
Guardrails不能替代整个安全边界。IAM权限、工具特定批准、数据访问控制、输出验证和人工干预(Human-in-the-Loop)是单独需要的。
Agents和AgentCore:让模型使用工具
代理(Agents)使模型不仅限于回答问题,还能选择API或Lambda等工具来执行任务。现有的Agents for Amazon Bedrock提供任务编排的托管服务,最新的AWS文档推荐AgentCore作为新代理应用程序的部署和运营平台。它们不是模型本身,而是为模型附加内存、工具、执行环境、可观测性和权限边界的层。 Bedrock Agents模型使用指南
Model Evaluation和定制
Bedrock Evaluation允许通过自动指标、LLM评审和人工评估来比较模型和Knowledge Bases。模型定制为支持的模型和区域提供监督微调、强化微调和蒸馏等方法。蒸馏是一种利用大型教师模型的响应,将更小、更快的学生模型适应特定任务的方法。 Bedrock评估, 模型定制
6. 最简单的Python调用示例
首先,为应用程序使用的IAM角色授予所需模型的bedrock:InvokeModel最小权限。在本地,假设AWS CLI凭证已安全配置。请勿将访问密钥直接放入代码中。
import boto3

client = boto3.client("bedrock-runtime", region_name="us-east-1")

response = client.converse(
    modelId="YOUR_MODEL_ID",
    messages=[
        {
            "role": "user",
            "content": [{"text": "Amazon Bedrock을 한 문장으로 설명해줘."}],
        }
    ],
    inferenceConfig={
        "maxTokens": 200,
        "temperature": 0.2,
    },
)

print(response["output"]["message"]["content"][0]["text"])
print(response["usage"])将YOURMODELID替换为list-foundation-models结果或官方模型目录中当前区域支持的值。Converse提供通用的消息结构,但这并不意味着所有模型都支持相同的模态、工具调用或推理参数,因此需要查看兼容性表。
7. 成本如何计算?
Bedrock没有单一的统一费用。它根据模型、提供商、输入/输出模态、区域和推理方式而异。
按需(On-demand)
文本模型通常单独计算输入令牌和输出令牌。图像、视频和音频模型可能使用其他单位,例如图像数量、分辨率或生成时间。这适用于流量较小或不规则,以及尝试多种模型的情况。
批处理(Batch)
用于不需要即时响应的大规模任务。AWS指出,某些受支持模型的批处理推理价格比按需低50%。这对于可以容忍延迟的任务(如夜间文档分类、摘要和嵌入生成)有利。 Bedrock价格表
预置吞吐量(Provisioned Throughput)和服务层级
如果需要持续且可预测的吞吐量,您可以购买以模型单元(Model Unit)计量的预置吞吐量。它按小时计费,费用根据承诺期和模型而异。最新的价格表还包括Standard、Flex、Priority、Reserved等服务层级,因此您需要根据延迟、成本和容量保证要求进行确认。
仅计算模型成本很容易忽略实际账单。您还需要考虑Knowledge Bases的嵌入·向量存储、Guardrails检查、模型评估、日志存储、Lambda和数据传输成本。建议使用成本标签、Application Inference Profile和CloudWatch指标来按团队和服务分离使用量。
8. 安全和运营方面的优势
Bedrock在AWS组织中受到青睐的原因是它易于与现有控制体系集成。
- IAM可以限制调用主体和允许的模型。
- CloudTrail可以审计API活动,CloudWatch可以观察使用量和运营指标。
- KMS加密和VPC端点可以结合使用以加强数据边界。
- 模型特定权限、Knowledge Base数据和Guardrail策略可以按账户和区域进行分离。
Converse API文档明确指出,请求中提供的文本、图像、文档不会被Bedrock存储,仅用于生成响应。但是,如果组织开启了模型调用日志记录或应用程序单独存储了输入,则该数据将遵循日志和S3的保留策略。“Bedrock不存储”和“我们的系统不保留任何数据”是不同的说法。 WRIMO-MD-TABLE-2]Bedrock与其说是“最深入控制AI的方法”,不如说是“在AWS中将生成式AI应用程序最快产品化的方法”。反之,如果您需要直接修改特定的开源模型并优化GPU内存、批处理调度器和推理引擎,那么SageMaker AI或自托管可能更适合。 [AWS Bedrock或SageMaker决策指南
10. Bedrock特别有用的实际案例
内部文档问答
将S3文档与Knowledge Bases连接,通过Guardrails控制个人信息和禁止主题,并在答案中附带搜索依据。无需从头构建基础设施,即可快速验证RAG的核心组件。
呼叫中心摘要和咨询支持
可以将长对话通过小型模型进行分类·摘要,并将复杂查询路由到更强大的模型。需要同时设计PII屏蔽、响应依据和人工批准步骤。
文档·图像自动处理
多模态模型可以理解合同、收据、图表和产品图像,并生成结构化结果。生成的结果应在通过模式验证和业务规则后存储。
开发·安全运营辅助
可以创建日志摘要、工单分类、代码解释和安全事件调查草案。应从只读工具开始使用模型,而不是直接授予运营权限,并为更改操作设置批准门槛。
11. 引入前务必确认的局限性
Bedrock虽然方便,但并不能消除以下问题:
- 不同模型的质量、价格、延迟、上下文和API功能各不相同。
- 所需的模型并非在所有AWS区域都可用。
- 即使是按需使用,也存在配额和限流。
- 模型版本会变为Legacy和EOL,需要回归评估和替换计划。
- Guardrails可以降低风险,但不能阻止所有幻觉和提示攻击。
- RAG仅连接文档,不会自动修复原始数据的质量和访问权限。
- 无服务器减少了运营责任,但并未消除成本预测和应用程序可观测性责任。
12. 最现实的引入顺序
最好从一个小的路径开始,而不是一开始就启用代理和微调所有功能。
- 确定一项任务和成功指标。例如:咨询摘要准确率90%,响应时间3秒以内。
- 从实际数据中移除个人信息,创建评估集。
- 使用Converse API比较2-3个小型和强大的模型。
- 首先设置最小IAM权限、预算警报、CloudTrail和必要的指标。
- 当准确性需要内部知识时,连接Knowledge Bases或单独的RAG。
- 当需要输入/输出策略时,添加Guardrails和应用程序验证。
- 从只读工具开始使用代理,并为更改操作设置人工批准。
- 流量稳定后,通过比较批处理、缓存、小型模型和预置吞吐量来优化成本。
结论:Bedrock的核心不是GPU,而是改变运营边界
Amazon Bedrock最大的优势不在于隐藏生成式AI在GPU上运行的事实。它在于让应用程序团队能够专注于模型选择、数据质量、权限、安全性、成本和用户体验,而不是GPU采购、驱动程序、模型服务器、扩展和补丁。
能够在单一AWS运营体系中评估来自多个提供商的文本、多模态、图像、语音和嵌入模型,并结合Knowledge Bases、Guardrails、评估和代理功能,这一点也十分强大。另一方面,如果优先考虑低级别的GPU和运行时控制、特定模型的最新独特功能,或者非常高的固定使用量的成本优化,那么也应同时比较SageMaker AI或直接托管。
一句话总结:Bedrock不是一个不使用GPU的服务,而是AWS的托管模型平台,它让用户无需运营GPU即可将生成式AI集成到产品中。
发表回复