Amazon Bedrock(アマゾン ベドロック)は、複数の企業のファウンデーションモデルをAWS内でAPIとして選択・利用できるようにする、完全マネージド型の生成AIサービスです。簡単に言えば、直接GPUサーバーを購入し、モデルをダウンロードし、推論サーバーを運用する代わりに、必要なモデルにリクエストを送信し、使用量に応じて費用を支払う方式です。
ここで、最も重要な誤解を解く必要があります。BedrockがGPUを使用しないわけではありません。モデルの裏側ではGPUやAWSのAIアクセラレータが動作する可能性があります。ただし、ユーザーがEC2 GPUインスタンスを選択し、CUDAとドライバーを合わせ、モデルをデプロイし、オートスケーリングを運用する必要がなくなります。GPUをなくしたのではなく、GPUの運用をAWSの管理領域に移したのです。
この記事では、Bedrockの登場背景と歴史から、モデルの種類、リクエストの流れ、費用、セキュリティ、RAG・エージェント、SageMaker AIとの違い、実際の導入基準までを一度に整理します。
1. Bedrockはなぜ登場したのか
生成AIアプリケーションを直接運用するには、想像以上に多くの作業が必要です。GPUインスタンスを確保し、モデルの重みを保存し、推論フレームワークとドライバーのバージョンを合わせ、トラフィックに応じてレプリカを増やす必要があります。モデルを変更すると、入力形式や運用方法も再検討しなければなりません。
逆に、外部モデル企業のAPIを直接使用すれば、開始は早いですが、AWSのIAM権限、CloudTrail監査、ネットワーク境界、既存のアプリケーション運用体系への統合作業が残ります。複数のモデルを比較したり交換したりする際には、プロバイダーごとのAPIの違いも大きくなります。
Bedrockは、この両者のギャップを埋めるために登場しました。AWSは2023年4月にBedrockを初めて公開し、2023年9月28日に正式リリースしました。当時の核は、Amazonだけでなく、Anthropic、AI21 Labs、Cohere、Stability AIなどの複数のプロバイダーのモデルを、一つの完全マネージド型サービスで提供することでした。 AWSのBedrock正式リリース発表
その後、Bedrockは単なる「モデル呼び出しAPI」から、生成AIアプリケーションプラットフォームへと広がりました。
- 2023年: Bedrock正式リリース、AgentsとKnowledge Basesなどのアプリケーション機能拡張
- 2024年4月: GuardrailsとModel Evaluation正式リリース
- 2024年12月: Amazon Novaモデル群と100以上の専門モデルを接続するBedrock Marketplace発表
- 2025年以降: マルチモーダルガードレール、自動推論検査、モデル選択・評価・カスタマイズ、AgentCoreを含むエージェント運用機能拡張
この歴史は、Bedrockの正体をよく示しています。最初は「複数のモデルをサーバーレスAPIで呼び出すサービス」でしたが、今はモデル・データ・安全装置・評価・エージェント運用をAWSの権限と監査体系の中でまとめるプラットフォームに近い存在です。 Guardrails正式リリース, Amazon Nova発表, Bedrock Marketplace発表
2. 「GPUなしで使う」という言葉の正確な意味
Bedrockのサーバーレスは、Lambdaのようにコードを実行するという意味ではなく、モデル推論に必要なインフラをユーザーが直接プロビジョニングしないという意味です。アプリケーションはHTTPS APIを呼び出し、AWSがバックエンドの容量配置と拡張を担当します。
直接ホスティングと比較すると、不要になる作業が明確です。
| 区分 | 直接GPUホスティング | Bedrockマネージド推論 |
| — | — | — |
| コンピューティング選択 | GPU種類・数量・VRAM決定 | モデルと推論方式選択 |
| ソフトウェア | ドライバー・CUDA・推論サーバー管理 | APIとSDK使用 |
| デプロイ | モデル重みデプロイ・複製 | モデルIDまたは推論プロファイル指定 |
| 拡張 | レプリカ・バッチ・キュー直接設計 | オンデマンド容量をAWSが管理 |
| 費用単位 | インスタンス稼働時間中心 | モデル別入力・出力トークン、画像、秒など |
| 詳細制御 | 量子化・ランタイム・GPUまで制御 | 提供されるモデル・リージョン・機能範囲内で選択 |
この利点は、特にPoCや変動トラフィックにおいて大きいです。1日に数回しか呼び出さない内部要約ツールのために、24時間GPUを稼働させる必要はありません。複数のモデルを短期間で評価する際も、それぞれの推論サーバーを作成する必要がありません。
しかし、サーバーレスが無制限を意味するわけではありません。アカウントとモデルごとの割り当て量、1分あたりの処理量、リージョンの可用性、一時的なスロットリングは依然として考慮する必要があります。予測可能な専用処理量が必要な場合は、時間あたりの固定費用であるProvisioned Throughputを選択できます。 Bedrock Provisioned Throughputドキュメント
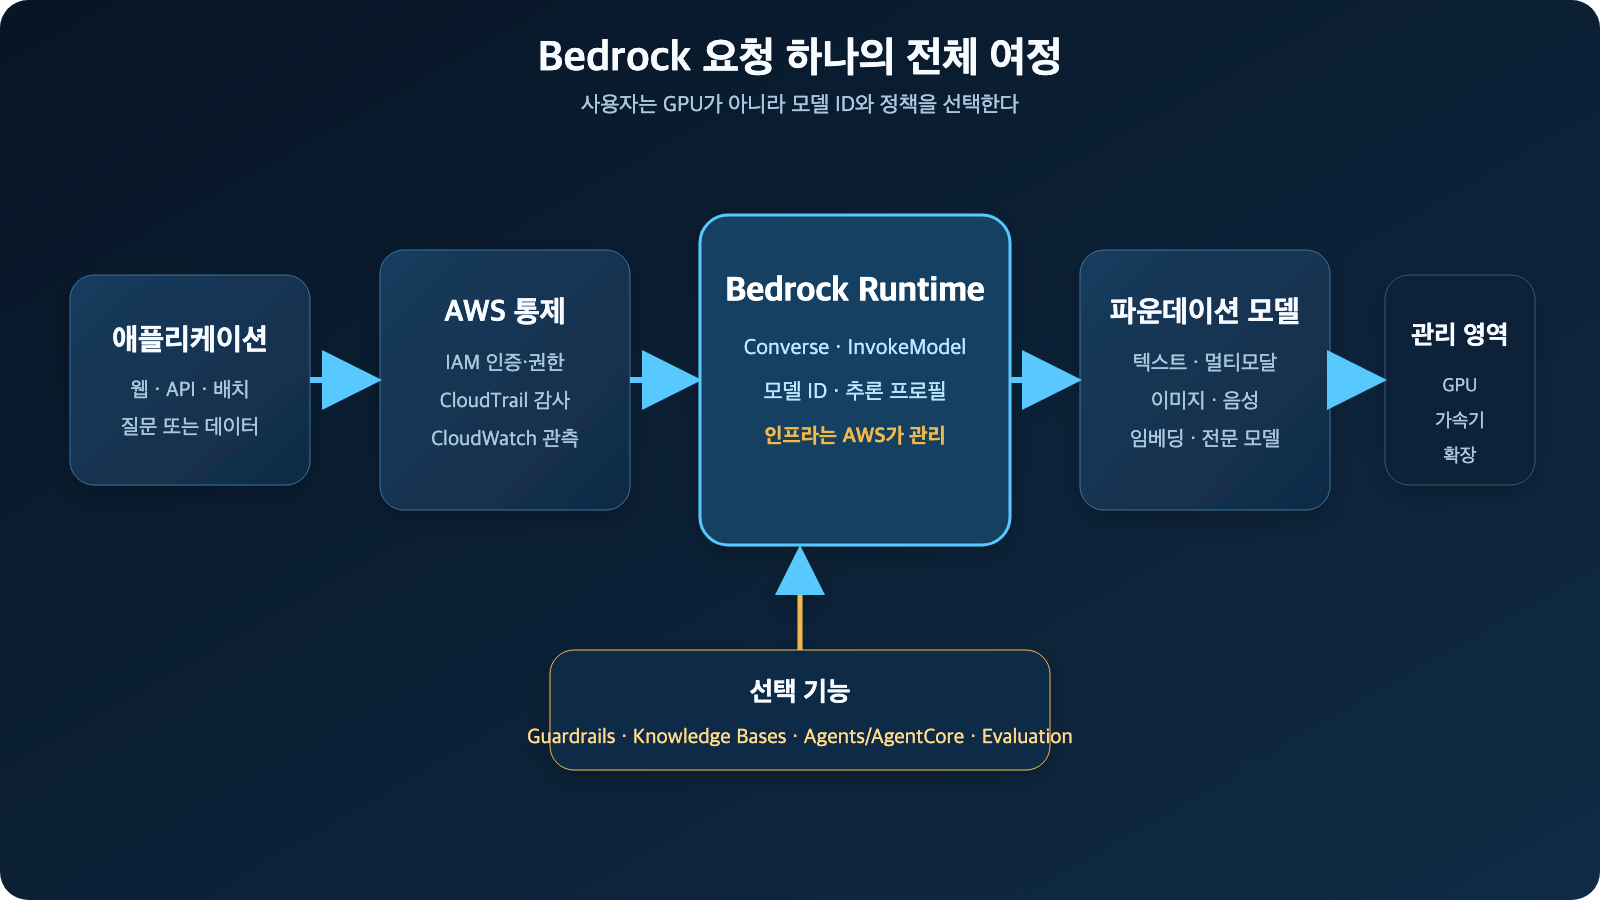
図1. Bedrockのリクエスト経路。GPUと推論サーバーは消滅したのではなく、AWS管理領域の裏側にある。AWS Bedrock正式リリース説明とBedrock APIドキュメントを基に再構成。
3. 1つのリクエストが処理される順序
Bedrockを理解する最も早い方法は、1つのリクエストを追うことです。
- ユーザーがウェブや業務システムに質問を入力します。
- アプリケーションはIAMロールまたはAWS認証情報でBedrock Runtime APIを呼び出します。
- 必要に応じて、Guardrailsが入力から禁止テーマ、有害コンテンツ、プロンプト攻撃、個人情報を検査します。
- アプリケーションがKnowledge Basesを使用する場合、質問に関連する社内文書を検索してコンテキストを作成します。
- 指定されたモデルまたは推論プロファイルが入力処理を行います。
- Guardrailsが適用されている場合、モデル出力も再度検査するか、機密情報をマスキングします。
- アプリケーションは結果と使用量情報を受け取り、ユーザーに表示し、必要なメトリクスと監査イベントを記録します。
Bedrock Runtimeには目的の異なるAPIがあります。Converseはメッセージをサポートするモデルに共通の会話インターフェースを提供するため、モデルの交換が容易です。InvokeModelは、画像・埋め込みを含むモデル固有の形式と機能をより直接的に制御する場合に使用します。最新のBedrockはOpenAI互換のResponses・Chat Completions APIとAnthropic Messages APIも提供しますが、エンドポイントとモデルによってサポートされる機能が同じではないため、互換性表を確認する必要があります。 BedrockサポートAPI, Bedrockモデルカタログ, Bedrock料金表のプロバイダーリスト
実務では、会社名よりも入力と出力の種類で分ける方が理解しやすいです。
| モデルタイプ | 機能 | 代表的な活用例 |
| — | — | — |
| テキスト・推論 | 質問応答、要約、分類、コード、ツール呼び出し | チャットボット、文書処理、業務自動化 |
| マルチモーダル理解 | テキストと画像・文書・動画の理解 | 図面分析、レシート処理、動画照会 |
| 画像生成・編集 | 文章からの画像生成、インペインティング・アップスケール | マーケティング素材、デザイン補助 |
| 音声・リアルタイム | 音声入力と出力、対話型ストリーミング | コールセンター、音声アシスタント |
| 埋め込み | 文章・画像を検索可能なベクトルに変換 | 意味検索、RAG、レコメンデーション |
| リランキング | 検索された候補の関連度再整理 | RAG検索品質向上 |
| 動画・専門モデル | 動画生成・検索、特定産業作業 | メディア制作、専門分析 |
Amazon独自のNovaファミリーだけでも、コストと遅延に焦点を当てたテキストモデル、マルチモーダル理解、画像生成、動画生成、音声対話、埋め込みモデルがあります。他のプロバイダーのモデルも加えると、選択肢はさらに広がります。
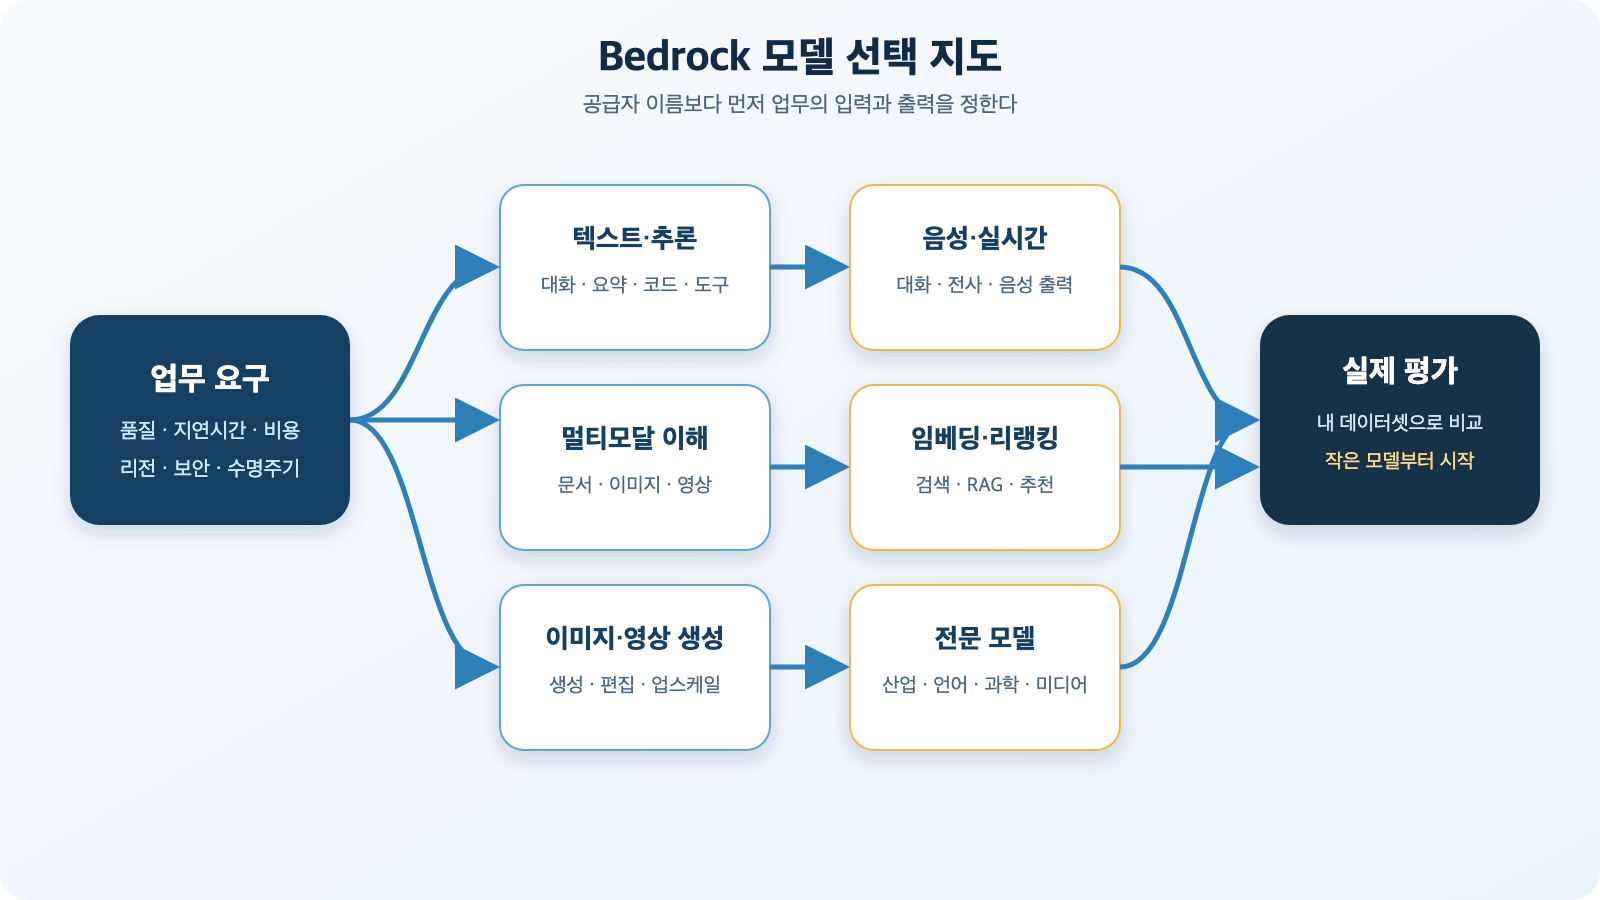
図2. モデルプロバイダーよりもまず入出力形式と業務目的を選択する。AWS Models at a glanceを基に再構成。
モデル選択はベンチマーク1位探しではない
最も大きなモデルが常に最良の選択とは限りません。実際のデータセットで以下の項目を一緒に測定する必要があります。
- 品質: 正答率、忠実性、ツール呼び出し成功率、日本語品質
- 遅延時間: 最初のトークン時間と全体の応答時間
- 費用: 入力・出力トークン、キャッシュ、ガードレール、検索費用
- コンテキスト: 必要な文書長とマルチモーダル入力サポート
- 運用性: 必要なリージョン、オンデマンドの有無、割り当て量、ストリーミングサポート
- ライフサイクル: Active・Legacy・EOL状態と移行計画
BedrockモデルはActive、Legacy、End-of-Lifeの状態で管理されます。AWSドキュメント上、モデルはBedrockにリリースされてからEOLまで最低12ヶ月を設けていますが、Legacyになると新規使用制限や移行計画が必要になる場合があります。運用コードではモデルIDを設定として分離し、回帰評価を自動化する方が安全です。 Bedrockモデルライフサイクル
現在のAWSアカウントとリージョンで実際に利用可能な基本モデルはCLIで確認できます。
aws bedrock list-foundation-models
  --region us-east-1
  --query 'modelSummaries[].{provider:providerName,name:modelName,id:modelId,status:modelLifecycle.status}'
  --output table
この結果は、ブログや古い例のモデルリストよりも正確です。同じモデルでもリージョン、推論方式、機能サポートが異なる場合があります。 Bedrockモデル照会方法
5. Bedrockはモデル周辺に何を提供するのか
Bedrockの実務価値は、モデル呼び出しよりも周辺機能で大きくなります。
Knowledge Bases: 社内文書を接続するマネージドRAG
RAG(Retrieval-Augmented Generation)は、質問に関連する社内文書をまず探し、その内容をモデル入力に付加して回答の根拠を補強する方法です。Knowledge Basesは、文書収集、分割、埋め込み生成、ベクトル検索、モデル呼び出しを連携させます。
この機能はRAGの組み立て負担を軽減しますが、自動的に正確性を保証するものではありません。チャンキング方式、メタデータフィルター、埋め込みとリランカー、アクセス制御、根拠評価を実際のデータで検証する必要があります。
Guardrails: モデル外部の共通安全ポリシー
Guardrailsはユーザー入力とモデル応答を検査します。コンテンツフィルター、禁止テーマ、単語フィルター、機密情報、画像フィルターなどのポリシーを組み合わせることができ、モデル推論・Knowledge Bases・エージェント・Flowに適用できます。入力がブロックされるとモデル呼び出し自体が実行されない場合があり、出力がポリシーに違反するとブロックメッセージやマスキング結果に置き換えられます。 Bedrock Guardrailsの動作方式
ガードレールはセキュリティ境界全体を代替するものではありません。IAM権限、ツールごとの承認、データアクセス制御、出力検証、Human-in-the-Loopが別途必要です。
AgentsとAgentCore: モデルにツールを使わせる
エージェントは、モデルが質問に答えるだけでなく、APIやLambdaのようなツールを選択して作業を実行できるようにします。既存のAgents for Amazon Bedrockはタスクオーケストレーションをマネージド型で提供し、最新のAWSドキュメントは新しいエージェントアプリケーションのデプロイ・運用プラットフォームとしてAgentCoreを推奨しています。これらはモデル自体ではなく、モデルにメモリ、ツール、実行環境、可観測性、権限境界を付与するレイヤーです。 Bedrock Agentsモデル使用案内
Model Evaluationとカスタマイズ
Bedrock Evaluationは、モデルとKnowledge Basesを自動指標、LLM審査、人間評価で比較できるようにします。モデルカスタマイズは、サポートされるモデルとリージョンで、教師ありファインチューニング、強化学習ファインチューニング、蒸留などの方法を提供します。蒸留は、大きな教師モデルの応答を利用して、より小さく高速な学生モデルを特定の業務に合わせる方式です。 Bedrock評価, モデルカスタマイズ
6. 最小のPython呼び出し例
まず、アプリケーションが使用するIAMロールに、必要なモデルのbedrock:InvokeModel権限を最小範囲で付与します。ローカルでは、AWS CLI認証情報がすでに安全に構成されていると仮定します。アクセスキーをコードに直接記述しないでください。
import boto3

client = boto3.client("bedrock-runtime", region_name="us-east-1")

response = client.converse(
    modelId="YOUR_MODEL_ID",
    messages=[
        {
            "role": "user",
            "content": [{"text": "Amazon Bedrock을 한 문장으로 설명해줘."}],
        }
    ],
    inferenceConfig={
        "maxTokens": 200,
        "temperature": 0.2,
    },
)

print(response["output"]["message"]["content"][0]["text"])
print(response["usage"])YOURMODELIDは、上記のlist-foundation-modelsの結果または公式モデルカタログから、現在のリージョンがサポートする値に置き換えます。Converseは共通のメッセージ構造を提供しますが、すべてのモデルが同じモダリティ・ツール呼び出し・推論パラメータをサポートするわけではないため、互換性表を確認する必要があります。
7. 費用はどのように計算されるか
Bedrockには単一の料金体系はありません。モデル、プロバイダー、入出力モダリティ、リージョン、推論方式によって異なります。
オンデマンド
テキストモデルは、通常、入力トークンと出力トークンを別々に計算します。画像・動画・音声モデルは、画像数、解像度、生成時間などの異なる単位を使用する場合があります。トラフィックが少ない、または不規則で、複数のモデルを試す場合に適しています。
バッチ
即時応答が不要な大量の作業に使用します。AWSは、サポートされる一部のモデルのバッチ推論をオンデマンドよりも50%低い価格で案内しています。夜間の文書分類、要約、埋め込み生成など、遅延を許容する作業に有利です。 Bedrock料金表
Provisioned Throughputとサービスティア
継続的で予測可能な処理量が必要な場合は、Model Unit単位のProvisioned Throughputを購入できます。時間単位で課金され、契約期間とモデルによって費用が異なります。最新の料金表には、Standard、Flex、Priority、Reservedなどのサービスティアもあるため、遅延時間・費用・容量保証の要件に合わせて確認する必要があります。
モデル費用だけを計算すると、実際の請求額を見落としがちです。Knowledge Basesの埋め込み・ベクトルストレージ、Guardrails検査、モデル評価、ログ保存、Lambda、データ転送費用も合わせて考慮する必要があります。費用タグとApplication Inference Profile、CloudWatchメトリクスを利用して、チームとサービスごとの使用量を分離することをお勧めします。
8. セキュリティと運用で有用な理由
BedrockがAWS組織で好まれる理由は、既存の統制体系と連携しやすいからです。
- IAMで呼び出し主体と許可モデルを制限できます。
- CloudTrailでAPI活動を監査し、CloudWatchで使用量と運用メトリクスを監視できます。
- KMS暗号化とVPCエンドポイントを組み合わせてデータ境界を強化できます。
- モデルごとの権限、Knowledge Baseデータ、Guardrailポリシーをアカウントとリージョン単位で分離できます。
Converse APIドキュメントは、リクエストで提供されたテキスト・画像・文書をBedrockが保存せず、応答生成にのみ使用すると明記しています。ただし、組織がモデル呼び出しロギングを有効にしたり、アプリケーションが入力データを別途保存したりする場合、そのデータはログとS3の保持ポリシーに従います。「Bedrockが保存しない」と「私たちのシステムどこにも残らない」は異なる意味です。 WRIMO-MD-TABLE-2]Bedrockは「AIを最も深く制御する方法」というよりも「AWS内で生成AIアプリケーションを最も早く製品化する方法」に近い存在です。逆に、特定のオープンモデルを直接修正し、GPUメモリ、バッチスケジューラ、推論エンジンまで最適化する必要がある場合は、SageMaker AIや自己ホスティングの方が適しているかもしれません。 [AWS BedrockまたはSageMaker決定ガイド
10. Bedrockが特に有用な実際の事例
社内文書質疑応答
S3文書とKnowledge Basesを接続し、Guardrailsで個人情報と禁止テーマを統制し、回答に検索根拠を付加する形式です。インフラを最初から構築することなく、RAGの主要コンポーネントを迅速に検証できます。
コールセンター要約と相談支援
長い会話を小さなモデルで分類・要約し、複雑な質問だけをより強力なモデルにルーティングできます。PIIマスキング、応答根拠、人間承認のステップを合わせて設計する必要があります。
文書・画像自動処理
マルチモーダルモデルで契約書、領収書、図表、製品画像を理解し、構造化された結果を生成できます。生成結果はスキーマ検証と業務ルールを通過させた後に保存する必要があります。
開発・セキュリティ運用補助
ログ要約、チケット分類、コード説明、セキュリティイベント調査の草案を作成できます。モデルに直接運用権限を与えるのではなく、読み取り専用ツールから開始し、変更作業には承認ゲートを設けるべきです。
11. 導入前に必ず確認すべき限界
Bedrockは便利ですが、以下の問題を解消するわけではありません。
- モデルごとに品質、価格、遅延時間、コンテキスト、API機能が異なります。
- 希望するモデルがすべてのAWSリージョンにあるわけではありません。
- オンデマンドでも割り当て量とスロットリングがあります。
- モデルバージョンはLegacyやEOLに移行するため、回帰評価と交換計画が必要です。
- Guardrailsはリスクを軽減しますが、すべての幻覚やプロンプト攻撃を防ぐわけではありません。
- RAGは文書を接続するだけで、元のデータの品質やアクセス権限を自動的に修正するわけではありません。
- サーバーレスは運用責任を軽減しますが、費用予測とアプリケーションの可観測性責任までなくすわけではありません。
12. 最も現実的な導入順序
最初からエージェントとファインチューニングをすべて有効にするよりも、小さな経路から始める方が良いです。
- 1つの業務と成功指標を定めます。例:相談要約の正確度90%、応答3秒以内。
- 実際のデータから個人情報を削除した評価セットを作成します。
- 小さなモデルと強力なモデル2〜3個をConverse APIで比較します。
- IAM最小権限、予算アラート、CloudTrail、必要なメトリクスをまず設定します。
- 正確性に社内知識が必要な場合、Knowledge Basesまたは別途RAGを接続します。
- 入出力ポリシーが必要な場合、Guardrailsとアプリケーション検証を追加します。
- 読み取り専用ツールからエージェントを開始し、変更作業には人間の承認を設けます。
- トラフィックが安定した後、バッチ、キャッシュ、小さなモデル、Provisioned Throughputを比較して費用を最適化します。
結論: Bedrockの核心はGPUではなく、運用境界を変えること
Amazon Bedrockの最大の利点は、生成AIがGPUで実行されるという事実を隠すことではありません。アプリケーションチームがGPUの確保、ドライバー、モデルサーバー、拡張、パッチではなく、モデル選択、データ品質、権限、安全性、費用、ユーザーエクスペリエンスに集中できるようにすることにあります。
複数のプロバイダーのテキスト・マルチモーダル・画像・音声・埋め込みモデルを、一つのAWS運用体系で評価し、Knowledge Bases・Guardrails・評価・エージェント機能を組み合わせられる点も強力です。一方、低レベルのGPUとランタイム制御、特定のモデルの最新固有機能、非常に高い固定使用量の費用最適化が優先される場合は、SageMaker AIや直接ホスティングも合わせて比較検討する必要があります。
一文でまとめるとこうなります。BedrockはGPUを使用しないサービスではなく、ユーザーがGPUを運用しなくても生成AIを製品に組み込めるようにするAWSのマネージドモデルプラットフォームです。
コメントを残す