大家好!今天我想和大家聊聊Pushgateway,这是一个在Prometheus生态系统中用于收集短期运行作业(short-lived jobs)指标的有用工具。
Pushgateway能够有效地监控Cron Job、批处理作业(Batch Job)等生命周期短、Prometheus难以直接抓取(pull)指标的目标数据。然而,这个便捷的工具隐藏着我们必须了解的陷阱。那就是“陈旧(Stale)指标”或“僵尸指标”问题。
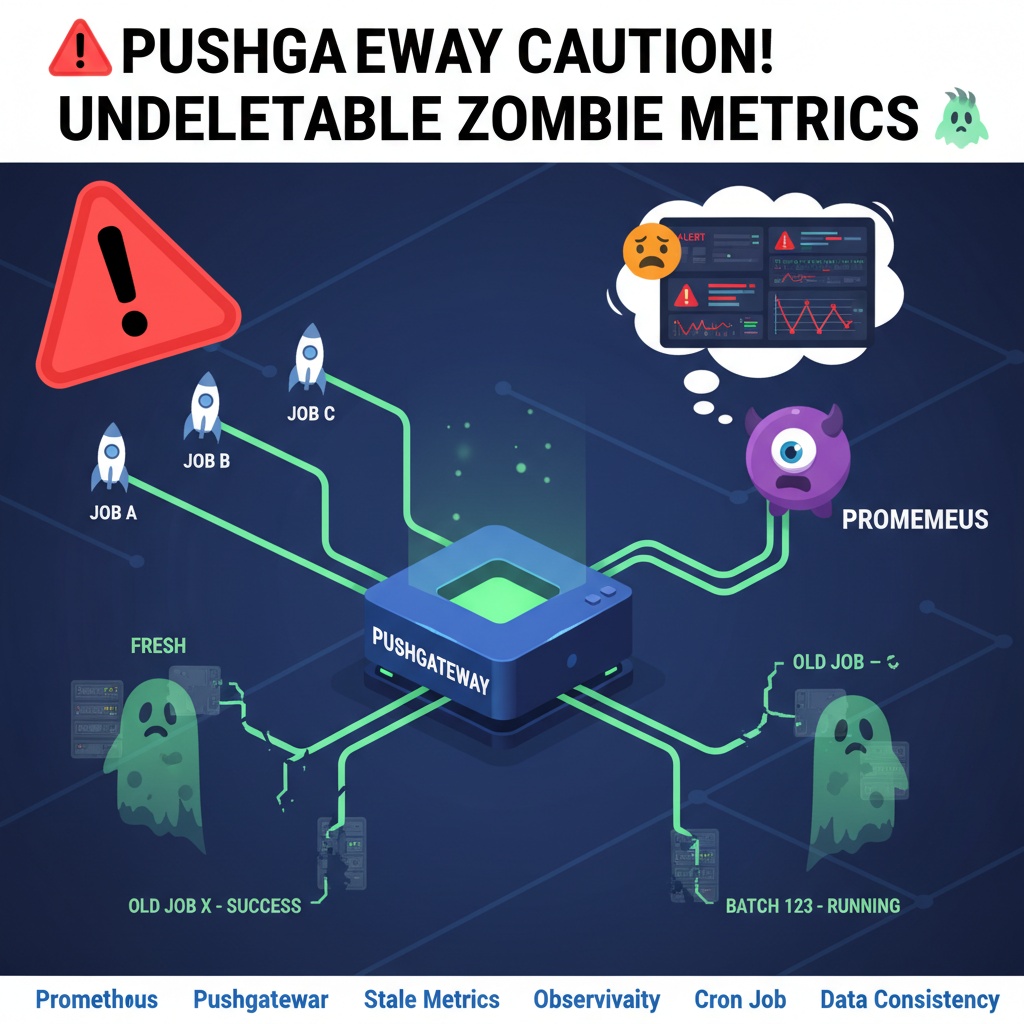
🤔 Pushgateway是如何工作的?
Pushgateway的核心工作方式类似于“缓存(Cache)”。
- 作业开始 🚀: 批处理作业或临时作业开始执行。
- 指标发送 (Push) 📊: 作业将其状态或结果的指标发送到Pushgateway。
- 指标存储 📥: Pushgateway将接收到的指标存储在其内部。
- Prometheus抓取 (Scrape) 🔍: Prometheus定期从Pushgateway中获取存储的指标。
到目前为止,看起来很完美,对吧?但问题发生在作业结束后。
🧟♂️ 僵尸指标为何会出现?
假设一个批处理作业成功完成并终止。
- 作业(Job): 执行结束 ✅
- Pushgateway: 持续保存着“作业A最后发送的指标是这个!” 📝
Pushgateway会原封不动地保留最后推送的指标。也就是说,它自身并不知道发送指标的作业已经消失了。这就像活动结束后仍然贴在墙上的旧海报一样。📌
在这种状态下,Prometheus会持续抓取Pushgateway,而Pushgateway则会持续将已终止作业的陈旧(stale)指标发送给Prometheus。这些指标就是“僵尸指标”。
😱 陈旧指标为何是严重问题?
- 错误的数据和仪表盘 📉 仪表盘上会持续显示已不存在的作业数据。这会导致对系统状态的误判。例如,即使“上次备份成功”指标是三天前的数据,它也可能持续显示为“成功”。
- 误报警报 (False-Positive Alerts) 🚨 这是最致命的问题。Prometheus会根据从Pushgateway接收到的陈旧指标评估警报规则。如果“作业失败”指标未被删除并仍然存在,您可能会持续收到关于已解决问题的警告警报。这会增加操作员的疲劳度,并延迟对真正问题的响应。
这是使用Pushgateway时最常见且最需要注意的问题。
✨ 如何解决?
解决方案很简单:“用完的地方要清理干净!”
作业成功完成后,必须包含将该作业的指标从Pushgateway中手动删除的逻辑。
正确的作业流程:
- 作业开始 🚀
- 指标发送 📊 (作业进行中)
- 作业完成 ✅
- 从Pushgateway删除指标 🗑️ (作业脚本的最后一步)
这样,Prometheus将不再收集陈旧指标,从而保持数据的一致性,并防止不必要的警报。
结语
Pushgateway无疑是监控短期运行作业的强大工具。但是,如果不能准确理解和使用其特性,反而会降低整个监控系统的可靠性。
如果您使用Pushgateway,请务必记住在作业完成后删除指标!为了健康的监控环境,这个小习惯真的非常重要。😊
发表回复