こんにちは!今日は、Prometheusエコシステムにおいて、短期間実行されるジョブ(short-lived jobs)のメトリックを収集するのに便利なツールであるPushgatewayについてお話ししたいと思います。
Pushgatewayは、Cron Jobやバッチジョブ(Batch Job)のように寿命が短く、Prometheusが直接メトリックを収集(pull)するのが難しい対象のデータを効果的に監視できるようにします。しかし、この便利なツールには、私たちが必ず知っておくべき落とし穴が隠されています。それが「古い(Stale)メトリック」または「ゾンビメトリック」問題です。
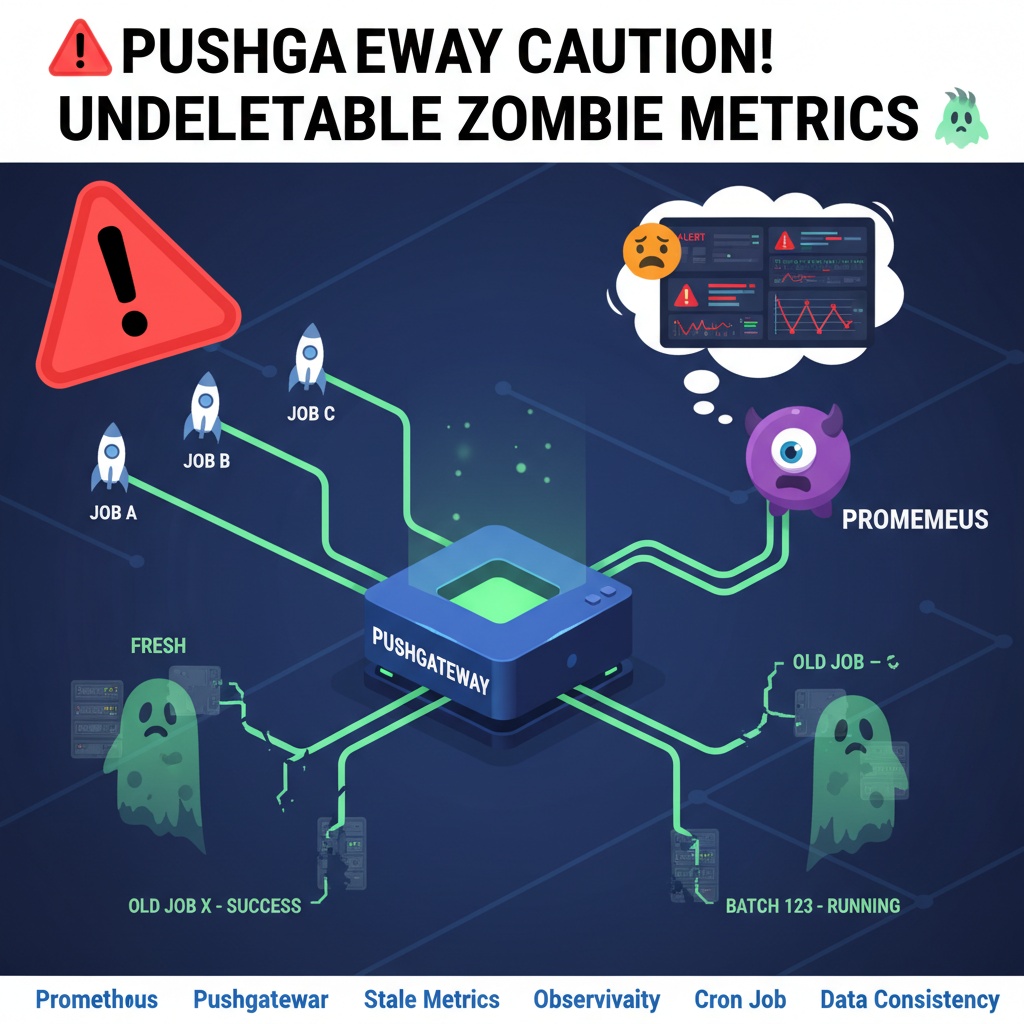
🤔 Pushgatewayはどのように動作しますか?
Pushgatewayの核となる動作原理は「キャッシュ(Cache)」と同じです。
- ジョブ開始 🚀: バッチジョブや一時的なジョブが実行されます。
- メトリック送信 (Push) 📊: ジョブは自身の状態や結果に関するメトリックをPushgatewayに送信します。
- メトリック保存 📥: Pushgatewayは受け取ったメトリックを内部に保存します。
- Prometheus収集 (Scrape) 🔍: Prometheusは定期的にPushgatewayに保存されたメトリックを取得します。
ここまでは完璧に見えますよね?しかし、問題はジョブが終了した後に発生します。
🧟♂️ ゾンビメトリックはなぜ発生するのでしょうか?
バッチジョブが正常に完了し、終了したと仮定してみましょう。
- ジョブ(Job): 実行終了 ✅
- Pushgateway: 「ジョブAが最後に送ったメトリックはこれだったよ!」と継続して保管中 📝
Pushgatewayは最後にプッシュされたメトリックをそのまま維持します。つまり、メトリックを送信したジョブが消滅したという事実を、Pushgateway自身は認識しません。まるでイベントが終わった後も壁に貼られた古いポスターのように。📌
この状態でPrometheusはPushgatewayをスクレイピングし続け、Pushgatewayはすでに終了したジョブの古い(stale)メトリックをPrometheusに送り続けます。このメトリックこそが「ゾンビメトリック」です。
😱 古いメトリックがなぜ深刻な問題なのでしょうか?
- 誤ったデータとダッシュボード 📉 すでに存在しないジョブに関するデータがダッシュボードに表示され続けます。これはシステムの状態を誤判断させる原因となります。例えば、「最後のバックアップ成功」メトリックが3日前のデータであるにもかかわらず、ずっと「成功」と表示され続ける可能性があります。
- 誤検知アラート (False-Positive Alerts) 🚨 最も致命的な問題です。PrometheusはPushgatewayから受け取った古いメトリックに基づいてアラートルールを評価します。もし「ジョブ失敗」メトリックが削除されずに残っている場合、すでに解決された問題に対して継続的に警告アラートを受け取ることになるかもしれません。これは運用者の疲労度を高め、本当の問題への対応を遅らせることになります。
これがPushgatewayを使用する際に最も頻繁に遭遇し、最も注意すべき問題です。
✨ どのように解決すべきでしょうか?
解決策は簡単です。「使った場所はきれいに片付けよう!」
ジョブが正常に完了した後、そのジョブのメトリックをPushgatewayから手動で削除するロジックを必ず含める必要があります。
正しいジョブフロー:
- ジョブ開始 🚀
- メトリック送信 📊 (ジョブ進行中)
- ジョブ完了 ✅
- Pushgatewayからメトリック削除 🗑️ (ジョブスクリプトの最終ステップ)
このようにすることで、Prometheusは古いメトリックを収集しなくなり、データの整合性を維持し、不要なアラートを防ぐことができます。
結び
Pushgatewayは、短期間実行されるジョブの監視において強力なツールであることは間違いありません。しかし、その特性を正確に理解して使用しないと、かえって監視システム全体の信頼性を低下させる可能性があります。
Pushgatewayを使用する際は、ジョブ完了後にメトリックを削除することを決して忘れないでください!健全な監視環境のためには、この小さな習慣が本当に重要です。😊
コメントを残す