大家好!在数据工程的世界里,“做什么”固然重要,“以什么顺序做”同样至关重要。特别是在构建可观测性(Observability)管道时,处理器(processor)的顺序如何决定,将极大地影响系统的效率和安全性。
今天,我们将探讨从数据收集到导出,最有效和逻辑的数据管道顺序。🚀
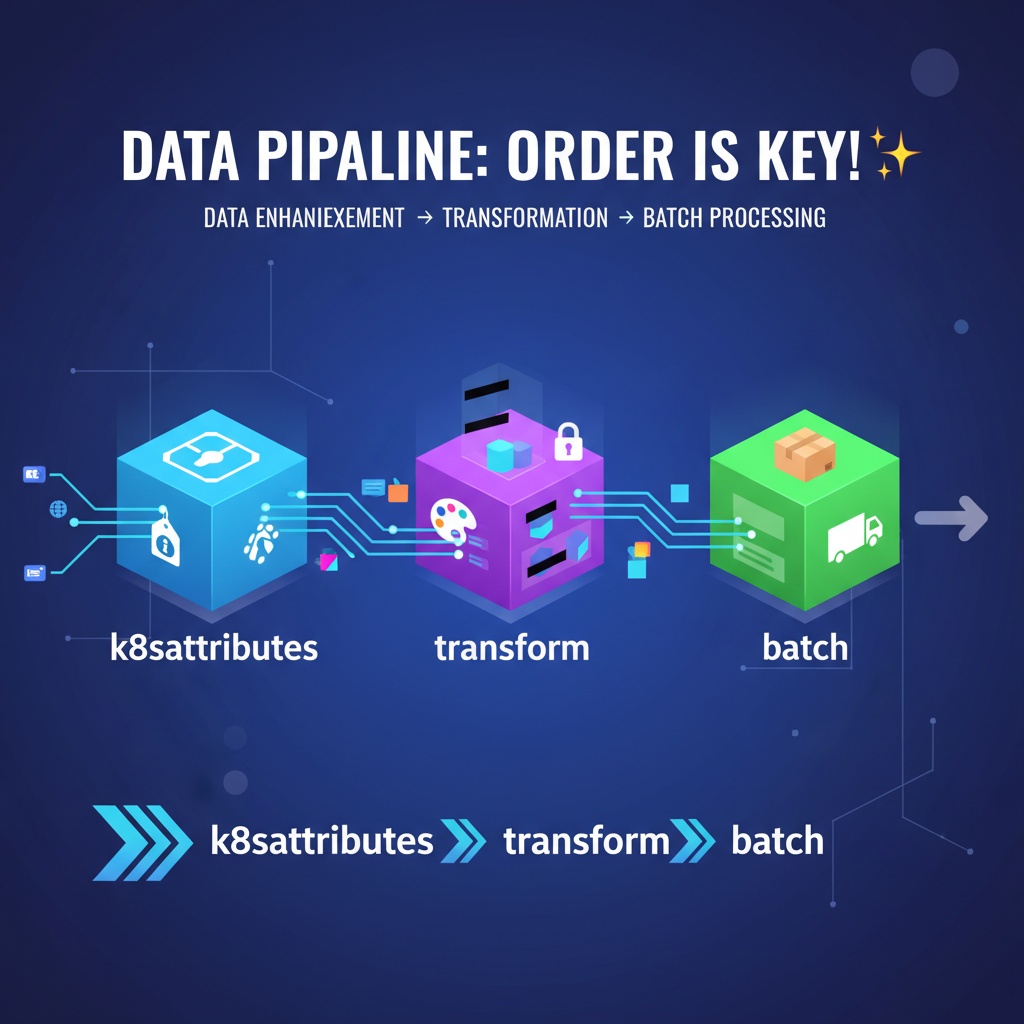
1️⃣ 第一步:添加上下文 (k8sattributes) 🏷️
首先要做的是为我们收集到的数据“贴标签”。这是一个添加元数据的过程,包括数据来源、生成环境等信息。
例如,如果在Kubernetes环境中收集数据,那么数据来源于哪个Pod、属于哪个Namespace等信息就非常重要。k8sattributes处理器正是扮演这样的角色。
- 为什么是第一步? 🤔
- 数据需要有丰富的上下文(context),才能在后续步骤中执行有意义的操作。例如,要应用“只过滤来自A命名空间的数据”或“对来自B Pod的数据进行特殊处理”等规则,数据中必须已经包含这些信息。
- 可以将其视为一个基本的身份验证过程! 🏗️
2️⃣ 第二步:数据加工与转换 (transform) 🎨
现在数据已经有了丰富的上下文。下一步是将这些数据“加工”成我们想要的形式。transform处理器负责修改、过滤或重构数据。
其中最重要的任务之一是敏感信息掩码。例如,如果日志数据包含用户的电子邮件地址或个人身份信息,在导出之前必须将其遮盖。🤫
- 为什么是第二步? 🤔
- 可以利用第一步添加的元数据来应用更精细的转换规则。(例如,只有当k8sattributes增强的Pod名称是’prod-db’时,才对user.email字段进行掩码处理)
- 为了安全和合规性,必须在此阶段彻底清除不必要或敏感的数据。🔒
3️⃣ 第三步:准备高效传输 (batch) 📦
数据增强和转换都已完成!现在,这些宝贵的数据需要发送到最终目的地。但是,逐个发送效率非常低,就像一次只寄一封信到邮局一样。
batch处理器负责将处理过的数据打包成一定大小的批次(batch),以便一次性传输。
- 为什么是最后一步? 🤔
- 在所有处理(增强、转换、过滤等)完成后,打包最终结果是最有效的。如果数据在转换之前就被打包,那么为了进行转换操作,可能需要解包并重新处理,这会带来不便。
- 这是为了降低网络成本并最大化传输效率的最后优化步骤。🚚💨
🏁 结论:正确顺序的重要性
数据处理管道中处理器的顺序可以总结如下:
k8sattributes (增强) ➡️ transform (转换) ➡️ batch (批处理)
- 首先,为数据赋予上下文,
- 然后,利用赋予的上下文安全有效地加工数据,
- 最后,高效地导出完全处理好的数据。
记住这个逻辑流程,您将能够构建更稳定、更高效的数据管道! ✨
发表回复