无论可观测系统收集了多少日志、追踪和指标,如果需要人工持续监控仪表盘,就无法提前预警风险。警报(Alert)是观测值满足预设条件的状态,而通知(Notification)是将该警报发送到电子邮件、即时通讯或呼叫系统等接收方的结果。区分两者才能将“检测条件的责任”与“决定何时通知谁的责任”分开。
本文将为LLM安全可观测性堆栈添加警报功能。其流程是:Prometheus评估阻断率和错误率,Alertmanager执行去重、分组、路由、静默和抑制,Grafana提供调查警报状态及相关指标、日志、追踪的界面。我们还将区分使用Grafana-managed Alerting的替代方案。
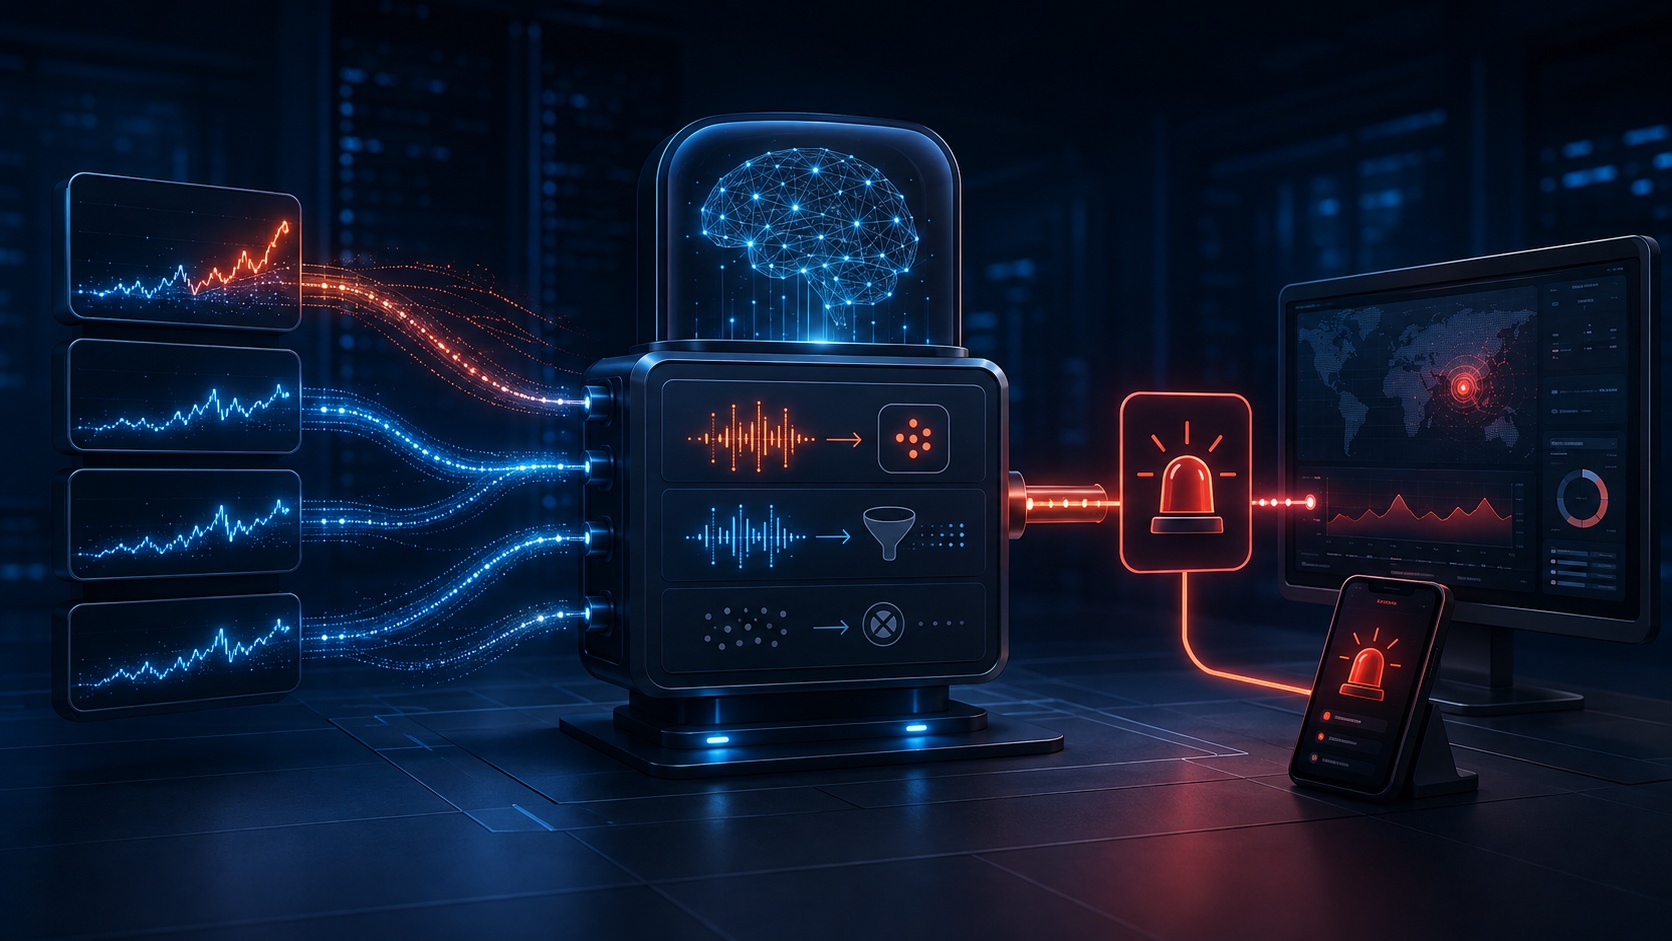
首先划分警报管道的职责
Prometheus警报规则会定期评估PromQL表达式。可以设置“for”持续时间,以避免条件短暂为真时立即唤醒人员。Alertmanager接收来自Prometheus等客户端发送的警报,将相同事件进行分组,对已发送的通知进行去重,并根据标签发送给接收器。
Grafana可以扮演两种角色。一是可视化Prometheus和Alertmanager状态并导航到相关数据的可观测界面。二是直接评估Grafana-managed警报规则,并使用内置的Grafana Alertmanager管理通知策略和联系点的警报平台。如果在一个环境中不经意地混用这两种方式,可能会导致相同条件被评估两次,从而产生重复通知。
| 配置 | 规则评估 | 通知路由 | 适用场景 |
| — | — | — | — |
| Prometheus + 外部Alertmanager | Prometheus | Alertmanager | 以Prometheus为中心,通过文件·Git管理规则 |
| Grafana-managed Alerting | Grafana | 内置Grafana Alertmanager或支持的外部Alertmanager | 在一个界面管理多个数据源的查询·表达式 |
| 混合操作 | 按规则明确 | 按路径明确 | 保留现有Prometheus规则,并添加部分多数据源警报 |
本文的实践将以第一种结构为基础。Grafana将专注于查询和调查。
LLM安全警报应该触发什么?
如果所有阻断都触发紧急呼叫,那么正常的防御活动也会导致警报疲劳。首先要问:“如果现在不人工干预,损害是否会扩大?”
| 信号 | 建议处理示例 | 原因 |
| — | — | — |
| 1次提示注入阻断 | 仪表盘·日志记录 | 可能是正常的防御成功 |
| 阻断率持续高于基线 | 警告通道 | 可能存在自动化攻击或策略误报 |
| 阻断后发生工具调用 | 紧急呼叫候选 | 可能存在Guardrail绕过或控制流缺陷 |
| 可观测管道收集中断 | 单独的运维警报 | 必须区分“没有攻击”和“不可见” |
这些示例并非固定的安全标准数值。应在测量流量规模和正常基线后,根据组织情况设定阈值。
第一步:创建Prometheus警报规则
以下是一个实践示例,用于在10分钟内LLM请求的阻断率超过30%并持续5分钟时创建警报。实际的指标名称应与检测代码匹配。
groups:
  - name: llm-security
    interval: 30s
    rules:
      - alert: LlmSecurityBlockRateHigh
        expr: |
          sum(rate(llm_security_requests_total{decision="block"}[10m]))
          /
          sum(rate(llm_security_requests_total[10m]))
          > 0.30
        for: 5m
        labels:
          severity: warning
          service: llm-security-app
          team: ai-security
        annotations:
          summary: "LLM 보안 차단률이 지속적으로 높습니다"
          description: "대시보드에서 규칙별 증가와 관련 Trace를 확인하세요."
标签(Label)用于识别警报实例以及路由和静默。应使用稳定且有限的值,如severity、service、team。注解(Annotation)适用于响应者理解的描述和Runbook URL。不要在标签或注解中包含提示原文、用户输入、令牌或个人信息,因为通知可能会发送到外部即时通讯工具。
首先验证语法和规则文件是否已加载。
promtool check rules llm-security-alerts.yml
curl -s http://localhost:9090/api/v1/rules
“for”可以减少噪音,但也会造成检测延迟。致命的“阻断后工具执行”可能需要较短或没有Pending Period,而阻断率的暂时性增加则可能适合较长的持续时间。
第二步:在Alertmanager中分组并确定发送目的地
Alertmanager的路由(Route)是一个根据标签匹配器(Label Matcher)向下遍历的树。最顶层路由接收所有警报,下层路由根据team和severity选择接收器。
route:
  receiver: default-receiver
  group_by: [alertname, service, team]
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h
  routes:
    - receiver: ai-security-urgent
      matchers:
        - team="ai-security"
        - severity="critical"
    - receiver: ai-security-warning
      matchers:
        - team="ai-security"
        - severity="warning"

receivers:
  - name: default-receiver
  - name: ai-security-urgent
  - name: ai-security-warning
示例接收器中未包含实际的Webhook或邮件凭据。密钥应通过单独的密钥管理器或运行时文件注入,不应保留在存储库、博客或通知正文中。
三个时间选项各不相同:
- group_wait: 在发送新组的第一个通知前等待的时间
- group_interval: 已通知组中添加新警报后,到下一次通知的间隔
- repeat_interval: 再次通知相同触发警报的间隔
如果在group_by中包含用户ID、RequestId或TraceId,实际上每个警报都将成为一个单独的组,可能导致通知泛滥。紧急调查所需的TraceId应通过注解或Grafana链接有限地传递,并确认其敏感信息状态和访问权限。
分组、静默和抑制各不相同
分组(Grouping)将多个警报捆绑成一个通知。静默(Silence)会根据匹配器停止符合条件的警报通知一段预设时间,用于维护等有意的变更。抑制(Inhibition)则是在更高级别的根警报正在触发时,抑制由其导致的下级警报通知。
例如,如果发生ObservabilityPipelineDown,可以抑制数十个下级警报,如“LLM指标缺失”。然而,错误的抑制可能会隐藏重要的安全信号。源/目标匹配器和相等标签应设计得更精确并进行测试。
静默并不能解决警报。它只抑制通知,因此应记录结束时间、作者、变更操作和依据。无限期的静默可能会成为悄悄隐藏故障的开关。
第三步:在Grafana中将警报转换为调查路径
一个好的通知不会夸大结论,而是引导采取下一步行动。
무엇: LlmSecurityBlockRateHigh
어디: service=llm-security-app, environment=production
심각도: warning
언제부터: StartsAt
다음 행동: 차단 규칙별 Metric → 차단 Trace → 같은 TraceId의 Log
Runbook: 접근통제가 적용된 내부 URL
Grafana仪表盘应包含总请求率、阻断率、按规则的增长量和工具调用次数。警报注解或通知模板可以包含带有时间范围和服务标签的Grafana链接。接收链接的用户是否具有查看该租户的Loki、Tempo或Prometheus的权限,需要由各个数据源和网关再次检查。
使用Grafana Alerting时,要区分警报规则的Evaluation Interval、Pending Period和Keep Firing For。Pending用于检查条件是否持续一段时间,Keep Firing For则在条件暂时恢复正常时减少触发/解决反复(Flapping)。对于No Data和Error,也必须明确是将其视为正常还是触发单独的警报。
第四步:安全地使用合成警报进行全面测试
不要将测试通知直接发送到生产接收器。首先,使用本地Webhook接收器或测试通道。暂时将Prometheus表达式连接到安全的合成指标,或向Alertmanager API发送不含实际个人信息的测试警报。
验证项目如下:
- 是否在预期时间从Pending转换为Firing?
- 相同alertname、service、team的警报是否捆绑成一个通知?
- Warning和Critical是否发送到不同的接收器?
- Silence是否根据匹配器和结束时间正确工作?
- 上级故障警报是否仅抑制下级症状?
- Resolved通知是否发送到必要的接收方?
- 通知中是否不包含提示、响应、个人信息或密钥?
- 仪表盘中是否可以打开Loki、Tempo、Prometheus的调查路径?
运营中容易忽视的边界
Alertmanager本身也可能发生故障。在高可用性配置中,应查阅官方文档,确保Prometheus直接向所有Alertmanager实例发送警报。仅指向单个负载均衡器的配置与推荐行为不同。在网络分区情况下,宁愿选择部分重复而非遗漏警报的特性也应反映在响应流程中。
此外,通知通道是新的数据泄露途径。应最小化发送到外部SaaS的标签和注解,并实施Webhook签名、TLS、接收方白名单、密钥轮换和传输失败指标。警报设置更改权限和静默创建权限也应分离,并保留审计日志。
总结
一个好的警报系统并非频繁响铃的系统。Prometheus或Grafana应稳定评估条件,Alertmanager应将相关事件分组并发送给正确的团队,Grafana应提供从指标到追踪和日志的调查上下文。
在LLM安全中,优先关注持续的比例变化、阻断后的危险执行以及可观测性空白,而非单一阻断。标签应仅包含路由所需的最小上下文,详细原文和个人信息应从通知中排除。通过划分检测、路由和调查的职责,警报将成为启动响应的可靠信号,而非噪音。
官方资料
- Prometheus Alertmanager概念
- Alertmanager配置和路由
- Alertmanager高可用性
- Grafana Alerting概述
- Grafana警报规则评估
- Grafana警报标签和注解
- Grafana通知策略
※ 警报阈值、接收器和屏幕名称会因环境和产品版本而异。在投入运营前,请查阅官方文档和当前安装版本,并首先在测试接收器中进行验证。
类别: 云/prometheus
标签: Alertmanager, Grafana Alerting, Prometheus, LLM Security, Alert, Monitoring, Observability, Incident Response
发表回复