観測システムがどれほど多くのLog・Trace・Metricを収集しても、人間がダッシュボードを監視し続けなければ、危険を事前に通知することはできません。Alertは観測値が設定された条件を満たしたことを知らせる状態であり、NotificationはそのAlertをメール・メッセンジャー・呼び出しシステムなどの受信先に伝達した結果です。この二つを区別することで、「条件を検出する責任」と「誰にいつ通知するかを決定する責任」を分けることができます。
本稿では、LLMセキュリティ観測スタックにアラートを付与します。Prometheusがブロック率とエラー率を評価し、Alertmanagerが重複排除・グループ化・ルーティング・Silence・Inhibitionを実行し、Grafanaがアラートの状態と関連するMetric・Log・Traceを調査する画面を提供する流れです。Grafana-managed Alertingを使用する代替案も合わせて区別します。
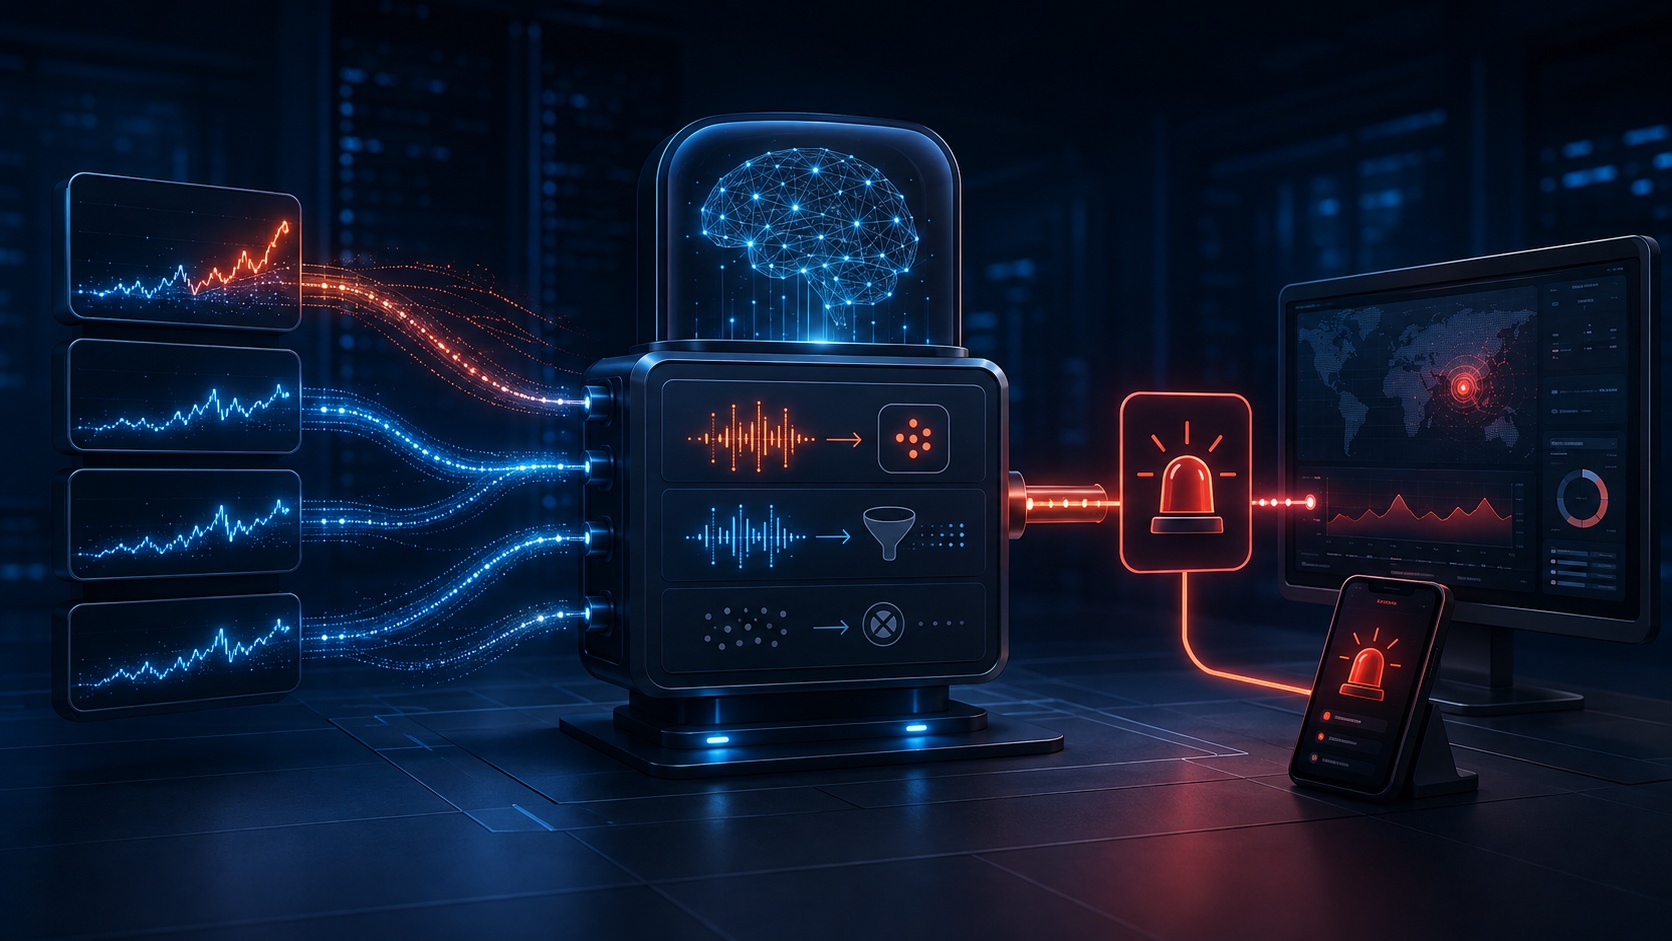
アラートパイプラインの責任をまず分けよう
Prometheus Alerting Ruleは、PromQL式を一定間隔で評価します。条件が一時的に真になったからといってすぐに人を起こさないように、for期間を設定できます。AlertmanagerはPrometheusのようなClientから送られたAlertを受け取り、同じ事象をまとめ、既に送信された通知を重複排除し、Labelに基づいてReceiverに送信します。
Grafanaは二つの役割を持つことができます。一つは、Prometheus・Alertmanagerの状態を視覚化し、関連データへ移動する観測画面です。もう一つは、Grafana-managed Alert Ruleを直接評価し、内蔵のGrafana AlertmanagerでNotification PolicyとContact Pointを運用するアラートプラットフォームです。一つの環境でこれら二つの方式を不用意に混ぜると、同じ条件が二度評価され、重複通知が発生する可能性があります。
| 構成 | ルール評価 | 通知ルーティング | 適切な場合 |
| — | — | — | — |
| Prometheus + 外部 Alertmanager | Prometheus | Alertmanager | Prometheus中心、ルールをファイル・Gitで管理 |
| Grafana-managed Alerting | Grafana | 組み込みGrafana Alertmanagerまたはサポートされる外部Alertmanager | 複数のデータソースのQuery・Expressionを一つの画面で管理 |
| 混合運用 | ルールごとに明示 | 経路ごとに明示 | 既存のPrometheusルールを維持しつつ、一部の多データソースアラートを追加 |
この記事の実践は最初の構造を基本とします。Grafanaは照会と調査に集中させます。
LLMセキュリティアラートは何を鳴らすべきか
すべてのブロックを緊急呼び出しにすると、通常の防御活動だけでもアラート疲労が発生します。まず、「人間が今介入しなければ被害が拡大するか?」を問いかけます。
| 信号 | 推奨処理例 | 理由 |
| — | — | — |
| プロンプトインジェクションブロック1件 | ダッシュボード・ログ記録 | 正常な防御成功である可能性 |
| ブロック率が基準線より継続的に増加 | 警告チャネル | 自動化攻撃またはポリシー誤検知の可能性 |
| ブロック後にツール呼び出し発生 | 緊急呼び出し候補 | Guardrail迂回または制御フローの欠陥の可能性 |
| 観測パイプライン収集停止 | 別途運用アラート | 「攻撃がない」と「見えない」を区別する必要がある |
この例は固定されたセキュリティ標準値ではありません。トラフィック規模と正常な基準線を測定した後、組織の状況に合わせて閾値を設定する必要があります。
ステップ1: Prometheus Alerting Ruleの作成
以下は、10分間のLLMリクエストのうちブロック率が30%を超え、その状態が5分間継続した場合にAlertを作成する実習例です。実際のMetric名は計測コードに合わせます。
groups:
  - name: llm-security
    interval: 30s
    rules:
      - alert: LlmSecurityBlockRateHigh
        expr: |
          sum(rate(llm_security_requests_total{decision="block"}[10m]))
          /
          sum(rate(llm_security_requests_total[10m]))
          > 0.30
        for: 5m
        labels:
          severity: warning
          service: llm-security-app
          team: ai-security
        annotations:
          summary: "LLM 보안 차단률이 지속적으로 높습니다"
          description: "대시보드에서 규칙별 증가와 관련 Trace를 확인하세요."
LabelはAlert Instanceを識別し、Routing・Silenceに使用されます。severity、service、teamのように安定的で制限された値を入れます。Annotationは対応者が理解するための説明やRunbook URLに適しています。プロンプト原文、ユーザー入力、トークンや個人情報をLabel・Annotationに入れないでください。通知は外部メッセンジャーに伝達される可能性があるためです。
まず、文法とルールファイルのロード状況を検証します。
promtool check rules llm-security-alerts.yml
curl -s http://localhost:9090/api/v1/rules
forはノイズを減らしますが、検出遅延も生じさせます。致命的な「ブロック後のツール実行」には短い、またはPending Periodがないことが必要となる場合があり、一時的なブロック率の増加にはより長い期間が適しています。
ステップ2: Alertmanagerでまとめて送信先を決定する
AlertmanagerのRouteは、Label Matcherに従って降りていくTreeです。最上位のRouteはすべてのAlertを受け取り、下位のRouteがteamとseverityに基づいてReceiverを選択します。
route:
  receiver: default-receiver
  group_by: [alertname, service, team]
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h
  routes:
    - receiver: ai-security-urgent
      matchers:
        - team="ai-security"
        - severity="critical"
    - receiver: ai-security-warning
      matchers:
        - team="ai-security"
        - severity="warning"

receivers:
  - name: default-receiver
  - name: ai-security-urgent
  - name: ai-security-warning
例示のReceiverには実際のWebhook・メール資格情報は含めていません。Secretは別途Secret Managerやランタイムファイルで注入し、リポジトリやブログ・通知本文に残さないでください。
三つの時間オプションはそれぞれ異なります。
- group_wait: 新しいグループの最初のNotificationを送信する前に待機する時間
- group_interval: 既に通知済みのグループに新しいAlertが追加された場合の次の通知までの間隔
- repeat_interval: 同じFiring Alertを再度通知する間隔
group_byにユーザーID・RequestId・TraceIdを入れると、事実上すべてのAlertが別々のグループとなり、通知の氾濫を引き起こす可能性があります。緊急調査に必要なTraceIdはAnnotationやGrafanaリンクで制限的に伝達し、機密情報であるか、アクセス権限があるかを確認します。
Grouping・Silence・Inhibitionはそれぞれ異なる
Groupingは複数のAlertを一つのNotificationにまとめます。SilenceはMatcherに合致するAlert通知を定められた時間停止します。点検作業のような意図的な変更に使用します。Inhibitionは、より大きな原因となるAlertがFiring中に、その結果として発生した下位Alertの通知を抑制します。
例えば、ObservabilityPipelineDownが発生した場合、「LLM Metricなし」のような下位Alert数十件をInhibitすることができます。ただし、誤ったInhibitionは重要なセキュリティ信号まで隠してしまう可能性があります。Source・Target Matcherとequal Labelを狭く設計し、テストする必要があります。
SilenceはAlertを解決しません。Notificationのみを抑制するため、終了時刻、作成者、変更作業と根拠を残します。無期限のSilenceは、障害を静かにするスイッチになる可能性があります。
ステップ3: Grafanaでアラートを調査経路に変換する
良いNotificationは結論を誇張せず、次の行動へと案内します。
무엇: LlmSecurityBlockRateHigh
어디: service=llm-security-app, environment=production
심각도: warning
언제부터: StartsAt
다음 행동: 차단 규칙별 Metric → 차단 Trace → 같은 TraceId의 Log
Runbook: 접근통제가 적용된 내부 URL
Grafana Dashboardには、全体の要求率、ブロック率、ルールごとの増加量、ツール呼び出し数を配置します。Alert AnnotationやNotification Templateには、時間範囲とサービスLabelを含むGrafanaリンクを含めることができます。リンクを受け取ったユーザーが、該当テナントのLoki・Tempo・Prometheusを閲覧する権限があるかは、各データソースとGatewayが再度検査する必要があります。
Grafana Alertingを使用する際は、Alert RuleのEvaluation Interval、Pending Period、Keep Firing Forを区別します。Pendingは条件が一定時間継続するかを確認し、Keep Firing Forは条件が一時的に正常に戻った際にFiring・Resolvedが繰り返されるFlappingを減らします。No DataとErrorも正常として扱うか、別途Alertとして作成するかを明示する必要があります。
ステップ4: 安全な合成アラートで最後まで試験する
運用Receiverに直接試験通知を送らないでください。まず、ローカルのWebhook Receiverやテストチャネルを使用します。Prometheus式を一時的に安全な合成Metricに接続するか、Alertmanager APIに実際の個人情報を含まないテストAlertを送信します。
検証項目は以下の通りです。
- PendingからFiringへ予想時間に移行するか
- 同じalertname、service、teamのAlertが1つのNotificationにまとめられるか
- WarningとCriticalが異なるReceiverへ送られるか
- SilenceがMatcherと終了時刻に合わせて動作するか
- 上位障害Alertが下位症状のみをInhibitするか
- Resolved Notificationが必要な受信先に伝達されるか
- Notificationにプロンプト・応答・個人情報・Secretが含まれていないか
- DashboardからLoki・Tempo・Prometheusの調査経路が開かれるか
運用で忘れがちな境界
Alertmanager自体も障害が発生する可能性があります。高可用性構成では、PrometheusがすべてのAlertmanager Instanceに直接Alertを送信するように公式ドキュメントを確認する必要があります。単純なLoad Balancer一つだけを指す構成は推奨される動作とは異なります。ネットワーク分割状況では、見逃された通知よりも一部の重複を選択する特性も対応手順に反映します。
また、Notification Channelは新たなデータ流出経路です。外部SaaSに送信するLabel・Annotationを最小限にし、Webhook署名・TLS・受信先Allowlist・Secretローテーション・送信失敗Metricを運用します。アラート設定変更権限とSilence作成権限も分離し、監査ログを残します。
まとめ
良いアラートシステムは、頻繁に鳴るシステムではありません。PrometheusやGrafanaが条件を安定的に評価し、Alertmanagerが関連する事象をまとめて正しいチームに伝達し、GrafanaがMetricからTraceとLogへと続く調査コンテキストを提供する必要があります。
LLMセキュリティでは、単一のブロックよりも継続的な比率変化、ブロック後の危険な実行、観測の空白に優先順位を置きます。Labelはルーティングに必要な最小限のコンテキストのみを含み、詳細な原文と個人情報はNotificationから除外します。検出・ルーティング・調査の責任を分けることで、アラートはノイズではなく、対応を開始させる信頼できる信号となります。
公式資料
- Prometheus Alertmanagerの概念
- Alertmanagerの設定とRoute
- Alertmanagerの高可用性
- Grafana Alertingの概要
- Grafana Alert Ruleの評価
- Grafana Alert LabelとAnnotation
- Grafana Notification Policy
※ アラート閾値、Receiver、画面名は環境と製品バージョンによって異なります。運用適用前に公式ドキュメントと現在のインストールバージョンを確認し、テストReceiverでまず検証してください。
カテゴリ: クラウド/prometheus
タグ: Alertmanager, Grafana Alerting, Prometheus, LLM Security, Alert, Monitoring, Observability, Incident Response
コメントを残す