大家好!今天我想和大家聊聊在Kubernetes环境中运行OpenTelemetry (OTel) Collector时,许多人遇到的一个隐藏瓶颈及其解决方案。
你是否有过这样的经历?🤔 明明部署了多个Collector Pod以确保可扩展性,但不知为何,流量却集中在某个特定的Pod上,导致负载过重。努力进行了scale-out,却完全没有效果,真是令人沮丧!
这个问题的根源在于gRPC与Kubernetes默认服务(Service)的负载均衡方式不匹配。今天,我们将清晰地解决这个问题,并深入探讨Deployment与Headless Service的组合,这将把你的OTel Collector打造成一个真正的分布式系统。🚀
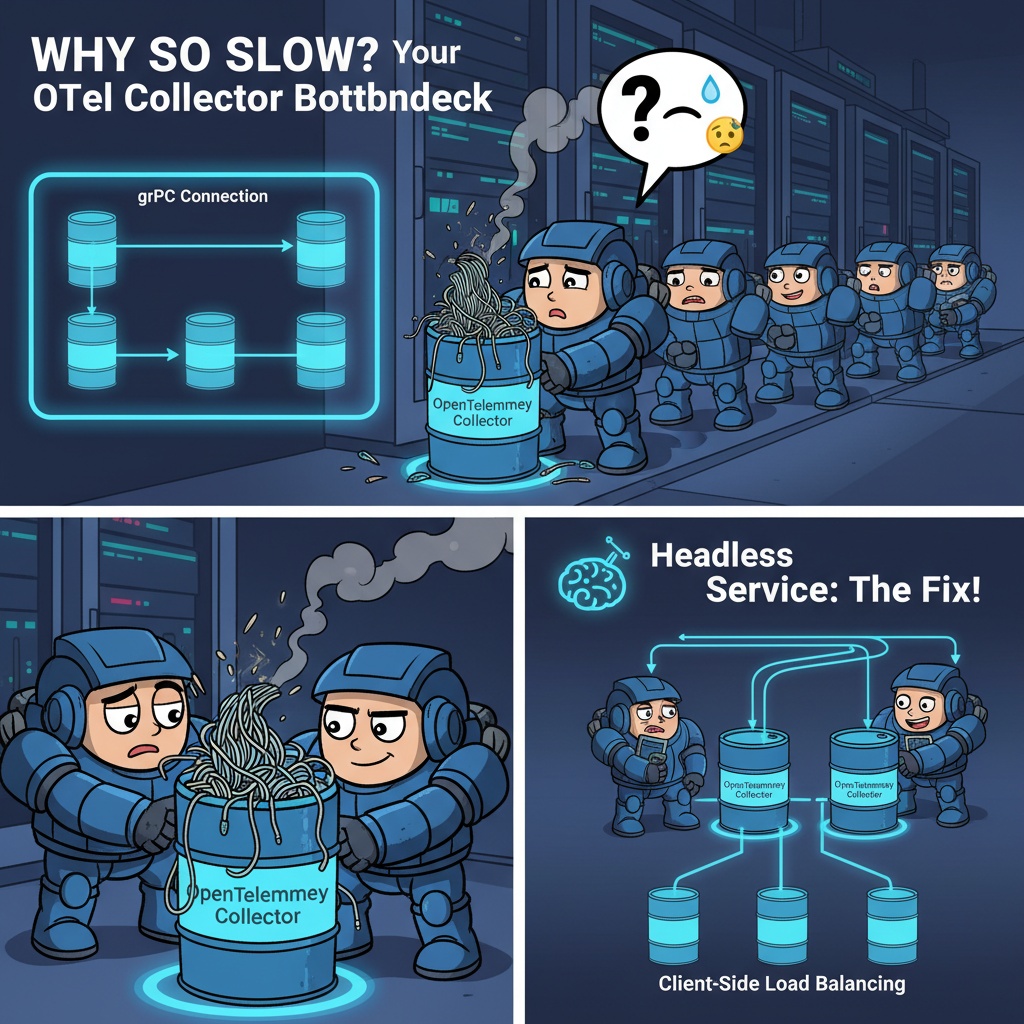
🤔 问题出在哪里?gRPC与ClusterIP服务的陷阱
通常,在Kubernetes中,当需要将多个Pod捆绑并对外暴露时,会使用Service。最基本的ClusterIP类型的Service会分配一个唯一的虚拟IP,并将发送到此IP的请求分发给其背后的Pod。
到目前为止,这看起来很完美。然而,OTel Collector使用的gRPC协议的特性引入了变数。
gRPC基于HTTP/2,其特点是建立一次TCP连接后会长时间保持并进行通信。但是,ClusterIP服务的负载均衡是在连接(Connection)级别进行的。
这意味着什么呢?
- 应用程序(客户端)尝试与OTel Collector服务的ClusterIP建立第一个连接。
- Kubernetes服务将此连接请求转发给多个Collector Pod中的一个。
- 一旦连接建立,gRPC会持续重用该连接,发送大量的遥测数据(请求)。
- 结果是,该客户端发送的所有数据都将涌向最初连接的那个Pod。 😱
最终,无论你增加多少Pod,负载都只会根据客户端的数量进行分散,实际流量并不会均匀分布,形成一种“徒有其表的分散”状态。
✨ 完美解决方案:Deployment + Headless Service
解决这个问题的最理想策略是同时使用Deployment和Headless Service。这种组合反向利用了gRPC的特性,让客户端直接执行负载均衡。
1. 使用Deployment管理Collector!🚀
Deployment是稳定运行无状态应用程序的核心控制器,它能保证Pod的数量(replicas)、滚动更新和自动恢复。通过Deployment管理OTel Collector,你可以根据流量大小调整replicas数量,实现灵活的扩展/缩减。这是最基本的原则!
# otel-collector-deployment.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: otel-collector
  labels:
    app: opentelemetry
    component: collector
spec:
  # 🔽 根据需要调整Pod数量,例如3个、5个!
  replicas: 3
  selector:
    matchLabels:
      app: opentelemetry
      component: collector
  template:
    metadata:
      labels:
        app: opentelemetry
        component: collector
    spec:
      containers:
      - name: otel-collector
        image: otel/opentelemetry-collector-contrib:latest # 使用适合实际环境的镜像版本
        ports:
        - name: grpc
          containerPort: 4317
          protocol: TCP
2. 负载均衡的核心,Headless Service!🧠
Headless Service与ClusterIP服务不同,它不拥有唯一的虚拟IP。相反,当查询服务的DNS名称时,它会返回与该服务关联的所有Pod的实际IP地址列表。
这如何发挥魔力呢?
- 创建Headless Service。(
clusterIP: None设置是关键!) - 应用程序的OTel SDK将Headless Service的DNS名称(otel-collector-headless:4317)设置为Collector的端点。
- SDK内的gRPC库会查询这个DNS名称,并获得3个Pod的完整IP地址列表。
- gRPC客户端利用这个IP列表,根据round_robin等策略,直接将每个请求(Request)分发到不同的Pod。
现在,不再是连接级别的负载均衡,而是真正的请求级别的负载均衡成为可能!
以下是定义Headless Service的YAML文件。
# otel-collector-headless-svc.yaml
apiVersion: v1
kind: Service
metadata:
  name: otel-collector-headless
  labels:
    app: opentelemetry
    component: collector
spec:
  # 🔽 这一项设置改变一切!
  clusterIP: None
  selector:
    # 选择由Deployment管理的Pod。
    app: opentelemetry
    component: collector
  ports:
    - name: grpc
      port: 4317
      targetPort: 4317
      protocol: TCP
应用程序如何配置?
只需在应用程序代码或环境变量中,将OTel exporter的端点指定为Headless Service的DNS地址即可。
- 端点地址:
otel-collector-headless:4317(如果位于同一命名空间) - 或FQDN:
otel-collector-headless..svc.cluster.local:4317
通过这个简单的配置更改,你的系统将开始更智能地分发负载。
🤔 为什么其他方法不太理想?
1. DaemonSet 🧐
DaemonSet是一种在集群所有(或特定)节点上部署一个Pod的方式。它适用于收集每个节点的日志或指标的“代理”角色,但不适用于将多个应用程序数据汇集到一处的“网关”角色。
- 问题:可扩展性受限于节点数量。无论流量如何增加,只要不增加节点,就无法增加Collector的数量,容易成为瓶颈。
2. Service Mesh (Istio, Linkerd等) 🕸️
使用服务网格可以在不修改应用程序代码的情况下透明地实现gRPC负载均衡。这无疑是一个强大的功能。
- 问题:过于笨重。为了解决OTel Collector的负载均衡问题而引入服务网格这样一个庞大的系统,是杀鸡用牛刀。除非你的环境已经全公司范围使用服务网格,否则这是一个过度解决方案。
结语
在Kubernetes这样的分布式环境中,深入理解每项技术的特性并找到最佳组合至关重要。对于OpenTelemetry Collector和gRPC,通过Deployment确保灵活的可扩展性,并通过Headless Service激活客户端侧负载均衡是最有效、最简单且最强大的方法。
不要再让一个Collector Pod独自辛苦工作了。应用这种架构,构建一个稳定且高可扩展性的可观测性管道吧!💪
发表回复