こんにちは!今日は、Kubernetes環境でOpenTelemetry(OTel)Collectorを運用する際に多くの方が経験する隠れたボトルネックとその解決策についてお話したいと思います。
もしかして、こんな経験はありませんか?🤔 Collectorポッドを複数立ち上げてスケーラビリティを確保したはずなのに、なぜか特定のポッドにだけトラフィックが集中し、負荷が重くなる現象。一生懸命スケールアウトしたのに、全く効果が見られないというもどかしい状況!
この問題の原因は、まさにgRPCとKubernetesの基本サービス(Service)のロードバランシング方式の不一致にあります。今日はこの問題を明確に解決し、あなたのOTel Collectorを真の分散システムにするためのDeploymentとHeadless Serviceの組み合わせについて深く掘り下げていきます。🚀
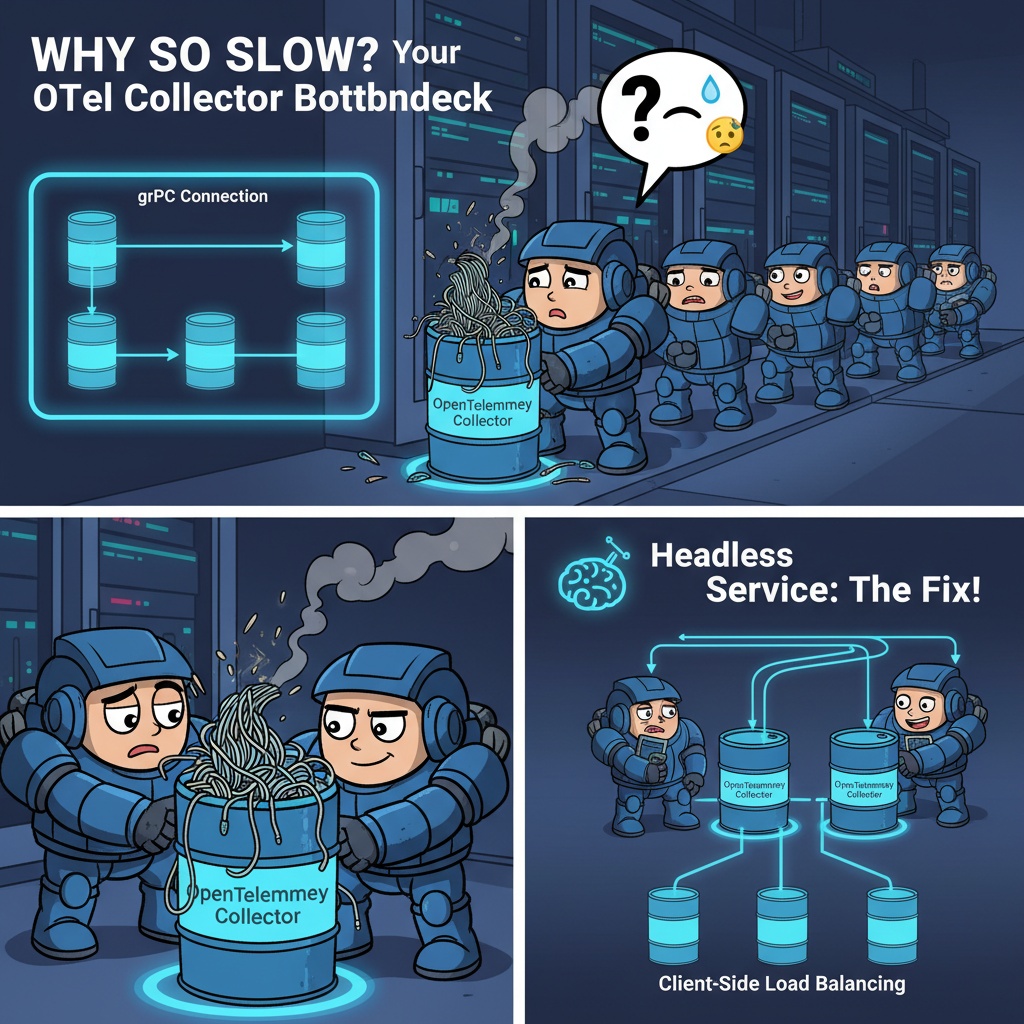
🤔 何が問題なのか?gRPCとClusterIPサービスの落とし穴
一般的にKubernetesでは、複数のポッドをまとめて外部に公開する際にServiceを使用します。最も基本的なClusterIPタイプのサービスは、固有の仮想IPを割り当てられ、このIPに来るリクエストを背後にあるポッドに分配します。
ここまでは完璧に見えます。しかし、OTel Collectorが使用するgRPCプロトコルの特性が変数を生み出します。
gRPCはHTTP/2ベースで、一度確立したTCP接続を長時間維持して通信する特徴があります。しかし、ClusterIPサービスのロードバランシングは接続(Connection)レベルで行われます。
これは何を意味するのでしょうか?
- アプリケーション(クライアント)がOTel CollectorサービスのClusterIPに最初の接続を試みます。
- Kubernetesサービスはこの接続要求を複数のCollectorポッドのうち一つに転送します。
- 一度接続が確立されると、gRPCはその接続を再利用し続け、数多くのテレメトリーデータ(リクエスト)を送信します。
- 結果として、当該クライアントが送信するすべてのデータは、最初に接続された単一のポッドにのみ集中することになります。 😱
結局、ポッドをいくら増やしても、クライアントの数だけ負荷が分散されるだけで、実際のトラフィックが均等に分散されない「見せかけだけの分散」状態になってしまうのです。
✨ 完璧な解決策:Deployment + Headless Service
この問題を解決するための最も理想的な戦略は、DeploymentとHeadless Serviceを一緒に使用することです。この組み合わせはgRPCの特性を逆手に取り、クライアントが直接ロードバランシングを実行するようにします。
1. Collectorの管理はDeploymentで! 🚀
Deploymentは、ポッドの数(replicas)を保証し、ローリングアップデート、自動復旧など、ステートレスなアプリケーションを安定的に運用するための核となるコントローラーです。OTel CollectorをDeploymentで管理することで、トラフィック量に応じてreplicas数を調整し、柔軟にスケールアウト/インできます。これは基本中の基本です!
# otel-collector-deployment.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: otel-collector
  labels:
    app: opentelemetry
    component: collector
spec:
  # 🔽 必要に応じてポッドの数を3つ、5つなどに調整してください!
  replicas: 3
  selector:
    matchLabels:
      app: opentelemetry
      component: collector
  template:
    metadata:
      labels:
        app: opentelemetry
        component: collector
    spec:
      containers:
      - name: otel-collector
        image: otel/opentelemetry-collector-contrib:latest # 実際の環境に合ったイメージバージョンを使用してください
        ports:
        - name: grpc
          containerPort: 4317
          protocol: TCP
2. ロードバランシングの核心、Headless Service! 🧠
Headless Serviceは、ClusterIPサービスとは異なり、固有の仮想IPを持ちません。代わりに、サービスのDNS名を照会した際に、当該サービスに接続されたすべてのポッドの実際のIPリストを返します。
これがどのように魔法をかけるのでしょうか?
- Headless Serviceを作成します。(
clusterIP: None設定が重要!) - アプリケーションのOTel SDKは、CollectorエンドポイントとしてHeadless ServiceのDNS名(otel-collector-headless:4317)を設定します。
- SDK内のgRPCライブラリはこのDNS名を照会し、3つのポッドのIPアドレスリスト全体を受け取ります。
- gRPCクライアントはこのIPリストを使い、round_robinのようなポリシーに従って各リクエスト(Request)ごとに異なるポッドに直接リクエストを分散させます。
これで、接続レベルではなく、真のリクエストレベルのロードバランシングが可能になります!
以下はHeadless Serviceを定義するYAMLファイルです。
# otel-collector-headless-svc.yaml
apiVersion: v1
kind: Service
metadata:
  name: otel-collector-headless
  labels:
    app: opentelemetry
    component: collector
spec:
  # 🔽 この設定一つがすべてを変えます!
  clusterIP: None
  selector:
    # Deploymentが管理するポッドを選択します。
    app: opentelemetry
    component: collector
  ports:
    - name: grpc
      port: 4317
      targetPort: 4317
      protocol: TCP
アプリケーションの設定はどうする?
アプリケーションコードや環境変数でOTelエクスポーターのエンドポイントをHeadless ServiceのDNSアドレスに指定するだけで済みます。
- エンドポイントアドレス:
otel-collector-headless:4317(同じネームスペースの場合) - またはFQDN:
otel-collector-headless..svc.cluster.local:4317
この簡単な設定変更だけで、あなたのシステムははるかに賢く負荷を分散し始めるでしょう。
🤔 他の方法はなぜあまり良くないのか?
1. DaemonSet 🧐
DaemonSetは、クラスターのすべての(または特定の)ノードにポッドを1つずつデプロイする方式です。各ノードのログやメトリックを収集する「エージェント」の役割には適していますが、複数のアプリケーションのデータを一箇所に集める「ゲートウェイ」の役割には不適切です。
- 問題点: スケーラビリティがノード数に縛られます。トラフィックがいくら増えてもノードを増設しない限りCollectorの数を増やすことができず、ボトルネックになりやすいです。
2. Service Mesh (Istio, Linkerdなど) 🕸️
サービスメッシュを使用すると、アプリケーションコードの修正なしにgRPCロードバランシングを透過的に実装できます。確かに強力な機能です。
- 問題点: 重すぎます。OTel Collectorのロードバランシング問題一つを解決するために、サービスメッシュという巨大なシステムを導入するのは、費用対効果が低い(「船頭多くして船山に上る」)です。すでにサービスメッシュを全社的に使用している環境でない限り、過度な解決策です。
まとめ
Kubernetesのような分散環境では、各技術の特性を深く理解し、最適な組み合わせを見つけることが重要です。OpenTelemetry CollectorとgRPCの場合、Deploymentで柔軟なスケーラビリティを確保し、Headless Serviceでクライアント側ロードバランシングを有効にするのが最も効率的で、シンプルかつ強力な方法です。
もう一つのCollectorポッドだけが苦労して働くのをやめましょう。このアーキテクチャを適用して、安定的でスケーラビリティの高いオブザーバビリティパイプラインを構築してください! 💪
コメントを残す