大家好!今天,我将深入探讨在Kubernetes(K8s)运营环境中被称为“标准”的架构。
初次接触Kubernetes时,人们可能只是简单地通过NodePort或LoadBalancer类型将服务暴露到外部。但在实际的生产(运营)环境中,为什么将单独的边缘节点(Edge Node)和内部的服务网格(Service Mesh)配置起来才是最佳实践呢?
我将解释其原因,并全面梳理这种结构所解决的顽固网络问题。🚀
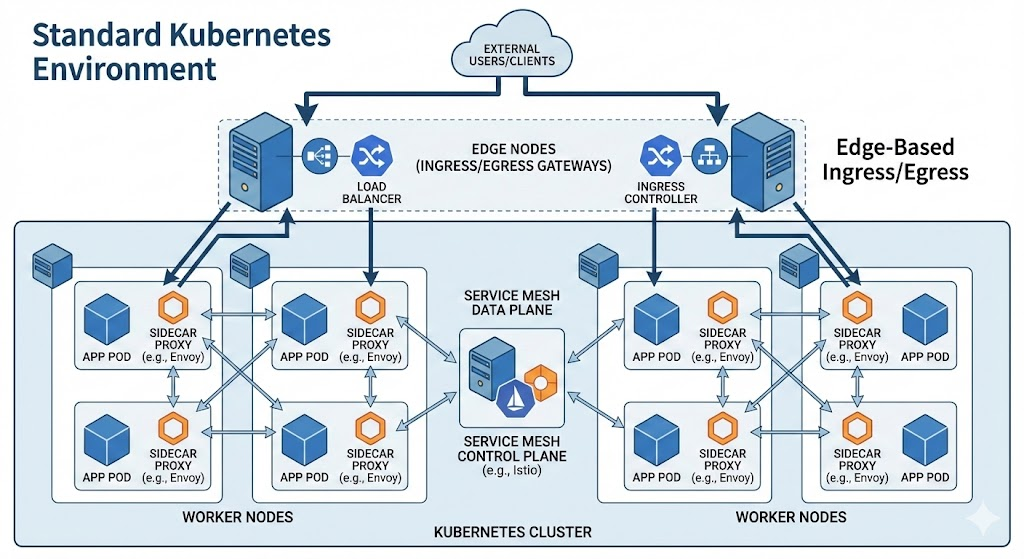
🏗️ 标准架构:边缘节点与服务网格的结合
现代Kubernetes运营环境主要分为两个明确的区域:
- 边缘节点 (城门 🏰): 外部流量进入的唯一入口
- 服务网格 (内部路网 🛣️): 内部服务(Pod)之间安全高效的通信网络
这种结构并非仅仅为了美观,而是为了实现安全性、稳定性、可见性这三个目标而设计的。
1. 流量的明确分离 (North-South vs East-West)
- North-South流量 (外部 ↔️ 内部): 用户访问我们服务的流量。这由位于边缘节点上的Ingress Controller(或Gateway)专门负责。它通过不将实际运行应用程序的工作节点直接暴露到互联网来最大化安全性。
- East-West流量 (内部 ↔️ 内部): 微服务之间交换数据的流量。这由服务网格(例如:Istio, Linkerd)负责处理复杂的通信逻辑。
2. 零信任(Zero Trust)安全 🛡️
“不要因为在内部网络就信任它!”
这是该架构的核心理念。
- mTLS加密: 服务网格自动加密内部通信。即使黑客入侵,也无法窃听数据。
- 细粒度权限控制: 可以在基础设施层面而非代码层面强制执行“订单服务只能访问支付服务”之类的策略。
💡 核心:解决NodePort的顽固问题
许多人采用这种架构的决定性原因,正是为了解决传统NodePort方式固有的网络效率低下和安全问题。
问题 1: 流量像乒乓球一样跳来跳去? (流量跳跃现象) 🏓
- NodePort情况: 如果客户端向节点A发送请求,但实际的Pod在节点B上,那么流量必须通过Kubernetes内部网络(kube-proxy)从节点A → 节点B再移动一次。这会导致不必要的延迟(Latency)。
- 边缘节点解决方案 (智能路由): 边缘节点的Ingress Controller已经知道所有Pod的位置。一旦收到请求,它会直接将其路由到相应的Pod所在的节点。消除了不必要的跳跃,从而加快了速度。
问题 2: 客户的真实IP消失了? (源IP丢失) 🕵️♂️
- NodePort情况: 当流量在节点之间跳转时(SNAT),数据包的源IP会变为节点的IP。查看应用程序日志时,所有请求都看起来像是来自内部IP,因此无法识别实际用户是谁,也无法知道他们从何处连接。
- 边缘节点解决方案 (IP保留):
- L4层面: 通过边缘节点设置(externalTrafficPolicy: Local)来保留传入流量的原始IP。
- L7层面: 当Ingress将流量转发到后端时,会在X-Forwarded-For头部添加一个标签,说明**“这是由原始发送者发送的”**。这样,应用程序就能准确识别用户的真实IP。
📝 总结:为何这是“标准”?
| 类别 | NodePort / 简单配置 | 边缘节点 + 服务网格 (标准) |
| — | — | — |
| 安全性 | 工作节点暴露在外部 (危险 ⚠️) | 入口单一化,易于防御和控制 (安全 🔒) |
| 流量路径 | 节点间跳跃,产生延迟 (Hop) | 直达Pod的最佳路径 (Direct) |
| 客户端IP | 变为节点IP,无法识别 | 通过头部等方式可识别真实IP |
| 故障应对 | 故障发生时,存在连锁错误风险 | 通过断路器隔离和阻止故障 |
最终,这种架构实现了云原生的理想:“开发者只专注于业务逻辑,复杂的网络和安全由基础设施自动处理。”
虽然初次构建需要一些努力,但考虑到运营阶段的稳定性和调试便利性,它不仅仅是一个选项,更是一种必需。您的集群现在是什么样子呢? 🤔
发表回复