每当有新的AI模型发布时,总会伴随着“目前性能最好的AI是什么?”这个问题。然而,搜索后会发现,有些网站将Claude排在第一,另一些网站则显示GPT或Gemini领先,而在编程排名中,又会出现其他模型位居前列。
这种差异并非因为某个网站有误。而是因为让人选择更满意答案的评估、自动批改有正确答案问题的评估,以及解决实际GitHub问题的代理评估,它们衡量的是不同的能力。
本文将根据评估方式,整理截至2026年7月31日广泛使用的AI性能比较网站。我们还将探讨如何根据自身用途筛选出有用的信号,而不是盲目相信排行榜上的数字。
首先结论:没有一个“全球AI综合排名”
AI模型具有多种难以用单一考试成绩来表达的属性。
- 在日常对话中,它是否能生成人们偏爱的答案?
- 它是否能正确回答数学、科学和推理问题?
- 它是否能修复实际软件仓库中的错误?
- 响应速度快且API成本合理吗?
- 能否下载权重并部署到内部环境?
- 能否稳定处理长文档、图像和工具调用?
因此,“AI第一”的说法必须附带评估标准。对话偏好第一、编程代理第一、性价比第一可能是不同的模型。
最实用的方法不是只看一个网站的综合分数,而是根据目的交叉核对两三个评估结果。
AI性能比较网站一览
| 网站 | 主要衡量内容 | 评估方式 | 最适合的问题 | 注意事项 |
| — | — | — | — | — |
| Arena | 实际用户对答案的偏好 | 匿名模型间1:1比较和人工投票 | 人们更喜欢哪个聊天机器人答案? | 可能混杂文风和答案长度的影响 |
| Artificial Analysis | 智能、速度、延迟、价格、上下文 | 多项基准测试和API实测 | 如何综合比较质量、成本和速度? | 需确认综合指数的构成和执行设置 |
| LiveBench | 最新选择题·问答题能力 | 新问题和客观自动评分 | 减少学习数据污染影响的推理性能如何? | 不代表完整的实际对话体验 |
| SWE-bench | 解决实际仓库问题的能力 | 代码代理创建补丁并运行测试 | 编程代理能否修复实际错误? | 不仅受模型影响,代理结构和工具设置影响也很大 |
| Hugging Face Leaderboards | 公开权重模型和领域评估 | 公开数据集·可复现的评估流程 | 如何比较可直接部署的开源模型? | 过去的Open LLM Leaderboard已终止,各排行榜目的不同 |
此表中重要的部分是“评估方式”。即使显示相同的模型名称,如果提示词、推理强度、工具使用、采样设置和提供的API不同,结果也可能不同。
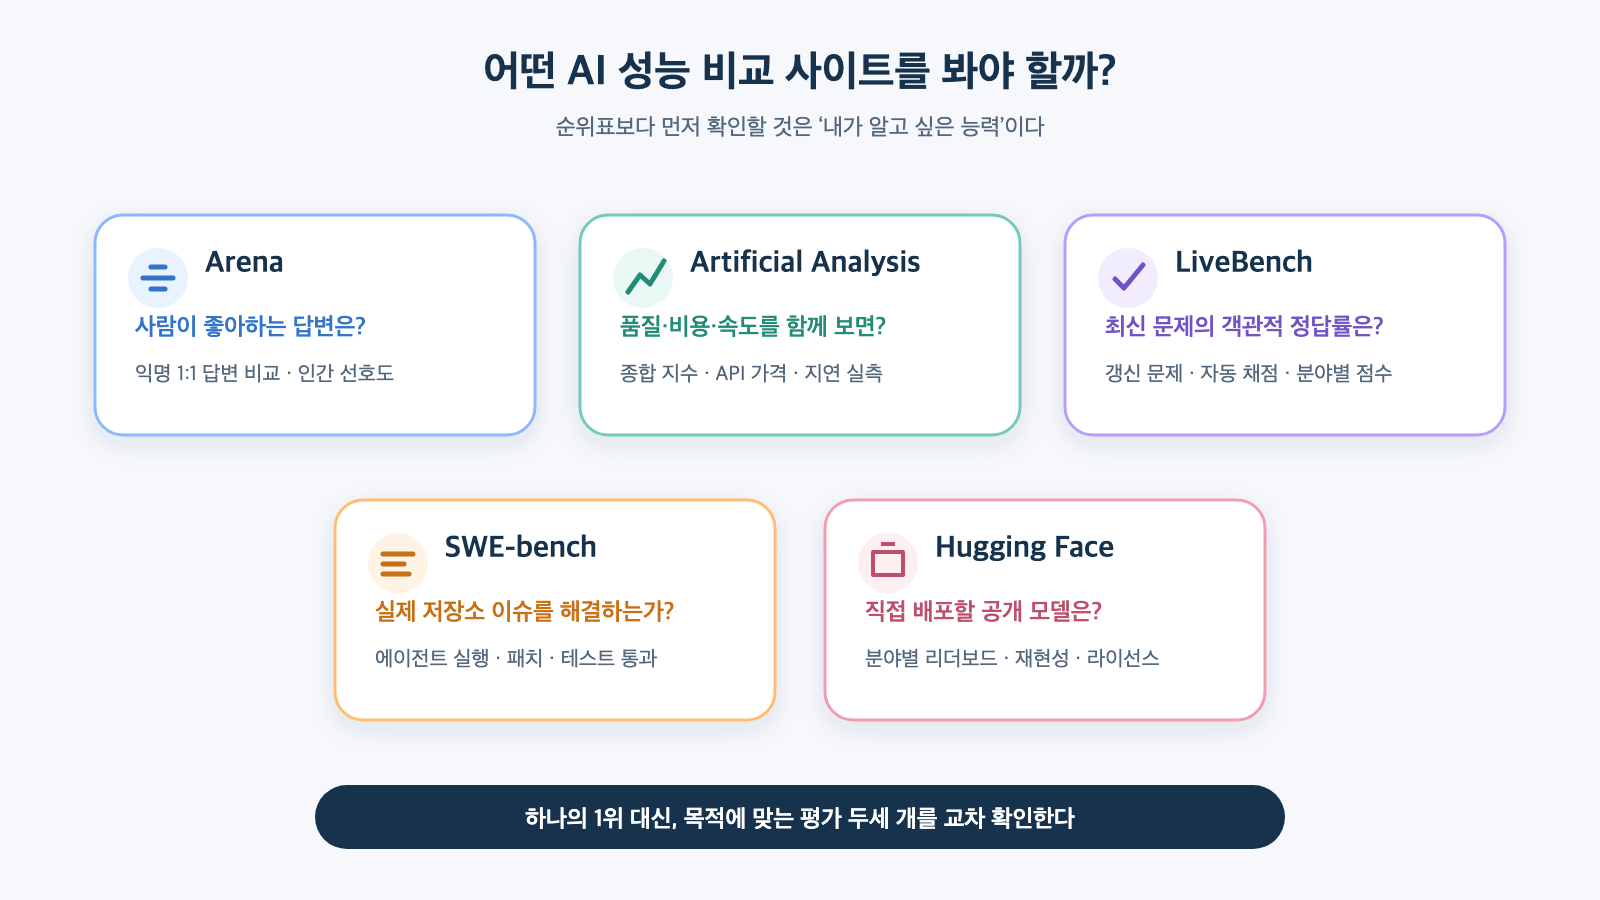
图:根据所需AI能力选择比较网站指南 · 基于Arena、Artificial Analysis、LiveBench、SWE-bench、Hugging Face Leaderboards重构
1. Arena — 比较人们实际偏好的答案
Arena在隐藏两个模型名称的情况下,展示对同一问题的答案,并让用户选择更好的答案。通过累积这些匿名1:1对决的结果,计算模型的相对排名。
这种方法的优点是它反映了实际用户体验,这是固定考试问题难以捕捉的。人们感受到的因素,如解释的自然度、指令遵循、写作质量和对话流畅度,都包含在投票中。
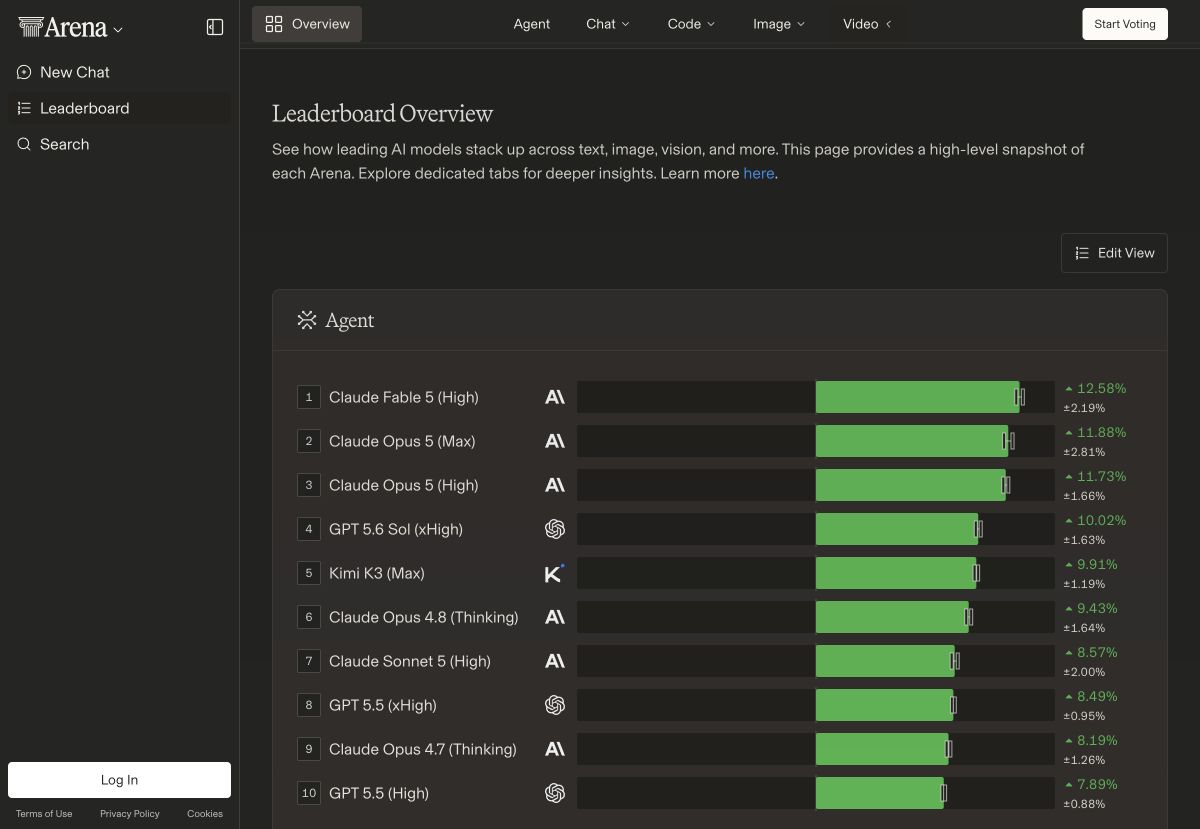
截图:Arena Leaderboard Overview的代理排名 · 截至2026年7月31日 · Arena官方排行榜
Arena排名在以下情况下特别有用:
- 比较通用聊天机器人的整体答案满意度时
- 寻找写作和解释能力重要的模型时
- 查看新发布模型与现有模型相比获得何种反响时
- 不仅是文本,还可查看视觉·搜索等详细Arena时
然而,人的偏好并不等同于事实准确性或业务成功率。答案冗长、结构华丽可能会获得比实际内容更好的评价。Arena研究人员也分析指出,如果控制答案长度和Markdown使用等风格要素,排名可能会发生变化。
因此,Arena在“人们更喜欢哪个答案?”方面很强,但作为“哪个模型能更准确地解决数学问题或修复更多实际仓库错误?”的唯一依据则不足。
2. Artificial Analysis — 在一个屏幕上查看性能、成本和速度
Artificial Analysis不仅比较模型的智能分数,还比较API价格、输出速度、首个token延迟时间、总响应时间以及上下文窗口。
截至2026年7月,Intelligence Index v4.1结合了知识任务、工具使用、终端编程、科学推理、幻觉抑制、长上下文推理等多项评估。网站提供综合分数和各项评估结果,因此不仅可以查看平均值,还可以确认具体优势。
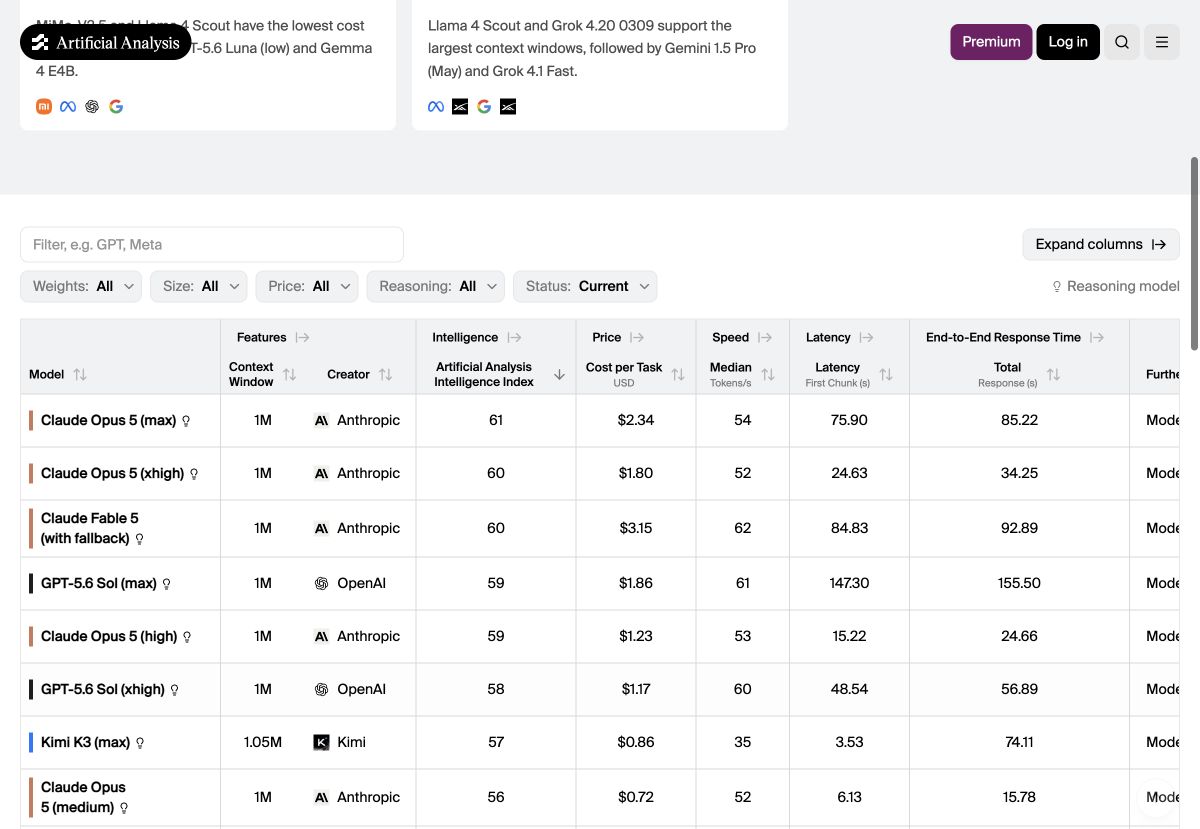
截图:各模型Intelligence Index、每任务成本、速度、延迟时间比较 · 截至2026年7月31日 · Artificial Analysis官方排行榜
Artificial Analysis最大的优点是能将模型引入与实际产品决策相结合。即使是得分最高的模型,如果响应过慢或每任务成本过高,也可能不适合大规模服务。
建议同时查看以下项目:
- Intelligence Index: 结合多种能力的质量指标
- 个别评估: 编程·知识·推理·代理等与业务相关的详细分数
- Cost per Task: 处理一项实际评估任务所花费的成本
- Output Speed: 首个响应后每秒生成的token数量
- Time to First Answer Token: 包括推理时间在内,首个答案出现前的延迟
- End-to-End Response Time: 接收一定长度答案所需的时间
- Context Window: 输入和输出合计可处理的最大token范围
如果计划开发基于API的服务,该网站对于寻找“在我们的服务可承受的延迟和成本范围内,提供最高质量的模型”比仅看综合排名更有用。
3. LiveBench — 通过最新问题减少数据污染
LiveBench旨在减少基准测试问题被包含在训练数据中导致分数虚高的问题。它从最近的数学竞赛、论文、新闻、数据集等中构建问题,并以有正确答案的方式自动评分。
目前,该网站提供推理、编程、代理编程、数学、数据分析、语言、指令遵循等多个独立类别。不仅可以查看模型的总分,还可以查看子任务和每成功任务的成本。
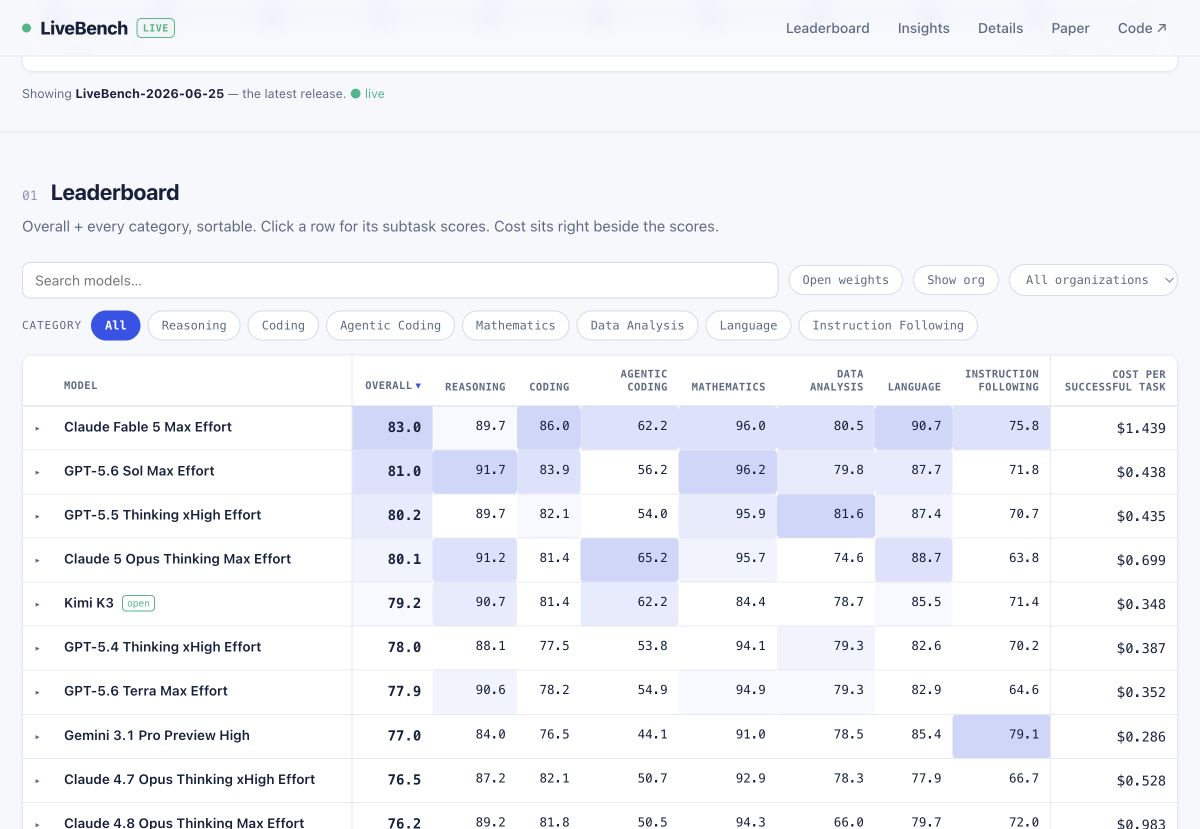
截图:LiveBench最新版本各领域分数和每成功任务成本 · 截至2026年7月31日 · LiveBench官方排行榜
LiveBench有用的原因如下:
- 减少模型可能已学习旧的著名考试问题的可能性
- 优先客观正确答案而非人类或其他LLM的主观评分
- 不仅可以查看整体平均值,还可以确认各领域性能差异
- 可以在同一类别中比较开源模型和非公开商业模型
然而,客观评分最新问题并不完全等同于实际业务的再现。客户咨询的同理心、长项目中的上下文维护、在公司内部文档中查找依据的RAG质量等因素需要单独的实验。
最好将LiveBench作为衡量“解决新问题准确性”的强信号,而可用性评估则通过Arena或内部业务测试进行补充。
4. SWE-bench — 评估的是编程代理系统而非模型本身
SWE-bench提供实际开源仓库的问题和代码状态,评估AI能否分析问题、创建补丁并成功通过测试。
代表性的SWE-bench Verified由500个人工审查的问题组成。还有Multilingual, Lite, Full, Multimodal等不同目的的子排行榜,因此在比较结果时,应首先确认是否查看的是相同的数据集。
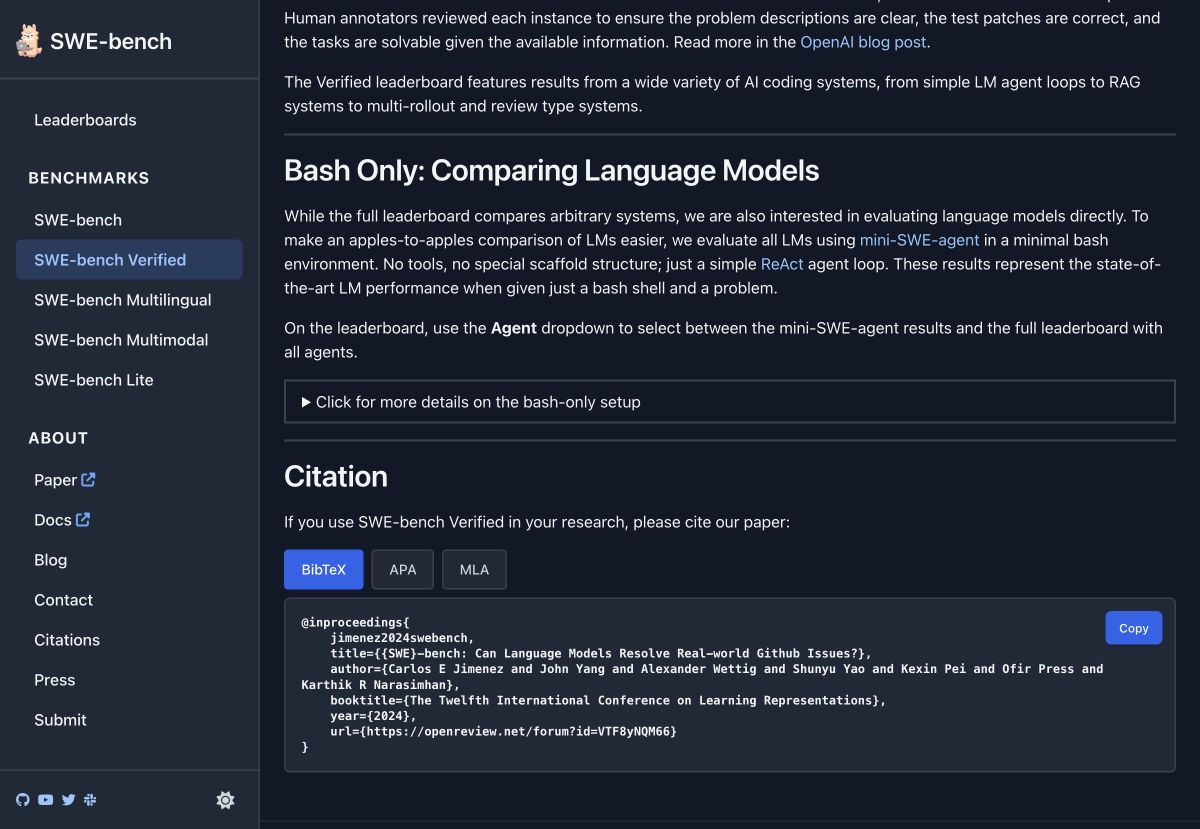
截图:SWE-bench Verified官方结果表中的解决率、平均成本、代理版本 · 截至2026年7月31日 · SWE-bench官方排行榜
SWE-bench分数更接近实际软件开发任务,而非简单的代码生成能力。
이슈 설명 읽기
→ 저장소 탐색
→ 관련 코드와 테스트 분석
→ 수정안 작성
→ 테스트 실행
→ 실패 원인 확인과 재수정
→ 최종 패치 제출
这里重要的一点是,排行榜上的一行可能并非模型单独的性能。即使是同一个模型,其分数也可能因所使用的代理框架、搜索·编辑·测试工具的提供方式、最大成本和迭代次数的设置而异。
选择编程工具时,应同时确认以下几点:
- 是否是相同的SWE-bench子数据集?
- 模型和代理版本是否一致?
- 工具调用和迭代次数限制是什么?
- 每个问题的成本和执行时间是多少?
- 提交结果是否经过官方验证?
SWE-bench是比较编程AI的核心资料,但其分数不应被解读为“语言模型的纯粹智能”,而应解读为“模型·提示词·工具·代理相结合的系统的成功率”。
5. Hugging Face Leaderboards — 开源模型应查看领域排行榜
Hugging Face的Leaderboards文档提供了在Hub上评估公开模型和数据集并构建排行榜的方法。它可以记录模型权重、精确修订版本、精度和评估设置,这在重视可复现性和直接部署可能性时非常有用。
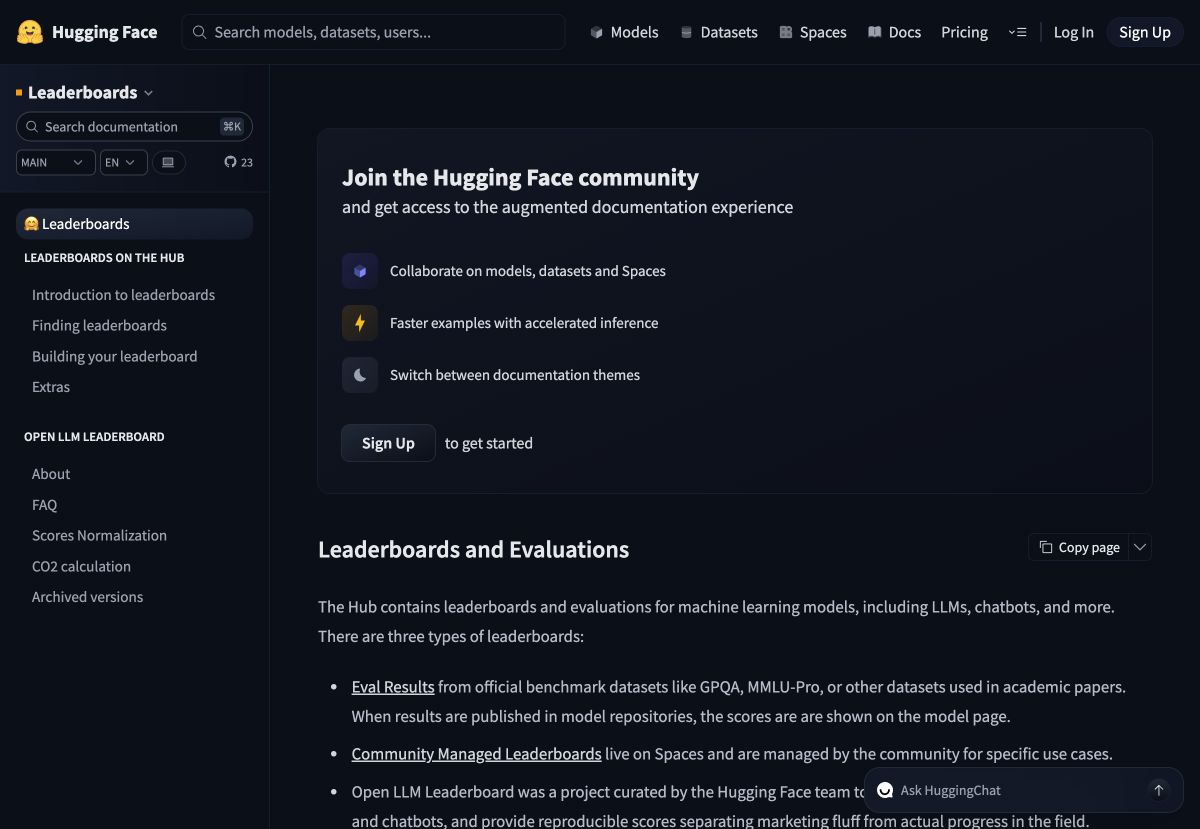
截图:Hugging Face Hub的评估结果、社区排行榜、Open LLM Leaderboard区分 · 截至2026年7月31日 · Hugging Face Leaderboards官方文档
这里有一个必须了解的变化。广为人知的Hugging Face Open LLM Leaderboard已于2025年3月正式终止。运营方解释说,尽管他们在两年内评估了超过1.3万个模型,但随着推理模型和助手的进步,现有评估逐渐无法准确反映当前能力。
因此,现在不应寻找一个统一的“Hugging Face排名”表,而应根据目的选择社区排行榜。
- 公开权重通用语言模型
- 编程模型
- 韩语·多语言模型
- 视觉语言模型
- 嵌入·重排序模型
- 特定领域或自定义数据集评估
在内部部署开源模型时,除了排名,还应同时确认许可证、模型大小、活跃参数、所需GPU内存、量化支持、上下文长度和商业使用限制。
为什么每个网站的排名第一都不同?
每个网站排名第一不同的原因在于评估对象和评分过程不同。
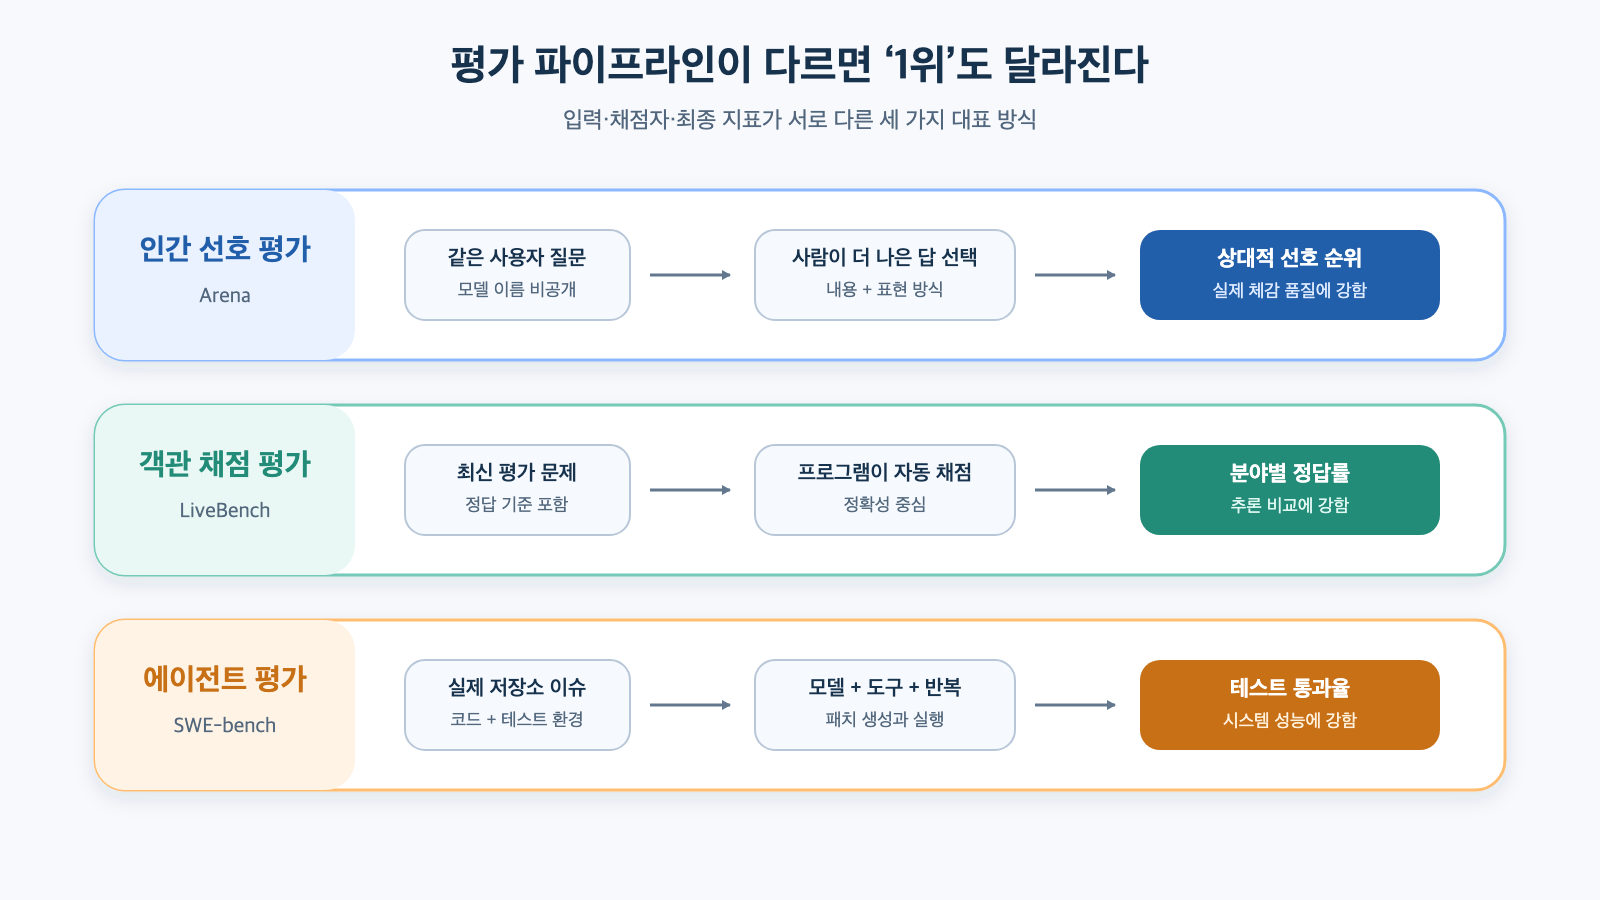
图:人类偏好·客观评分·代理评估的输入、评分和最终指标差异 · 基于Arena研究、LiveBench研究、SWE-bench重构
人的喜好与正确率不同
在Arena中,自然友好的答案可能会获得更高的偏好。而LiveBench则要求最终答案准确才能得分。一个看起来不错但错误的答案在选择题基准测试中无法获得高分。
模型设置不同
即使是同一个模型,其结果也会因推理强度、温度、系统提示词和工具使用情况而异。不能仅仅因为模型名称相同就假定它们在相同条件下进行了评估。
模型与代理不同
在SWE-bench这样执行多个步骤的评估中,不仅模型,负责文件搜索、代码编辑、测试执行和错误恢复的代理结构也对性能有很大影响。
评估时间点不同
商业API模型可能会以相同的名称进行更新,并且各个排行榜反映新模型速度也不同。应确认分数旁边的模型版本和评估日期。
存在基准测试污染和优化
如果公开的考试问题被包含在训练数据中,或者开发商根据特定基准测试调整模型,那么分数可能会高于实际的泛化性能。LiveBench更新问题的原因也在此。
阅读排行榜时务必确认的8件事
- 衡量的是什么:偏好度、准确性、编程成功率还是速度?
- 谁在评分:人类、基于正确答案的程序还是LLM评审员?
- 模型设置是否相同:推理强度和工具使用条件是否一致?
- 是否有版本和日期:比较的是具体版本而非模型别名吗?
- 样本和置信区间是否充足:微小的分数差异是否具有统计学意义?
- 是否包含成本:最高分是否在实际预算内可持续?
- 是否区分了公开权重和商业API:是可直接部署的模型吗?
- 与我的业务相似吗:评估问题与实际使用场景是否足够相似?
前两名模型的分数相差0.5分,并不能实际确定优劣。如果置信区间重叠或评估条件不同,它们实际上可能处于相似水平。
根据目的应查看哪个网站?
通用聊天机器人和写作
在Arena上确认人类偏好度,并用LiveBench的语言·指令遵循分数补充准确性。最后,执行包含韩语文风和事实核查的自定义问题集。
基于API的服务
在Artificial Analysis上同时查看智能、首个响应延迟、总响应时间、和每任务成本。将候选模型缩小到两三个后,使用实际流量长度和系统提示词进行负载测试。
编程代理
在SWE-bench上比较相同的数据集和代理条件。除了简单的代码问题分数,还要同时确认仓库探索、测试通过率和每问题成本。
内部部署的开源模型
在Hugging Face的领域排行榜上寻找候选模型,并确认许可证和硬件要求。然后,自行评估公司文档、韩语支持、安全策略和RAG搜索质量。
研究和客观推理能力
交叉核对LiveBench等更新的基于正确答案的评估和Artificial Analysis的个别基准测试。优先考虑与自身研究领域更接近的子任务,而非综合分数。
最准确的方法是建立一个小型内部排行榜
公开排行榜是筛选候选工具,不能替代最终购买决策。创建30-100个代表实际业务的评估问题,将能得出更准确的结论。
공개 리더보드로 후보 3~5개 선정
→ 실제 업무 질문과 정답 기준 준비
→ 같은 시스템 프롬프트와 도구 조건 적용
→ 품질·지연·비용·안전성 측정
→ 실패 사례를 사람이 검토
→ 용도별 모델과 폴백 정책 결정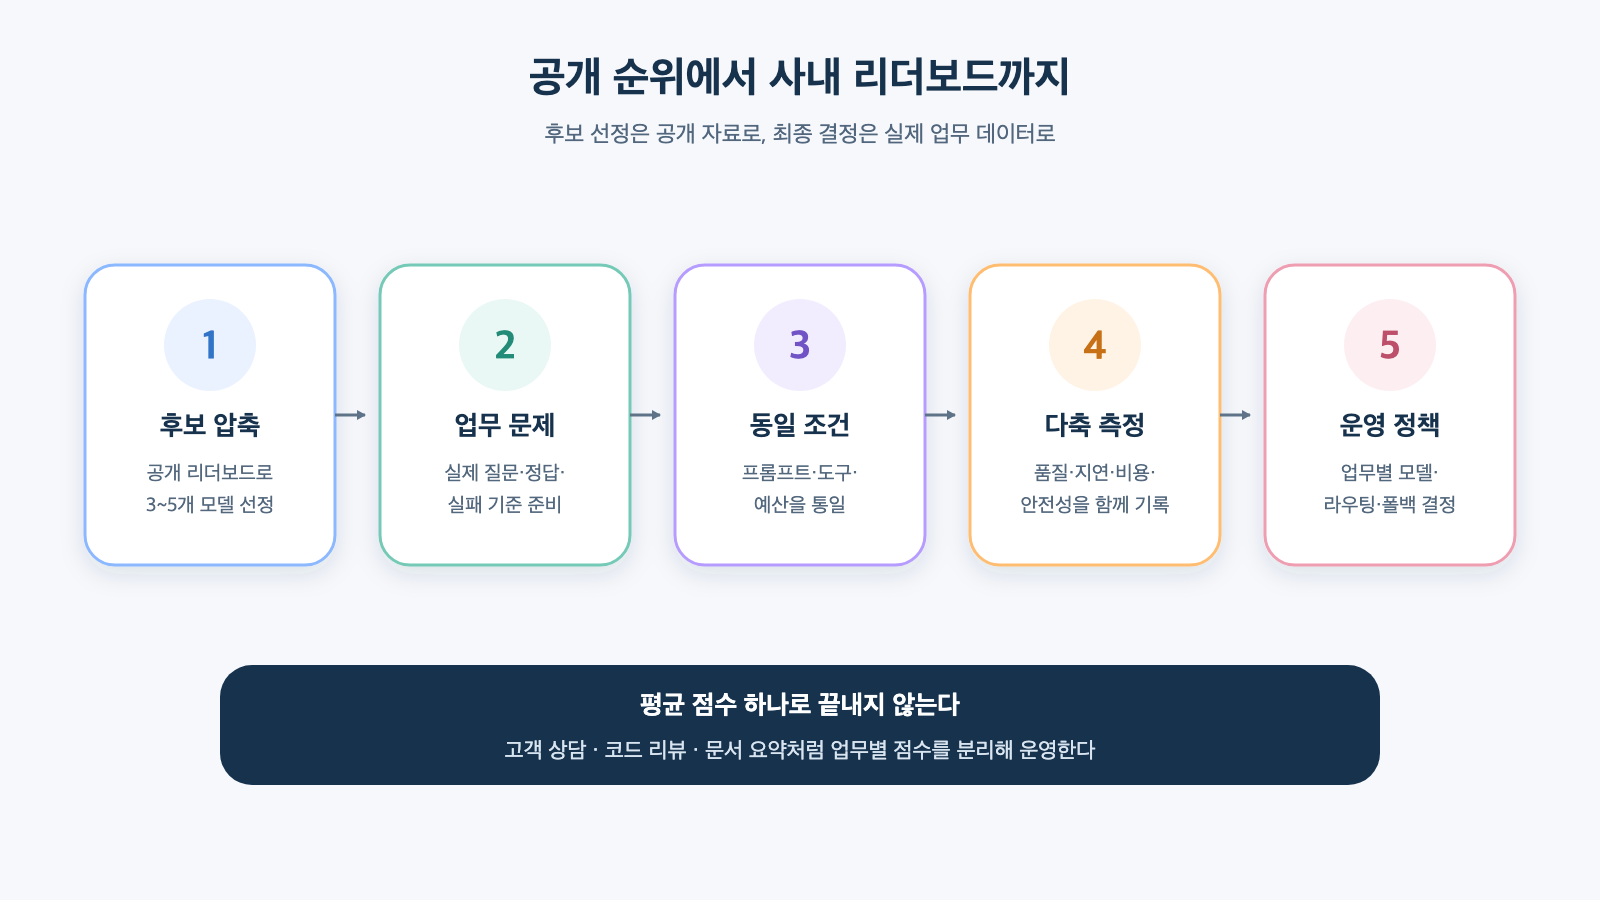
图:从公开排行榜候选筛选到按业务划分的运营策略的内部评估流程 · 基于Artificial Analysis模型比较方法和本文评估流程重构
例如,安全团队应同时评估漏洞描述的准确性、证据链接、过度攻击指令的阻止、日志分析和韩语报告的质量。开发团队则可能更重视遵守现有仓库规则、测试通过、修改范围和token成本。
最好将分数按“客户咨询”、“代码审查”、“文档摘要”等业务进行划分,而不是只创建一个平均分数。这样才能避免将一个模型强行用于所有业务,并能设计出按用途路由或回退的方案。
最终总结
AI性能比较网站并非相互竞争的单一排行榜,而是回答不同问题的测量工具。
- Arena展示实际用户对答案的偏好。
- Artificial Analysis同时比较智能、价格、速度和延迟。
- LiveBench通过最新问题和客观评分确认推理能力。
- SWE-bench评估结合模型和工具的编程代理的实际问题解决能力。
- Hugging Face Leaderboards是寻找开源模型和按目的可复现评估的起点。
选择AI模型时,不应只看“全球AI排名第一”这句话,而应同时确认评估方式、模型版本、成本和延迟,以及与自身业务的相似性。
通过公开排名筛选候选,并用实际业务数据进行小型内部评估,这是选择AI模型最安全、最现实的方法。
发表回复