将大型语言模型(LLM)连接到业务时,个人信息进入的路径也会随之增加。用户可以直接在提示中输入,或者它可能已经包含在训练数据或RAG文档中。模型在组合搜索结果的过程中,可能会将与原始问题无关的个人信息混入答案中,或者操作日志成为新的个人信息存储库,这些问题也会出现。
这个问题并非通过在模型前添加一个正则表达式过滤器就能解决。个人信息从数据收集到输入、搜索上下文、输出、日志都会流动。反之,如果无条件地阻止所有语句,误报会增加到服务无法使用的程度。
现实的目标不是承诺“完美检测”,而是通过叠加多种检测方式,确保不遗漏高风险信息,并根据业务目的和权限,一致地决定是阻止、遮蔽、假名化还是允许。
首先,需要绘制个人信息的流向
LLM服务中个人信息的主要流动路径如下:
원본 문서·업무 데이터
        ↓
수집·전처리 → RAG 인덱스
        ↓           ↓
사용자 입력 → 검색·컨텍스트 구성 → LLM
                                  ↓
                              모델 출력
                                  ↓
                           사용자·외부 도구

각 구간의 요청·결과·정책 판단 → 감사 로그
这里重要的一点是,不应让模型本身来判断个人信息的访问权限。“不要提及个人信息”这样的系统提示只是一种辅助指令,而非安全边界。OWASP也解释说,敏感信息可能通过训练数据或用户交互暴露,仅凭系统提示难以阻止规避。
因此,个人信息控制必须在模型外部强制执行。
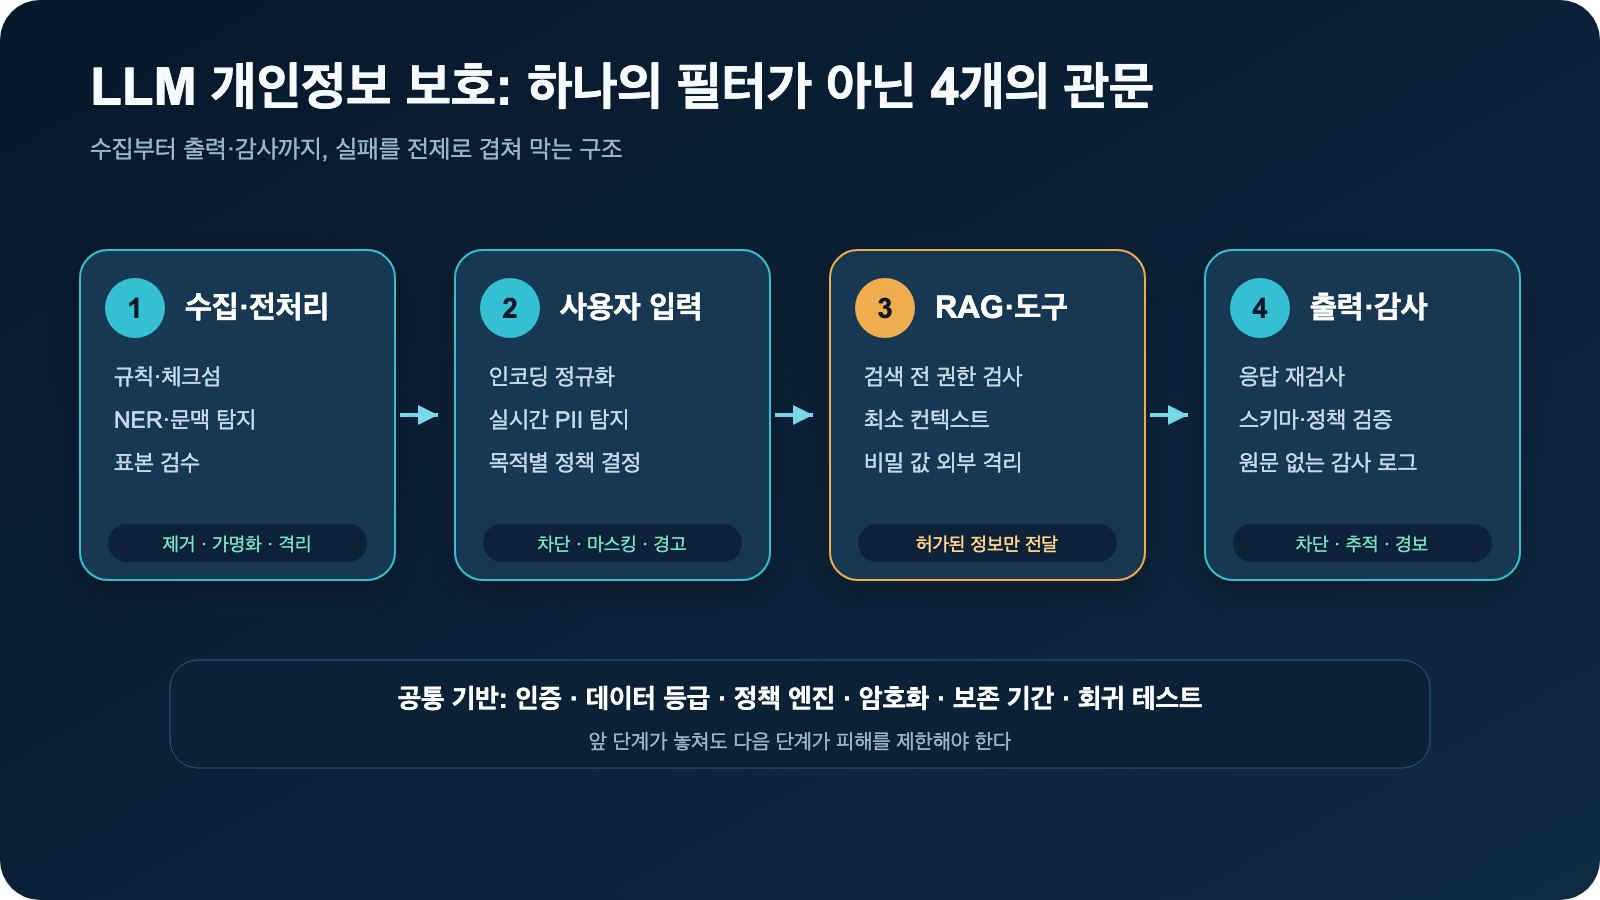
4阶段结构一览
| 阶段 | 保护对象 | 核心控制 | 代表结果 |
| — | — | — | — |
| 1. 收集·预处理 | 训练数据、文档、RAG原始数据 | 正则表达式·校验和、NER、上下文检测、样本审查 | 删除、遮蔽、假名化、隔离 |
| 2. 用户输入 | 提示、附件、对话历史 | 规范化、实时PII检测、目的策略 | 阻止、遮蔽、令牌化、警告 |
| 3. RAG·工具·上下文 | 搜索文档、秘密信息、外部工具 | 搜索前权限检查、最小上下文、秘密中介 | 仅将授权信息传递给模型 |
| 4. 输出·审计 | 模型响应、执行参数、操作日志 | 输出再检查、结构验证、安全日志记录 | 防止泄露、追踪·警报 |
每个阶段都不能相互替代。即使在预处理中遗漏了个人信息,也应在输入或输出阶段再次捕获;即使过滤器失败,RAG权限控制也应阻止搜索其他用户的文档。
第1阶段:在数据收集和预处理中减少
从创建训练数据或RAG知识库时就减少个人信息的数量是最具成本效益的方法。因为一旦向量化,不仅原文,还包括块、嵌入、元数据、缓存和备份都需要一起清理。
首次检测:规则和校验和
对于格式相对明确的值,如居民身份证号、电话号码、电子邮件、银行卡号,可以使用正则表达式快速找到候选。但仅凭数字格式匹配并不意味着它是实际的识别号码,因此在可能的情况下,应结合校验和、日期有效性、前缀区间等验证方法,以减少误报。
仅凭正则表达式很容易遗漏以下表达:
공일공-일이삼사-오육칠팔
홍 길 동의 메일은 hong (at) example (dot) com
매주 화요일 ○○병원 희귀질환 센터에 방문하는 팀장
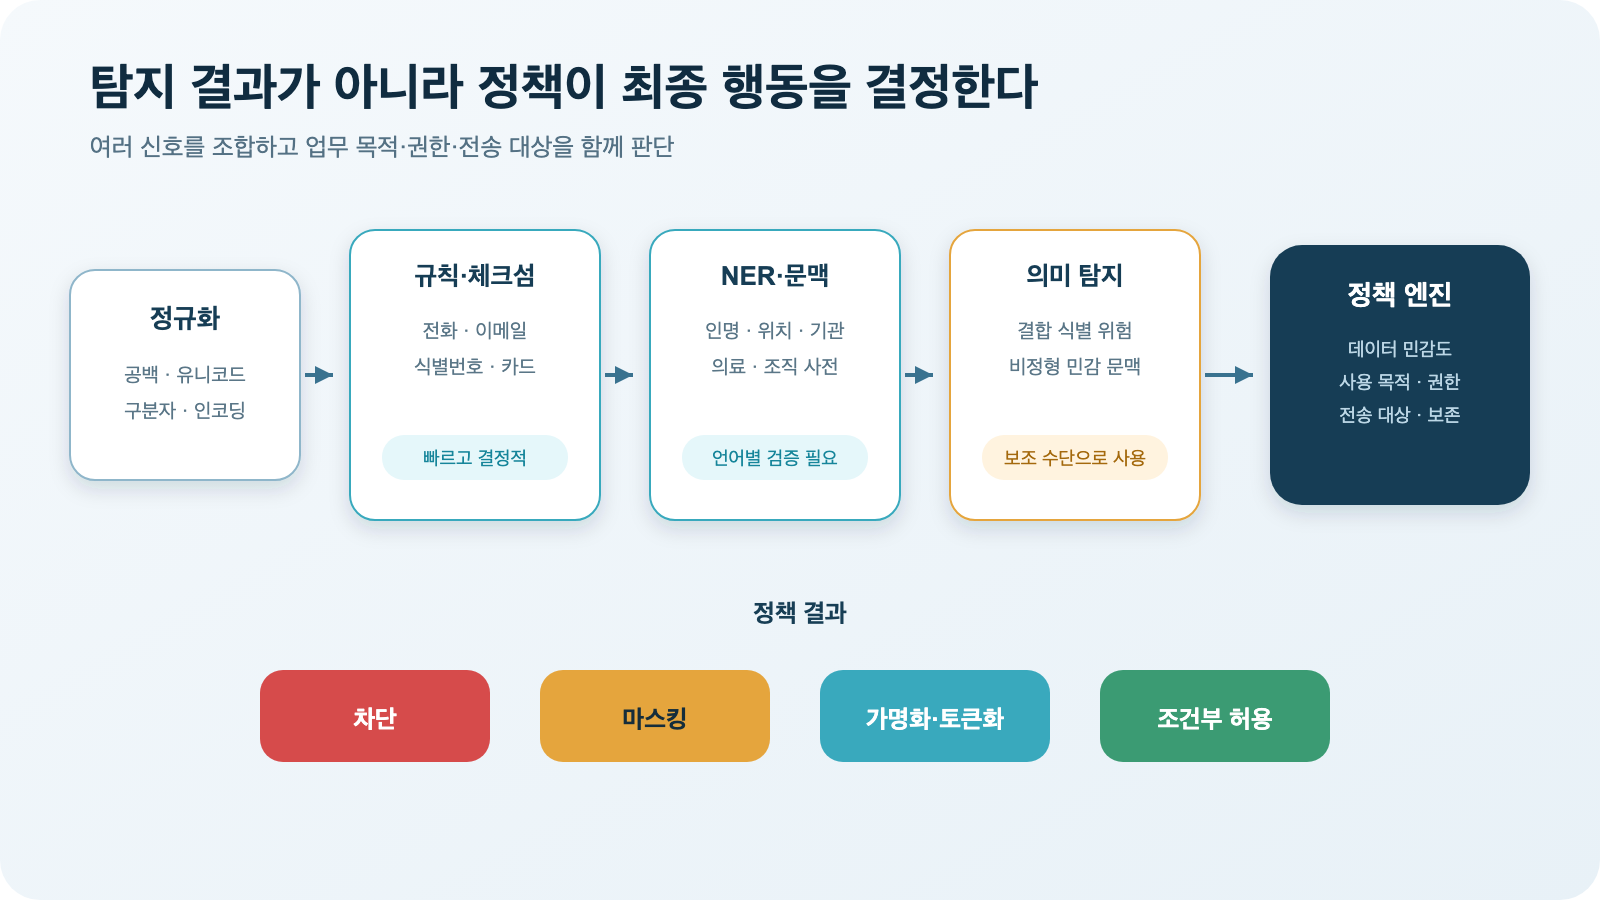
因此,应首先对空格、Unicode、分隔符和已知编码进行规范化,并将正则表达式结果视为检测信号之一,而非最终判定。
第二次检测:NER和上下文
对于根据上下文意义不同的信息,如人名、地点、组织、医疗信息,应结合命名实体识别(NER)和周围词语进行分析。Microsoft Presidio的Analyzer也结合了正则表达式、列表、校验和、规则、NER和上下文,并可连接spaCy、Transformers、Stanza等NLP引擎或用户自定义识别器。
在韩语环境中,与其直接引入通用英文模型,不如验证韩语NER模型和业务专用词典。对于仅在组织内部具有识别力的值,如员工编号、客户编号、项目代码、分店名称,通用工具无法识别,因此需要用户自定义识别器。
第三次检测:基于语义的模型作为辅助手段
对于需要组合多个线索才能揭示识别风险的句子,例如“每周在同一家医院接受特定治疗的唯一高管”,可以使用基于语义的分类器或LLM作为辅助检测器。但是,如果将阻止决策完全交给LLM-as-a-Judge,输出可能不确定,并受提示规避的影响。
此外,将原文发送给外部LLM进行个人信息检测,可能会在检测前将个人信息传输到外部,造成矛盾。如果需要基于语义的检测,应使用内部模型或经批准的处理环境,并将结果限制为PERSON、MEDICAL_CONTEXT、HIGH_RISK等结构化标签,以确保安全。
第四次验证:人工审查样本
自动过滤器的准确性因文档类型和语言而异。在部署前,应创建包含和不包含个人信息的样本,以测量召回率和精确率;在运营中,有权限的审查员也应至少检查少量样本。审查界面也应避免无条件地显示整个原文,只显示必要的周围上下文为宜。
比检测更重要的是“如何处理”
发现个人信息后的处理措施因使用目的而异。
| 处理方式 | 示例 | 适用情况 | 注意事项 |
| — | — | — | — |
| 阻止·删除 | 拒绝请求本身 | 密码、API密钥、居民身份证号等高风险值 | 引导用户安全地重新输入 |
| 遮蔽 | 010-****-5678 | 在屏幕显示或咨询上下文中需要部分信息时 | 检查剩余片段的再识别可能性 |
| 分类 | 精确年龄 → 40多岁 | 统计·分析不需要精确值时 | 过于细致的分类会保持识别力 |
| 假名化·令牌化 | 姓名 → PERSON_7F2A | 在同一对话·任务中需要连接性时 | 映射表存储在模型外部的单独保险库中 |
| 允许 | 授权客服人员查询客户信息 | 法律依据和业务目的明确时 | 应用最小范围、过期时间、审计记录 |
Microsoft Presidio Anonymizer提供了replace、redact、hash、mask、encrypt等操作符。但是,工具提供的功能与组织必须选择的策略是分开的。例如,单向哈希在候选值范围狭窄时可能被重新识别,而假名化由于保留了映射表,因此与匿名化不同。
只保留电话号码后四位安全吗?
仅仅遮蔽部分信息,如010-****-5678,并不会自动使其成为匿名信息。如果同一对话中包含所属、职务、地区、访问日期或事件情况,剩余的四位数字可能与这些信息结合,推断出特定个人。
“경기 남부 지점의 유일한 보안팀장”
+ “지난 화요일 ○○병원 방문”
+ “전화번호 끝 네 자리 5678”
= 결합했을 때 높아지는 재식별 가능성
因此,遮蔽范围不应是固定的模式,而应根据使用界面、业务目的、同时暴露的信息以及访问者的范围来确定。
- 对于简单的统计或LLM分析,用[联系方式]完全替换或删除。
- 如果需要在同一对话中关联目标,使用PHONE_8F92之类的随机令牌。
- 如果客服人员在身份验证后需要确认联系方式,屏幕上只显示所需范围,并将完整号码查询分离为单独的审批流程。
- 对于日志和分析数据,如果可能,甚至不保留后四位。
最安全的个人信息不是过滤器很好地遮蔽的信息,而是从一开始就没有收集或传递给模型的信息。即使准备事后遮蔽,也应首先在输入界面阻止不必要的值的输入,如居民身份证号、认证信息。
第2阶段:在模型调用前控制用户输入
在操作环境中,所有提示和附件都是不可信的输入。处理顺序可以按如下方式配置:
요청 인증
→ 텍스트·인코딩 정규화
→ 규칙·체크섬 탐지
→ NER·문맥 탐지
→ 테넌트·업무 목적별 정책 결정
→ 차단 또는 가명화
→ 승인된 모델 호출
OpenAI Guardrails的Contains PII检查可以使用Microsoft Presidio遮蔽或阻止输入的个人信息,并在输出阶段应用阻止策略。AWS Bedrock Guardrails也提供了检测和阻止或遮蔽输入和模型响应中PII的功能。这些托管功能虽然有用,但不应在未经组织韩语数据和标识符验证的情况下,就认为“设置好了就万事大吉”。
输入长度限制、文件大小限制、请求频率限制也是必要的。这些是减少成本激增、资源耗尽和大规模提取尝试的控制措施,而不是解决个人信息检测或提示注入的过滤器。
用户体验也很重要。与其简单地报错,不如提供具体的安全操作指导,例如:
주민등록번호로 보이는 값이 포함되어 요청을 전송하지 않았습니다.
해당 값을 삭제하거나 고객 참조번호로 바꾼 뒤 다시 시도해 주세요.
第3阶段:RAG在搜索前检查权限
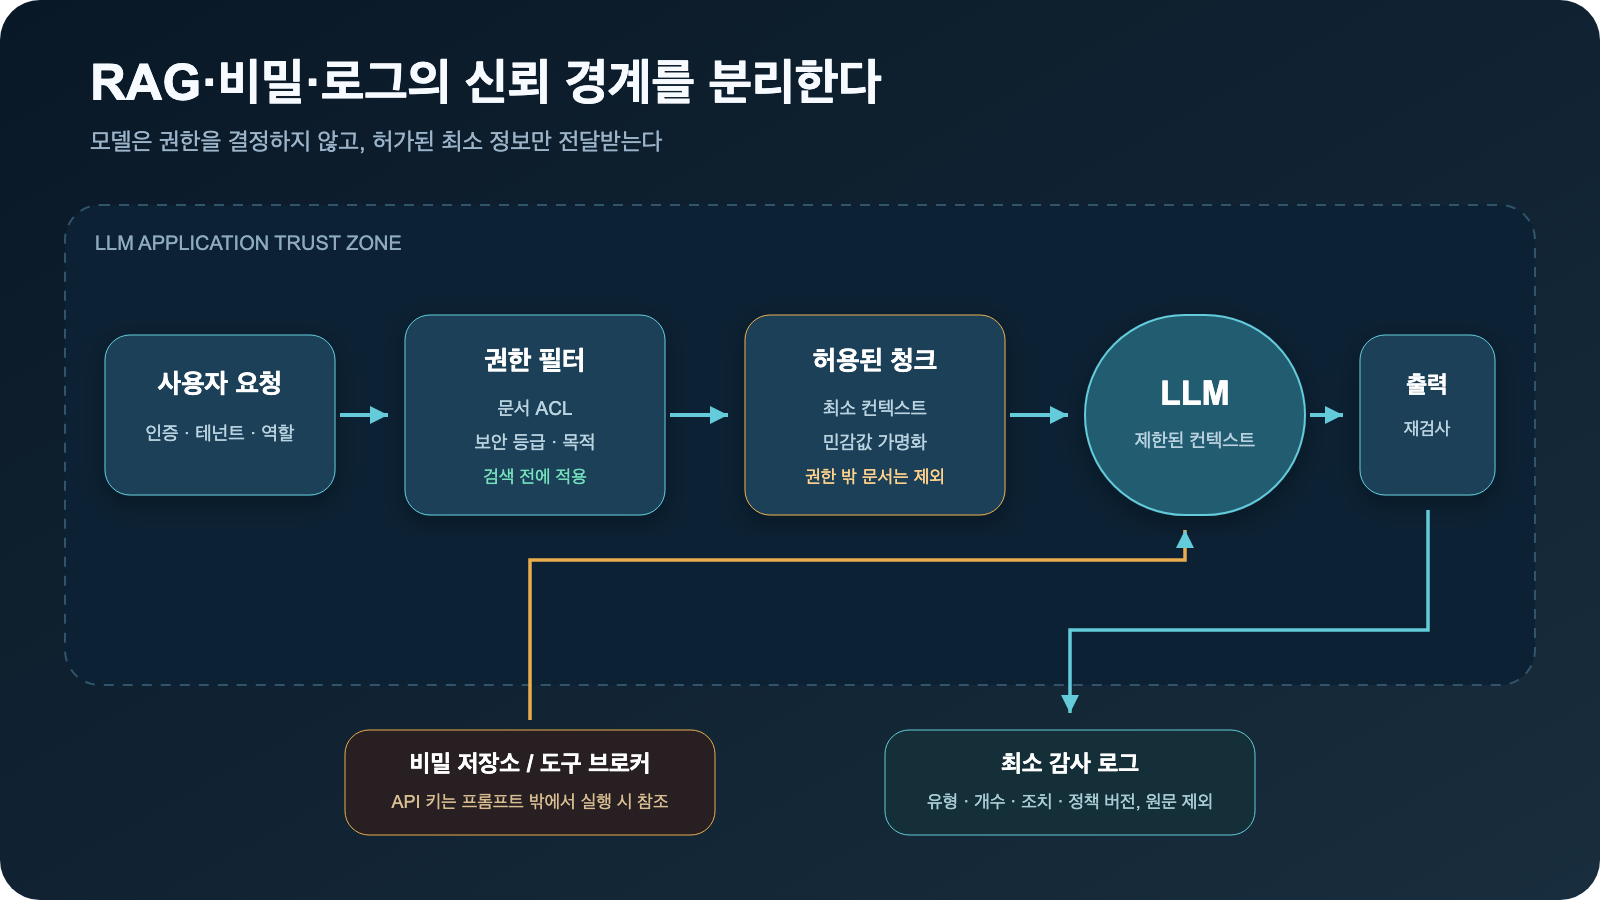
RAG中常见的错误是搜索所有文档,然后指示模型“不要回答未经授权的内容”。一旦搜索到的块进入上下文,就可能因提示注入或模型错误而暴露。
权限检查应在搜索前进行。
사용자 인증 정보
→ 테넌트·역할·문서 ACL 확인
→ 허용 범위로 검색 후보 제한
→ 관련 청크 검색
→ 필요한 최소 청크만 컨텍스트에 포함
在一般业务中,可以使用文档·行级ACL、租户密钥、安全等级元数据和搜索过滤器来实现“安全修剪”。在监管边界严格或不同客户数据绝不能混淆的环境中,可以增加索引、数据库、账户或VPC的物理隔离方式。为每个用户组复制向量数据库并非唯一的正确答案。
API密钥、数据库密码、OAuth令牌不应放入提示或RAG文档中。秘密值应由Secrets Manager或Vault等秘密存储库保管,并仅在执行时由工具代理引用。KMS或HSM主要管理加密这些数据和存储库的密钥。
向模型提供受限的工具接口,而不是秘密本身。
나쁜 예: 프롬프트에 운영 DB 비밀번호 삽입

좋은 예: LLM이 `lookup_customer(reference_id)` 요청
       → 도구 브로커가 사용자 권한과 인자를 검사
       → 비밀 저장소에서 자격증명을 일시 참조
       → 필요한 필드만 반환
如果以后需要再次显示原文
简单的遮蔽是隐藏显示格式的操作,并非恢复原文的功能。如果以后需要向授权用户再次显示原文,则必须设计可逆令牌化或单独的加密原文存储。此时,恢复逻辑不应委托给LLM或提示。
安全流程如下:
1. 원본 전화번호 수집
2. 무작위 토큰 발급: PHONE_8F92
3. LLM·대화 DB에는 토큰만 저장
4. 원본↔토큰 매핑은 별도 보안 저장소에 암호화
5. 사용자가 원문 조회 요청
6. 애플리케이션이 세션·소유권·권한·재인증 확인
7. 미들웨어가 필요한 순간에만 복원
8. LLM을 거치지 않고 승인된 UI에 직접 렌더링
9. 조회 사실을 원문 없이 감사 로그에 기록
各组件的责任也必须明确。
| 组件 | 应承担的角色 | 不应拥有的权限 |
| — | — | — |
| LLM | 理解“联系方式确认请求”的意图 | 访问原始映射DB·解密密钥 |
| 应用程序 | 会话、所有权、业务目的、策略检查 | 无限制地批量查询原文 |
| 令牌保险库 | 令牌与原文的安全映射 | 与用户直接交互 |
| KMS·HSM | 控制存储加密密钥的生成·使用 | 将个人信息传递给提示 |
| 批准的UI | 向已验证用户显示最短时间 | 在响应缓存·分析日志中存储原文 |
| 审计系统 | 记录查询者·时间·原因·策略结果 | 记录恢复的个人信息原文 |
再识别请求比一般查询应用更强的控制。不要仅仅依赖登录会话;根据风险级别要求MFA或近期重新认证,并不仅验证RBAC,还要确认数据所有权和业务目的。对恢复API应用短的过期时间、一次性权限、调用频率限制和批量查询阻止。
存储应使用经批准的加密算法进行加密,密钥由KMS或HSM控制。仅仅“使用了AES-256”并不意味着安全。如果应用程序角色可以自由解密所有密钥和数据,则分离效果将消失,因此必须同时限制密钥使用策略和服务角色。
审计日志应记录用户ID、会话或请求ID、查询时间、假名化目标标识符、查询原因、允许/拒绝结果和策略版本。不记录恢复的电话号码本身或解密密钥。这些事件可以发送到SIEM,以将异常时间段的查询、短时间内重复查询、查询多个客户等情况连接到警报。
第4阶段:将输出和日志作为最后一道防线
模型的原始输出在传递给用户或外部系统之前必须再次检查。因为输入中未发现的信息可能从RAG文档或模型记忆中生成。
在输出阶段,结合个人信息类型、请求者权限和响应目的,选择以下之一:
안전함        → 전달
일부 노출 가능 → 마스킹 후 전달
고위험 정보    → 전체 차단 및 안전한 대체 문구
판단 불확실    → 사람의 승인 대기
代码、SQL、HTML、工具调用参数需要独立于个人信息过滤器的模式验证、白名单、转义和沙盒。删除个人信息并不意味着命令执行也安全。
审计日志中最好保留以下信息,而不是原文:
{
  "request_id": "req_7f2a",
  "actor_id": "pseudonymous-user-42",
  "detected_types": ["PHONE_NUMBER", "PERSON"],
  "detected_count": 2,
  "action": "MASK",
  "policy_version": "pii-policy-2026-07",
  "model_route": "internal-model",
  "timestamp": "2026-07-30T10:15:00+09:00"
}
此处不记录检测到的电话号码或姓名的原文。如果出于事故调查目的,确实需要有限的原文保留,则必须应用单独的加密存储、严格的访问控制、短的保留期限和查阅审计。
即使使用托管式防护栏,也必须单独检查日志设置。AWS文档警告说,Guardrails的遮蔽不会自动应用于模型调用日志,这意味着原始请求可能存储在CloudWatch Logs或S3中,并且跟踪信息中也可能包含检测到的原文。换句话说,屏幕上遮蔽的内容与日志中删除的内容并非同一回事。
实际政策应根据数据类型而异
| 数据类型 | 基本策略 | 例外条件 |
| — | — | — |
| 密码·API密钥·会话令牌 | 立即阻止,安全警报 | 无 |
| 居民身份证号·护照号·账户·银行卡 | 阻止外部模型传输,内部也最小化 | 明确的法律依据和经批准的专用业务 |
| 电话号码·电子邮件·地址 | 遮蔽或令牌化 | 本人确认完成的咨询等目的明确时 |
| 姓名·职务·机构 | 评估与上下文结合的风险 | 如果是公开业务信息且为目的所需 |
| 医疗·生物识别·位置·行为信息 | 归类为高风险,优先内部处理 | 强化的同意·权限·审计体系 |
| 员工编号·客户编号·项目代码 | 应用组织特定识别器和策略 | 经批准的内部业务 |
即使是相同的姓名,公开新闻稿中的代表姓名与非公开咨询记录中的患者姓名风险也不同。不应仅仅判断“是否是PII”,而应将数据敏感度、使用目的、请求者权限、传输目标和保留期限一并纳入策略引擎。
运营前必须衡量的指标
个人信息过滤器应根据其性能和失败方式进行评估,而不仅仅是是否安装。
- 高风险召回率: 实际居民身份证号·账户秘密等遗漏的程度
- 精确率: 错误阻止正常业务语句的频率
- 语言·表达性能: 韩语、英语、空格变体、Unicode、图像OCR中性能是否保持
- 规避抵抗力: 分割输入、编码、角色扮演、间接提示注入下策略是否保持
- 处理延迟: 输入和输出检查对服务延迟的影响
- 策略结果: 阻止·遮蔽·允许的比例和用户重试率
- 残余泄露率: 红队数据集中最终响应或日志中剩余个人信息的比例
如果在运营中更改检测规则或模型,必须使用相同的回归测试集重新测量。这也是将检测模型版本和策略版本记录在审计日志中的原因。
引入顺序从小处着手更安全
- 首先,列出数据流和存储位置。
- 首先阻止密码·令牌·唯一标识符等高风险项目。
- 使用韩语文档和组织特定标识符创建评估数据集。
- 将相同的策略ID连接到收集、输入、RAG、输出和日志。
- 通过衡量阻止对业务的影响来设计遮蔽·假名化例外。
- 定期执行红队和回归测试。
- 验证保留期结束的原文、缓存、索引和备份的删除程序。
适用国内指南时需确认的要点
国内官方资料也一贯强调全生命周期的风险管理和数据最小化。个人信息保护委员会2025年《生成型人工智能(AI)开发·利用个人信息处理指南》提出了从目的设定到数据预处理、访问权限控制、输入输出过滤、部署前测试和持续管理等阶段的考虑事项。2026年用户指南建议在输入业务资料和第三方信息前进行确认,并检查对话存储·学习利用和外部服务权限。
个人信息保护委员会的AI隐私风险管理模型描述了一种方法,即识别AI的类型和用途,衡量风险发生的可能性和严重性,然后选择与风险成比例的措施。指南中的所有示例措施并非都同样强制适用于所有服务。实际的法律义务、保留期限、国际传输、假名信息处理与否,应以组织的处理目的和适用法律为准进行单独审查。
在技术安全方面,可以参考KISA的《人工智能(AI)安全指南》和《AI安全威胁应对手册》,以及国家情报院的《国家·公共机构AI安全指南》。处理公共机构或机密·敏感数据的环境可能需要比一般消费者服务更强的审批、网络隔离和数据等级控制。
结论
LLM个人信息保护并非安装某个特定产品的工作。它是一个连续的体系,在数据收集阶段减少个人信息,在模型调用前控制输入,阻止RAG搜索未经授权的文档,并再次检查最终输出和日志。
正则表达式快速但会遗漏上下文,NER灵活但有误报和漏报,基于语义的模型可以理解复杂线索但其本身可能带来新的处理风险。因此,应组合多种检测信号,但最终行动应由外部策略引擎和权限系统决定,而非模型。
核心原则很简单:
首先移除不需要传递给模型的个人信息,对必要信息也最小化假名化,搜索和工具执行受用户权限限制,并再次检查输出和日志。
将此原则一致地应用于所有4个阶段,才能使个人信息过滤器作为实际的安全控制而非简单的字符串替换功能发挥作用。
参考资料
- OWASP GenAI Security Project — LLM02:2025 Sensitive Information Disclosure
- Microsoft Presidio — Text anonymization
- Microsoft Presidio — Anonymizer
- OpenAI Guardrails — Contains PII
- AWS Bedrock Guardrails — Sensitive information filters
- 个人信息保护委员会 — 生成型AI服务利用者を 위한 個人情報保護ガイド
- 个人信息保护委员会 — 生成型人工智能(AI) 開発・活用を 위한 個人情報処理案内書
- 个人信息保护委员会 — 安全な人工知能(AI)・データ活用を 위한 AIプライバシーリスク管理モデル
- KISA — 人工智能(AI) 安全指南
- KISA — AI 安全威胁应对手册
- 国家情报院 — 国家·公共机构AI安全指南
发表回复