大規模言語モデル(LLM)を業務に接続すると、個人情報が流入する経路も増加します。ユーザーがプロンプトに直接入力することもあれば、学習データやRAGドキュメントにすでに含まれている可能性もあります。モデルが検索結果を組み合わせる過程で、元の質問とは無関係な個人情報を回答に混ぜたり、運用ログが新たな個人情報保存場所となる問題も発生します。
この問題は、モデルの前に正規表現フィルターを一つ付けるだけで解決するものではありません。個人情報はデータ収集から入力、検索コンテキスト、出力、ログまで移動するためです。逆に、すべての文章を無条件に遮断すると、サービスが利用できないほど誤検知が増加します。
現実的な目標は、「完璧な検出」を約束することではなく、高リスク情報は見逃さないように複数の検出方式を重ね、業務目的と権限に基づいて遮断・マスキング・仮名化・許可を一貫して決定することです。
まず個人情報の流れを描く必要がある
LLMサービスにおける個人情報の代表的な移動経路は以下の通りです。
원본 문서·업무 데이터
        ↓
수집·전처리 → RAG 인덱스
        ↓           ↓
사용자 입력 → 검색·컨텍스트 구성 → LLM
                                  ↓
                              모델 출력
                                  ↓
                           사용자·외부 도구

각 구간의 요청·결과·정책 판단 → 감사 로그
ここで重要なのは、モデル自体が個人情報へのアクセス権限を判断してはならないということです。「個人情報を話すな」というシステムプロンプトは補助的な指示に過ぎず、セキュリティ境界ではありません。OWASPも、機密情報が学習データやユーザーインタラクションを通じて漏洩する可能性があり、システムプロンプトだけでは回避を防ぐのが難しいと説明しています。
したがって、個人情報の制御はモデルの外部で強制する必要があります。
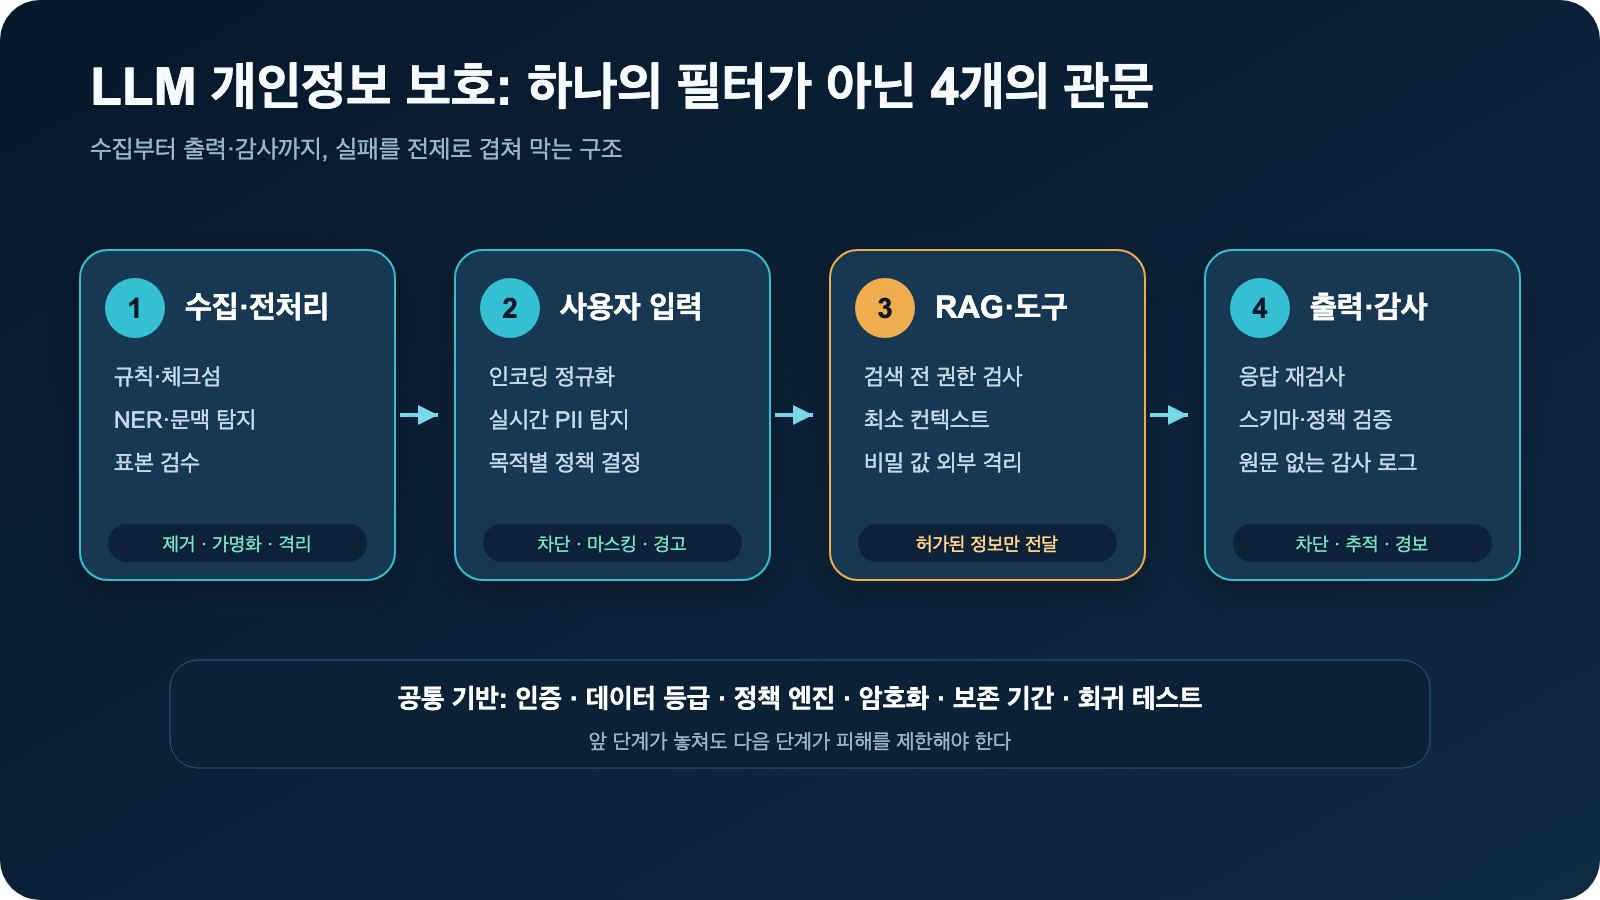
4段階構造を一覧で見る
| 段階 | 保護対象 | 主要な制御 | 代表的な結果 |
| — | — | — | — |
| 1. 収集・前処理 | 学習データ、文書、RAGオリジナル | 正規表現・チェックサム、NER、文脈検出、サンプル検査 | 除去、マスキング、仮名化、隔離 |
| 2. ユーザー入力 | プロンプト、添付ファイル、会話履歴 | 正規化、リアルタイムPII検出、目的別ポリシー | 遮断、マスキング、トークン化、警告 |
| 3. RAG・ツール・コンテキスト | 検索文書、秘密情報、外部ツール | 検索前権限検査、最小コンテキスト、秘密仲介 | 許可された情報のみモデルに伝達 |
| 4. 出力・監査 | モデル応答、実行引数、運用ログ | 出力再検査、構造検証、安全なロギング | 漏洩遮断、追跡・警報 |
各段階は互いに代替するものではありません。前処理で個人情報を見逃したとしても、入力または出力段階で再度捕捉できる必要があり、フィルターが失敗してもRAG権限制御が他のユーザーの文書を検索できないようにする必要があります。
1段階:データ収集と前処理で減らす
学習データやRAG知識ベースを作成する段階から個人情報の量を減らすことが、最も費用対効果が高いです。すでにベクトル化された後では、原文だけでなく、チャンク、埋め込み、メタデータ、キャッシュ、バックアップまで一緒に整理する必要があるためです。
最初の検出:ルールとチェックサム
住民登録番号、電話番号、メールアドレス、カード番号のように形式が比較的明確な値は、正規表現で迅速に候補を見つけることができます。ただし、数字の形が合っているからといって実際の識別番号であるとは限らないため、可能な場合はチェックサム、日付の有効性、接頭区間などの検証を併用して誤検知を減らす必要があります。
正規表現だけでは、次のような表現を見逃しがちです。
공일공-일이삼사-오육칠팔
홍 길 동의 메일은 hong (at) example (dot) com
매주 화요일 ○○병원 희귀질환 센터에 방문하는 팀장
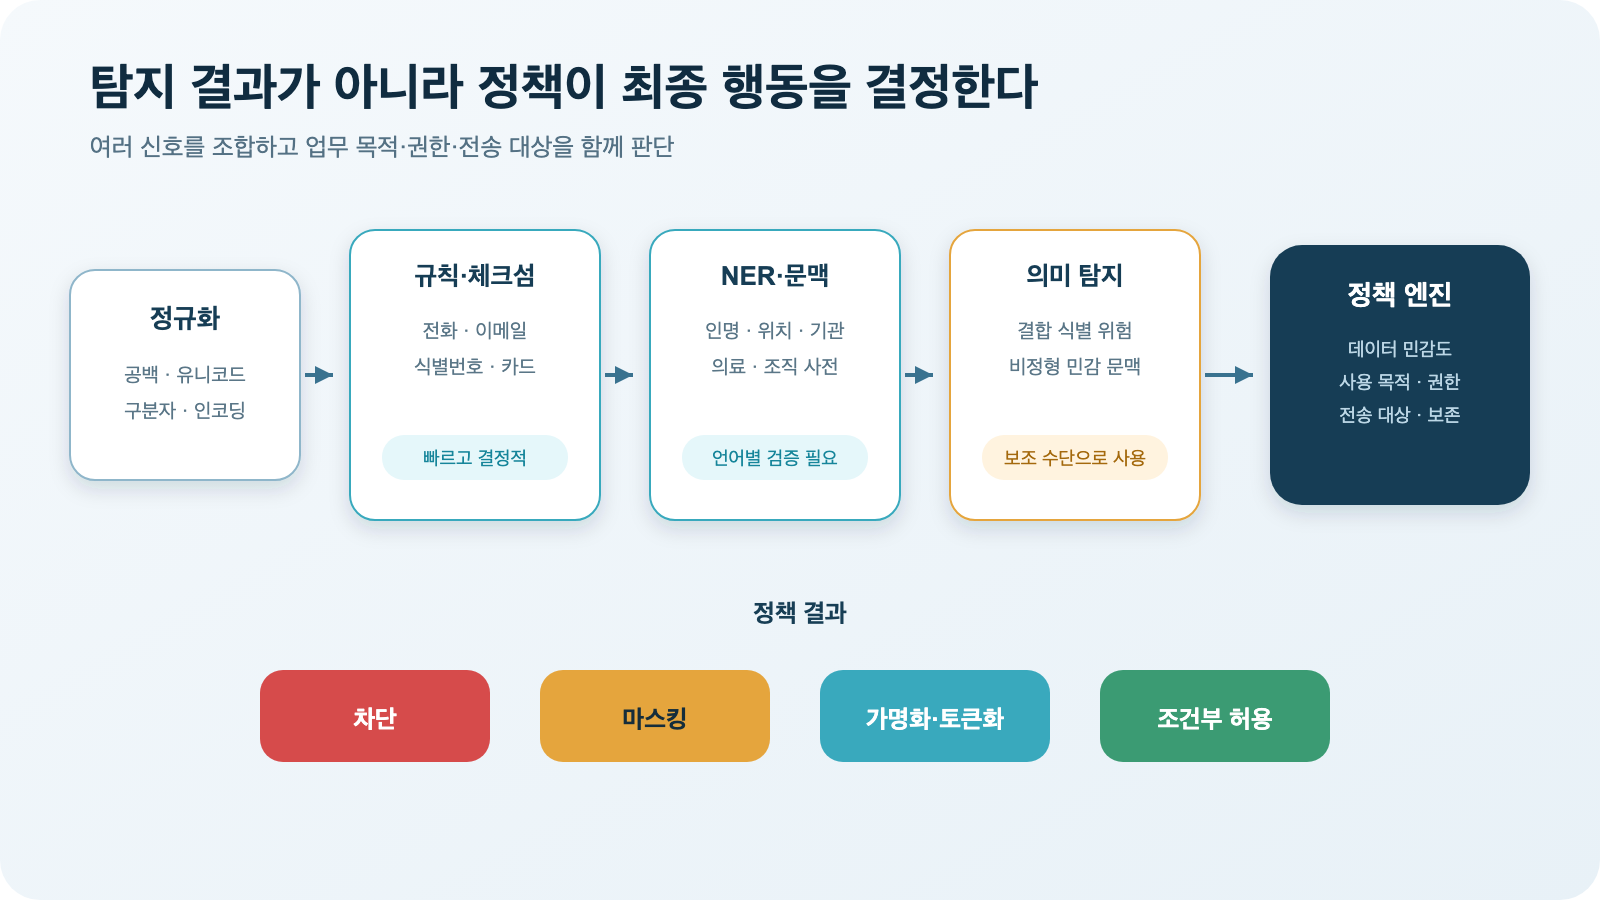
したがって、空白・ユニコード・区切り文字・既知のエンコーディングをまず正規化し、正規表現の結果を最終判定ではなく、検出信号の一つとして扱うべきです。
2番目の検出:NERと文脈
人名、位置、組織、医療情報のように文脈によって意味が変わる情報は、固有表現認識(NER)と周辺単語を一緒に分析します。Microsoft PresidioのAnalyzerも正規表現、リスト、チェックサム、ルール、NERと文脈を組み合わせ、spaCy・Transformers・StanzaなどのNLPエンジンやユーザー定義認識器を接続できます。
韓国語環境では、基本的な英語モデルをそのまま導入するよりも、韓国語NERモデルと業務別辞書を検証する必要があります。社員番号、顧客番号、プロジェクトコード、支店名のように組織内部でのみ識別力がある値は汎用ツールでは認識できないため、ユーザー定義認識器が必要です。
3番目の検出:意味ベースモデルは補助手段として
「毎週同じ病院で特定の治療を受けている唯一の役員」のように、複数の手がかりを組み合わせることで識別リスクが明らかになる文章は、意味ベースの分類器やLLMを補助検出器として使用できます。しかし、LLM-as-a-Judge一つに遮断決定を任せると、出力が非決定的になり、プロンプト回避の影響を受ける可能性があります。
また、外部LLMに原文を送って個人情報を検出する瞬間、検出前に個人情報を外部に送信するという矛盾が生じる可能性があります。意味ベースの検出が必要な場合は、内部モデルまたは承認された処理環境を使用し、結果はPERSON、MEDICAL_CONTEXT、HIGH_RISKのような構造化されたラベルに限定する方が安全です。
4番目の検証:人がサンプルを見る
自動フィルターの精度は、文書の種類と言語によって異なります。展開前には個人情報があるサンプルとないサンプルを一緒に作成して再現率と適合率を測定し、運用中も権限を持つ検査者が最小限のサンプルを確認する必要があります。検査画面も原文全体を無条件に表示せず、必要な周辺文脈のみを表示するのが良いでしょう。
検出よりも重要なのは「どう処理するか」だ
個人情報を発見した後の措置は、使用目的に応じて異なります。
| 処理方式 | 例 | 適切な状況 | 注意点 |
| — | — | — | — |
| 遮断・除去 | リクエスト自体を拒否 | パスワード、APIキー、住民登録番号など高リスク値 | ユーザーに安全な再入力方法を案内 |
| マスキング | 010-****-5678 | 画面表示や相談の文脈で一部情報が必要な場合 | 残りの断片の再識別可能性を点検 |
| カテゴリ化 | 正確な年齢 → 40代 | 統計・分析に精密値が不要な場合 | 細かすぎるカテゴリは識別力を維持 |
| 仮名化・トークン化 | 名前 → PERSON_7F2A | 同じ会話・業務内で連結性が必要な場合 | 対応表はモデル外の別途金庫に保管 |
| 許可 | 権限のある相談員による顧客照会 | 法的根拠と業務目的が明確な場合 | 最小範囲、有効期限、監査記録を適用 |
Microsoft Presidio Anonymizerは、replace、redact、hash、mask、encryptなどの演算子を提供します。しかし、ツールが提供する機能と組織が選択すべきポリシーは別物です。例えば、一方向ハッシュは候補値の範囲が狭いと再識別される可能性があり、仮名化は対応表が残るため匿名化とは異なります。
電話番号の下4桁だけ残せば安全か?
010-****-5678のように一部だけを隠したからといって、自動的に匿名情報になるわけではありません。同じ会話に所属、役職、地域、訪問日時や事件の状況が一緒にあれば、残りの4桁と組み合わせて特定の個人を推定できる可能性があります。
“경기 남부 지점의 유일한 보안팀장”
+ “지난 화요일 ○○병원 방문”
+ “전화번호 끝 네 자리 5678”
= 결합했을 때 높아지는 재식별 가능성
したがって、マスキング範囲は固定された形式ではなく、使用画面と業務目的、一緒に露出される情報、アクセス者の範囲に応じて定める必要があります。
- 単純な統計やLLM分析には、[連絡先]で全体を置換するか削除します。
- 同じ会話で対象を連結する必要がある場合は、PHONE_8F92のようなランダムなトークンを使用します。
- 相談員が本人確認後に連絡先を確認する必要がある場合は、画面には必要な範囲のみを表示し、全番号の照会は別途承認手続きに分離します。
- ログと分析データには、下4桁も可能な限り残さないようにします。
最も安全な個人情報は、フィルターがうまく隠した情報ではなく、そもそも収集したりモデルに伝達しなかった情報です。事後マスキングを準備する場合でも、入力画面で住民登録番号、認証情報のように不要な値の入力をまず防ぐべきです。
2段階:ユーザー入力はモデル呼び出し前に制御する
運用環境では、すべてのプロンプトと添付ファイルが信頼できない入力です。処理順序は次のように構成できます。
요청 인증
→ 텍스트·인코딩 정규화
→ 규칙·체크섬 탐지
→ NER·문맥 탐지
→ 테넌트·업무 목적별 정책 결정
→ 차단 또는 가명화
→ 승인된 모델 호출
OpenAI GuardrailsのContains PIIチェックは、Microsoft Presidioを利用して入力個人情報をマスキングまたは遮断でき、出力段階では遮断ポリシーを適用できます。AWS Bedrock Guardrailsも入力とモデル応答のPIIを検出して遮断またはマスキングする機能を提供します。これらの管理型機能は有用ですが、組織の韓国語データと識別子に合わせた検証なしに「設定したから終わり」と判断してはなりません。
入力長制限、ファイルサイズ制限、リクエスト頻度制限も必要です。これらは費用急増とリソース枯渇、大量抽出の試みを減らす制御であり、個人情報検出やプロンプトインジェクションを解決するフィルターではありません。
ユーザー体験も重要です。無条件にエラーを出すのではなく、次のように具体的な安全行動を伝えるのが良いでしょう。
주민등록번호로 보이는 값이 포함되어 요청을 전송하지 않았습니다.
해당 값을 삭제하거나 고객 참조번호로 바꾼 뒤 다시 시도해 주세요.
3段階:RAGは検索する前に権限を検査する
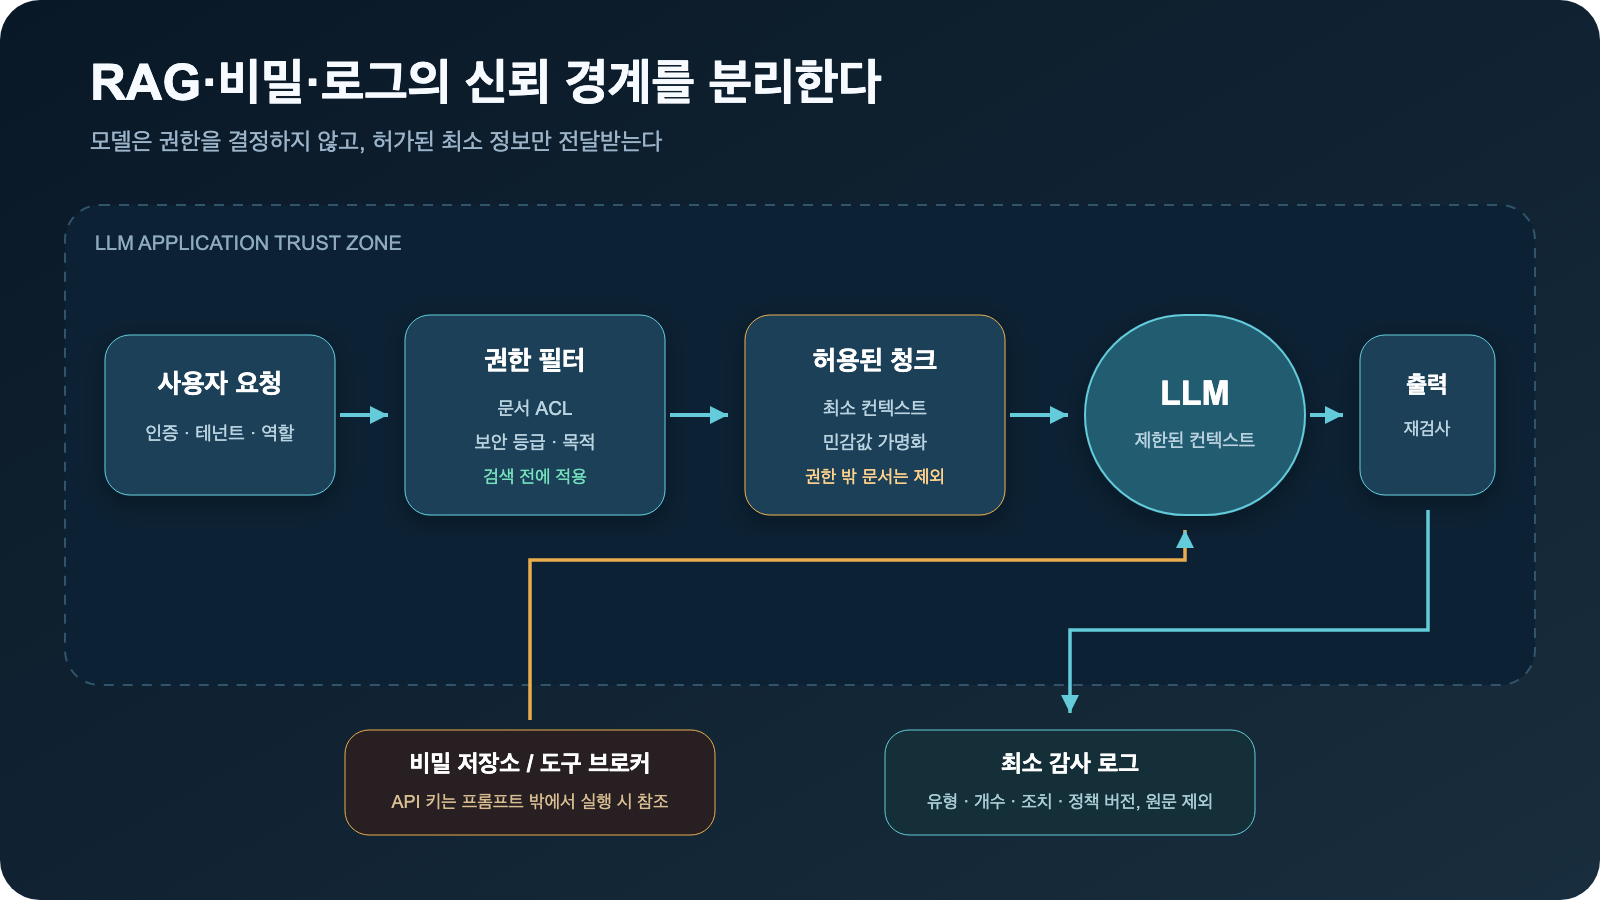
RAGでよくある間違いは、文書全体を検索した後、モデルに「権限のない内容は答えるな」と指示することです。すでに検索されたチャンクがコンテキストに入った後では、プロンプトインジェクションやモデルエラーで漏洩する可能性が生じます。
権限検査は検索前に行われるべきです。
사용자 인증 정보
→ 테넌트·역할·문서 ACL 확인
→ 허용 범위로 검색 후보 제한
→ 관련 청크 검색
→ 필요한 최소 청크만 컨텍스트에 포함
一般業務では、文書・行単位ACL、テナントキー、セキュリティ等級メタデータと検索フィルターを利用した「セキュリティトリミング」を適用できます。規制境界が強い、または異なる顧客のデータが絶対に混ざってはならない環境では、インデックス、データベース、アカウントまたはVPCを物理的に分離する方式を追加します。すべてのユーザーグループごとにベクトルDBを複製することが唯一の正解ではありません。
APIキー、データベースパスワード、OAuthトークンはプロンプトやRAG文書に入れないでください。秘密の値はSecrets ManagerやVaultのような秘密保存所が保管し、ツールブローカーが実行時にのみ参照すべきです。KMSまたはHSMは主にこのデータと保存所を暗号化するキーを管理します。
モデルには秘密自体ではなく、権限が制限されたツールインターフェースを提供します。
나쁜 예: 프롬프트에 운영 DB 비밀번호 삽입

좋은 예: LLM이 `lookup_customer(reference_id)` 요청
       → 도구 브로커가 사용자 권한과 인자를 검사
       → 비밀 저장소에서 자격증명을 일시 참조
       → 필요한 필드만 반환
後で原文を再度表示する必要がある場合
単純なマスキングは表示形式を隠す作業であり、元の情報を復元する機能ではありません。後で権限のあるユーザーに原文を再度表示する必要がある場合は、可逆的トークン化または暗号化された別途の原文保存所を設計する必要があります。この際、復元ロジックをLLMやプロンプトに任せてはなりません。
安全な流れは以下の通りです。
1. 원본 전화번호 수집
2. 무작위 토큰 발급: PHONE_8F92
3. LLM·대화 DB에는 토큰만 저장
4. 원본↔토큰 매핑은 별도 보안 저장소에 암호화
5. 사용자가 원문 조회 요청
6. 애플리케이션이 세션·소유권·권한·재인증 확인
7. 미들웨어가 필요한 순간에만 복원
8. LLM을 거치지 않고 승인된 UI에 직접 렌더링
9. 조회 사실을 원문 없이 감사 로그에 기록
構成要素ごとの責任も明確にする必要があります。
| 構成要素 | 担うべき役割 | 持つべきではない権限 |
| — | — | — |
| LLM | 「連絡先確認リクエスト」という意図の把握 | 原文マッピングDB・復号化キーへのアクセス |
| アプリケーション | セッション、所有権、業務目的、ポリシー検査 | 無制限の原文大量照会 |
| トークン金庫 | トークンと原文の安全なマッピング | ユーザーと直接相互作用 |
| KMS・HSM | 保存所暗号化キーの生成・使用制御 | 個人情報をプロンプトに伝達 |
| 承認されたUI | 確認されたユーザーに最小時間表示 | 応答キャッシュ・分析ログに原文保存 |
| 監査システム | 照会者・時刻・事由・ポリシー結果記録 | 復元された個人情報原文記録 |
再識別リクエストは、一般照会よりも強力な制御を適用します。ログインセッションだけを信用せず、リスク度に応じてMFAや最近の再認証を要求し、RBACだけでなくデータ所有権と業務目的も確認します。復元APIには短い有効期限、1回限りの権限、呼び出し頻度制限と大量照会遮断を適用します。
保存所は承認された暗号アルゴリズムで暗号化し、キーはKMSまたはHSMで制御します。「AES-256を使用した」という事実だけでは安全ではありません。アプリケーションの役割がすべてのキーとデータを自由に復号化できる場合、分離効果が失われるため、キー使用ポリシーとサービス役割を一緒に制限する必要があります。
監査ログには、ユーザーID、セッションまたはリクエストID、照会時刻、仮名化された対象識別子、照会事由、許可・拒否結果、ポリシーバージョンを記録します。復元された電話番号自体や復号化キーは記録しません。これらのイベントをSIEMに送信し、通常とは異なる時間帯の照会、短時間の繰り返し照会、多数の顧客照会を警報に連結できます。
4段階:出力とログを最後の防衛線とする
モデルの生出力は、ユーザーや外部システムに伝達する前に再度検査する必要があります。入力で発見されなかった情報がRAG文書やモデルの記憶から生成される可能性があるためです。
出力段階では、個人情報タイプ、要求者の権限、応答目的を一緒に判断し、次のいずれかを選択します。
안전함        → 전달
일부 노출 가능 → 마스킹 후 전달
고위험 정보    → 전체 차단 및 안전한 대체 문구
판단 불확실    → 사람의 승인 대기
コード、SQL、HTML、ツール呼び出し引数は、個人情報フィルターとは別にスキーマ検証、許可リスト、エスケープ、サンドボックスが必要です。個人情報を削除したからといって、コマンド実行も安全になるわけではありません。
監査ログには、原文の代わりに次の情報を残す方が良いでしょう。
{
  "request_id": "req_7f2a",
  "actor_id": "pseudonymous-user-42",
  "detected_types": ["PHONE_NUMBER", "PERSON"],
  "detected_count": 2,
  "action": "MASK",
  "policy_version": "pii-policy-2026-07",
  "model_route": "internal-model",
  "timestamp": "2026-07-30T10:15:00+09:00"
}
ここには検出された電話番号や氏名の原文は記録しません。事故調査のために限定的な原文保管がどうしても必要な場合は、別途の暗号化保存所、厳格なアクセス制御、短い保存期間と閲覧監査を適用する必要があります。
管理型ガードレールを使用する場合でも、ログ設定を別途確認する必要があります。AWSドキュメントは、Guardrailsのマスキングがモデル呼び出しログに自動適用されず、元のリクエストがCloudWatch LogsやS3に保存される可能性があり、追跡情報にも検出された原文が含まれる可能性があると警告しています。つまり、画面でマスキングされたこととログから削除されたことは同じではありません。
実務ポリシーはデータタイプ別に異なるべきである
| データタイプ | 基本ポリシー | 例外条件 |
| — | — | — |
| パスワード・APIキー・セッショントークン | 即時遮断、セキュリティ警報 | なし |
| 住民登録番号・パスポート番号・口座・カード | 外部モデル転送遮断、内部でも最小化 | 明示的な法的根拠と承認された専用業務 |
| 電話番号・メールアドレス・住所 | マスキングまたはトークン化 | 本人確認が完了した相談など目的が明確な場合 |
| 氏名・役職・機関 | 文脈と結合リスク評価 | 公開された業務情報であり、目的に必要な場合 |
| 医療・生体・位置・行動情報 | 高リスクに分類、内部処理優先 | 強化された同意・権限・監査体系 |
| 社員番号・顧客番号・プロジェクトコード | 組織別認識器とポリシー適用 | 承認された内部業務 |
同じ名前でも、公開された報道資料の代表者名と非公開の相談記録の患者名ではリスクが異なります。単に「PIIかどうか」だけを判断するのではなく、データ感度、使用目的、要求者の権限、転送対象、保存期間を一緒にポリシーエンジンに入れる必要があります。
運用前に必ず測定する指標
個人情報フィルターは、設置の有無ではなく、性能と失敗方式で評価すべきです。
- 高リスク再現率: 実際の住民登録番号・アカウント秘密などをどれだけ見逃さないか
- 適合率: 通常業務の文章をどれだけ誤って遮断しないか
- 言語・表現別性能: 韓国語、英語、スペースの変形、ユニコード、画像OCRで性能が維持されるか
- 回避耐性: 分割入力、エンコーディング、ロールプレイング、間接プロンプトインジェクションにもポリシーが維持されるか
- 処理遅延: 入力と出力検査がサービス遅延に与える影響
- ポリシー結果: 遮断・マスキング・許可の割合とユーザー再試行率
- 残余漏洩率: レッドチームデータセットで最終応答やログに残った個人情報の割合
運用中に検出ルールやモデルを変更する場合は、同じ回帰テストセットで再度測定する必要があります。検出モデルのバージョンとポリシーバージョンを監査ログに残す理由もここにあります。
導入順序は小さく始める方が安全である
- まず、データフローと保存場所をリストアップします。
- パスワード・トークン・固有識別番号のような高リスク項目から遮断します。
- 韓国語文書と組織固有の識別子で評価データセットを作成します。
- 収集、入力、RAG、出力、ログに同じポリシーIDを連結します。
- 遮断が業務に与える影響を測定しながら、マスキング・仮名化の例外を設計します。
- レッドチームと回帰テストを定期的に実行します。
- 保存期間が終了した原文、キャッシュ、インデックス、バックアップの削除手順を検証します。
国内指針を適用する際に確認すべき点
国内の公式資料も一貫して、ライフサイクル全体のリスク管理とデータ最小化を強調しています。個人情報保護委員会の2025年「生成型人工知能(AI)開発・活用を 위한 個人情報処理案内書」は、目的設定からデータ前処理、アクセス権限制御、入出力フィルタリング、展開前テスト、継続的管理まで段階別の考慮事項を提示します。2026年利用者ガイドは、業務資料と第三者情報を入力する前に確認し、会話保存・学習活用と外部サービス権限を点検するように案内します。
個人情報保護委員会のAIプライバシーリスク管理モデルは、AIのタイプと用途を把握し、リスクの発生可能性と重大性を測定した後、リスクに比例する措置を選択するアプローチを説明します。案内書のすべての例示措置がすべてのサービスに同じように義務適用されるという意味ではありません。実際の法的義務と保存期間、国外移転、仮名情報処理の有無は、組織の処理目的と適用法令を基準に別途検討する必要があります。
技術セキュリティ側面では、KISAの「人工知能(AI)セキュリティ案内書」と「AIセキュリティ脅威対応マニュアル」、国家情報院の「国家・公共機関AIセキュリティガイドブック」を一緒に参考にできます。公共機関や機密・敏感データを扱う環境は、一般消費者サービスよりも強力な承認、ネットワーク分離、データ等級制御が必要となる場合があります。
結論
LLM個人情報保護は、特定の製品を一つインストールする作業ではありません。データ収集段階で個人情報を減らし、モデル呼び出し前に入力を制御し、RAGが権限外の文書を検索できないようにし、最終出力とログを再度検査する連続した体系です。
正規表現は高速ですが文脈を見逃し、NERは柔軟ですが誤検知と未検知があり、意味ベースモデルは複雑な手がかりを理解できますが、それ自体が新たな処理リスクとなる可能性があります。そのため、複数の検出信号を組み合わせるべきですが、最終的な行動はモデルではなく、外部のポリシーエンジンと権限システムが決定すべきです。
核心原則は簡単です。
モデルに伝達する必要のない個人情報はまず除去し、必要な情報も最小限に仮名化し、検索とツール実行はユーザー権限で制限し、出力とログまで再度確認する。
この原則を4段階全体に一貫して適用することで、個人情報フィルターが単純な文字列置換機能ではなく、実際のセキュリティ制御として機能します。
参考資料
- OWASP GenAI Security Project — LLM02:2025 Sensitive Information Disclosure
- Microsoft Presidio — Text anonymization
- Microsoft Presidio — Anonymizer
- OpenAI Guardrails — Contains PII
- AWS Bedrock Guardrails — Sensitive information filters
- 個人情報保護委員会 — 生成型AIサービス利用者を 위한 個人情報保護ガイド
- 個人情報保護委員会 — 生成型人工知能(AI) 開発・活用を 위한 個人情報処理案内書
- 個人情報保護委員会 — 安全な人工知能(AI)・データ活用を 위한 AIプライバシーリスク管理モデル
- KISA — 人工知能(AI) セキュリティ案内書
- KISA — AI セキュリティ脅威対応マニュアル
- 国家情報院 — 国家・公共機関AIセキュリティガイドブック
コメントを残す