在使用生成式AI和大型语言模型时,一个问题浮出水面:
如果应用了足够的安全措施,LLM能否被完美控制?
开门见山地说,虽然大幅降低LLM的风险是可能的,但在所有输入和情况下,要使其完全按照预期运行,实现完美控制,在现实中是非常困难的。
原因在于,LLM并非像传统软件那样只执行人工编写规则的系统,而是通过从海量数据中学习统计模式的神经网络模型。
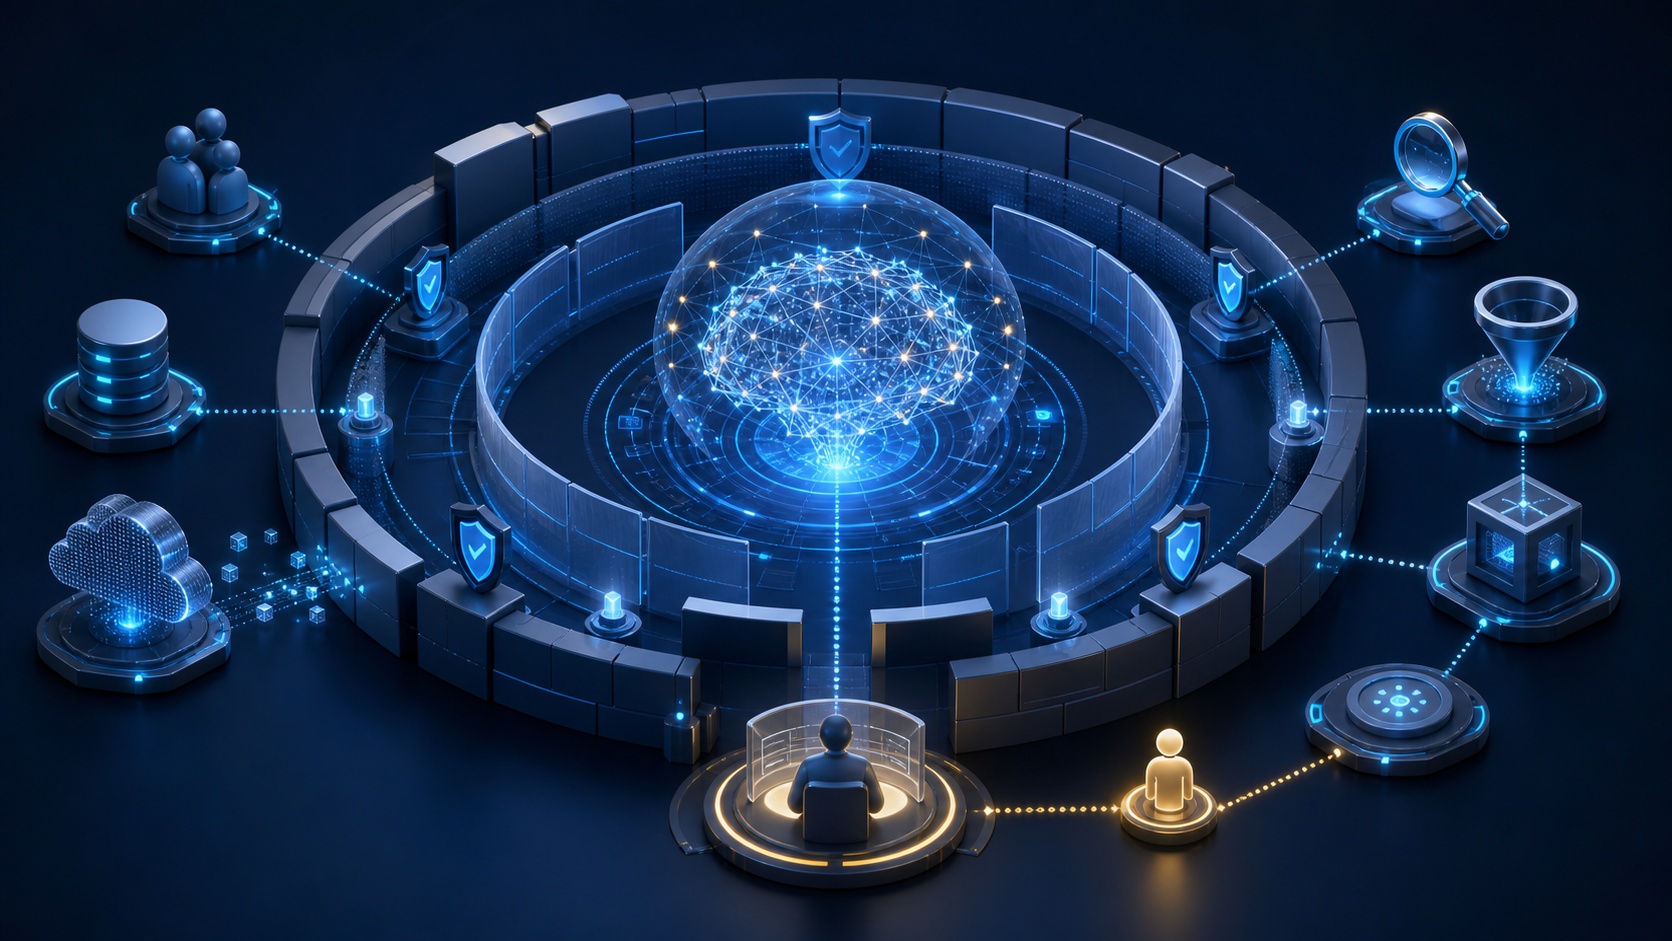
本文将从“构建一种结构,即使模型失败或被绕过,也能防止损害蔓延到实际系统”的角度来阐述生成式AI安全,而非将其视为“完美束缚模型的技术”。
人工神经网络源于生物神经元
人工神经网络的灵感来源于人脑和神经细胞传递信息的方式。
它将接收多个输入、计算其重要性,并在满足一定条件时将信号传递给下一个神经元的概念进行了数学上的简化。
입력값
→ 가중치 적용
→ 여러 입력값 결합
→ 활성화 함수
→ 출력값 전달
这种结构从早期的人工神经网络,经过CNN、RNN、LSTM,发展到Transformer和现代LLM。
인공신경망
→ CNN·RNN
→ LSTM·Attention
→ Transformer
→ GPT·Llama 등 LLM
然而,人工神经网络并非完全复制了真实人脑。它只是从生物神经元中获得了基本思想,而现代LLM更接近于一个庞大的数学模型,其中无数参数学习了数据的模式。
因此,更准确的说法是,并非因为模仿了生物结构而无法控制,而是因为模型是一个过于庞大和复杂的概率系统,导致其所有行为都难以预测。
LLM与执行规则的程序不同
传统程序执行开发者编写的条件和命令。
if user_role == "admin":
    allow_access()
else:
    deny_access()
如果输入值和程序状态相同,结果也能相对清晰地预测。
而LLM则根据输入的上下文计算接下来最有可能出现的token。
사용자 입력
→ 문맥과 토큰 관계 분석
→ 다음 토큰의 확률 계산
→ 토큰 선택
→ 같은 과정을 반복
例如,模型可以计算以下概率分布:
"보안" 다음에 올 토큰

정책: 35%
점검: 25%
취약점: 20%
시스템: 10%
기타: 10%
LLM的输出是通过重复这些概率计算而生成的。生成设置(如Temperature)、之前的对话内容、系统提示或外部文档的变化都可能导致结果不同。
也就是说,LLM不是一个查询预设答案的数据库,而是一个根据上下文生成结果的概率模型。
完美控制困难的原因
LLM行为难以完全预测的原因,不仅仅是因为输出中存在随机性。
模型通过数十亿到数万亿个参数之间复杂的相互作用来生成结果。人类很难在每个阶段清晰地解释特定输入是如何通过内部计算最终得出答案的。
此外,实际的LLM服务不仅仅包含模型本身。
사용자 입력
→ 시스템 프롬프트
→ LLM
→ RAG 검색
→ 외부 도구 호출
→ 데이터베이스·API
→ 최종 응답
其中还存在以下不确定性:
- 训练数据中包含的错误和偏见
- 对首次遇到的输入泛化失败
- 提示表达方式导致结果变化
- 直接·间接提示注入
- RAG文档中包含的恶意指令
- 工具调用过程中权限滥用
- 模型更新导致行为变化
- 结合多个组件时产生的漏洞
因此,仅仅提高模型的安全性并不能自动确保整个系统的安全。
OWASP GenAI安全项目发布的LLM Top 10也很好地体现了这一观点。2025年的列表包括提示注入(Prompt Injection)、敏感信息泄露(Sensitive Information Disclosure)、不当输出处理(Improper Output Handling)、过度代理(Excessive Agency)、系统提示泄露(System Prompt Leakage)、向量和嵌入弱点(Vector and Embedding Weaknesses)等项目。这些问题大多不是简单地以“模型给出了错误的答案”告终,而是模型与应用程序、工具、数据连接时产生的系统安全问题。
预测不确定性与安全漏洞应区分对待
LLM生成了与预期不同的答案,并非所有情况都构成安全漏洞。
例如,模型回答与事实不符的幻觉是可靠性问题。然而,如果模型的错误答案被作为系统命令执行,或用于重要的决策,就可能导致实际的安全事故。
모델의 잘못된 출력
→ 사용자에게 참고 정보로만 제공
= 품질·신뢰성 문제

모델의 잘못된 출력
→ 서버 명령이나 금융 거래로 자동 실행
= 보안 사고 가능성
LLM的预测不确定性本身并非就是漏洞。
但是,如果对难以预测的模型赋予过高的权限,并且未经验证就将其连接到外部系统,那么这种不确定性就可能转化为漏洞。
生成式AI安全始于不信任
LLM安全中最重要的原则是,不将模型视为可信的安全主体。
仅仅因为指示模型“不要泄露重要信息”,并不意味着可以将所有具有实际访问权限的秘密信息都传递给它。系统提示也只是传递给模型的指令,而非安全边界。
因此,安全控制必须在模型外部强制执行。
LLM을 완전히 신뢰하지 않음
→ 입력 검증
→ 출력 검증
→ 최소 권한 적용
→ 도구 호출 통제
→ 중요 작업 승인
→ 감사 로그와 모니터링
→ 지속적인 공격 테스트
不信任输入和外部文档
用户输入以及网页、电子邮件、PDF、RAG文档中都可能包含恶意指令。
LLM读取的所有数据都应被视为潜在的攻击者可控输入。
执行前验证输出
LLM生成的SQL、代码、命令、API参数不应直接执行。
需要进行模式验证、白名单、策略检查、执行环境隔离等程序。
仅提供最小权限
连接到LLM的工具应仅被授予执行任务所需的最小权限。
例如,如果一个只需要搜索电子邮件的代理被授予发送或删除邮件的权限,那么模型的错误就可能扩大为实际事故。
重要操作需经人工批准
支付、账户删除、权限更改、外部传输等高风险操作应采用“人在回路”(Human-in-the-Loop)方式进行批准。
LLM의 작업 제안
→ 정책 검사
→ 사용자 또는 관리자 승인
→ 실제 실행
以失败和绕过为前提进行测试
通过一次提示测试并不意味着模型是安全的。
需要利用表达方式变更、多语言输入、编码、角色扮演、间接提示注入等多种变体进行持续检查。
限制损害的结构比完美防御更重要
将生成式AI安全的目标设定为“使模型绝不做出错误行为”,将使现实的安全设计变得困难。
一个更现实的目标是:
即使模型做出错误判断或被攻击绕过,也能确保重要数据和系统不受损害。
这与现有安全的零信任原则相通。
就像不无条件信任用户一样,也不应无条件信任LLM。模型的输出应被视为一个请求或建议,实际的权限判断和执行与否应由独立的安全层决定。
사용자
→ LLM
→ 보안 Wrapper
   ├── 인증 확인
   ├── 권한 검사
   ├── 입력값 검증
   ├── 정책 적용
   └── 승인 여부 확인
→ 외부 도구 실행
在这种结构中,即使LLM遵循攻击者的指令,安全包装器也能阻止未经授权的操作。
NIST AI风险管理框架强调的方向也与此类似。AI风险管理并非一次性的清单工作,而是一个通过“治理(Govern)”、“映射(Map)”、“衡量(Measure)”、“管理(Manage)”活动,在开发、部署、运营全过程中反复执行的管理体系。生成式AI安全也应综合设计运营策略、权限、验证和监控,而非仅仅依赖于单个模型的性能或安全过滤器。
生成式AI安全的起点
LLM提供了卓越的性能,但它并非一个在所有情况下都能完美预测或控制行为的系统。
但这并不意味着不能使用LLM。这就像并非因为可能发生车祸就不使用汽车,而是要同时系好安全带、使用刹车并遵守交通规则一样。
生成式AI也需要承认模型的局限性,并同时应用多个安全层。
生成式AI安全并非始于对模型能够被完美控制的信念,而是始于对模型随时可能失败或被绕过的认知。
生成式AI安全的核心在于,与其试图消除模型的不可预测性,不如设计系统以确保这种不确定性不会导致实际的数据泄露、权限滥用或系统入侵。
发表回复