当您向大型语言模型输入问题时,屏幕上会出现自然流畅的句子。它们如此自然,以至于感觉模型像人一样完整地阅读句子,理解其含义,然后从记忆中取出存储的答案。
然而,实际的处理过程并非如此。LLM不会直接处理我们输入的整个句子。首先,它将文本分割成称为词元(token)的更小单位,将每个词元转换为数字,然后在有限的上下文窗口(context window)内计算词元之间的关系。然后,它选择一个在当前语境下最有可能出现的词元。选定的词元会再次添加到语境中,并重复相同的计算。
사용자 입력
→ 토큰화
→ 토큰 ID와 벡터 변환
→ 컨텍스트 안의 관계 계산
→ 다음 토큰 확률 예측
→ 토큰 하나 선택
→ 컨텍스트에 추가
→ 종료 조건까지 반복
理解这个流程可以同时解释“为什么同一个问题答案会略有不同”、“为什么输入长文档时会遗漏部分内容”、“为什么对话变长时会忘记前面的指令”以及“为什么词元数量会影响成本和速度”。
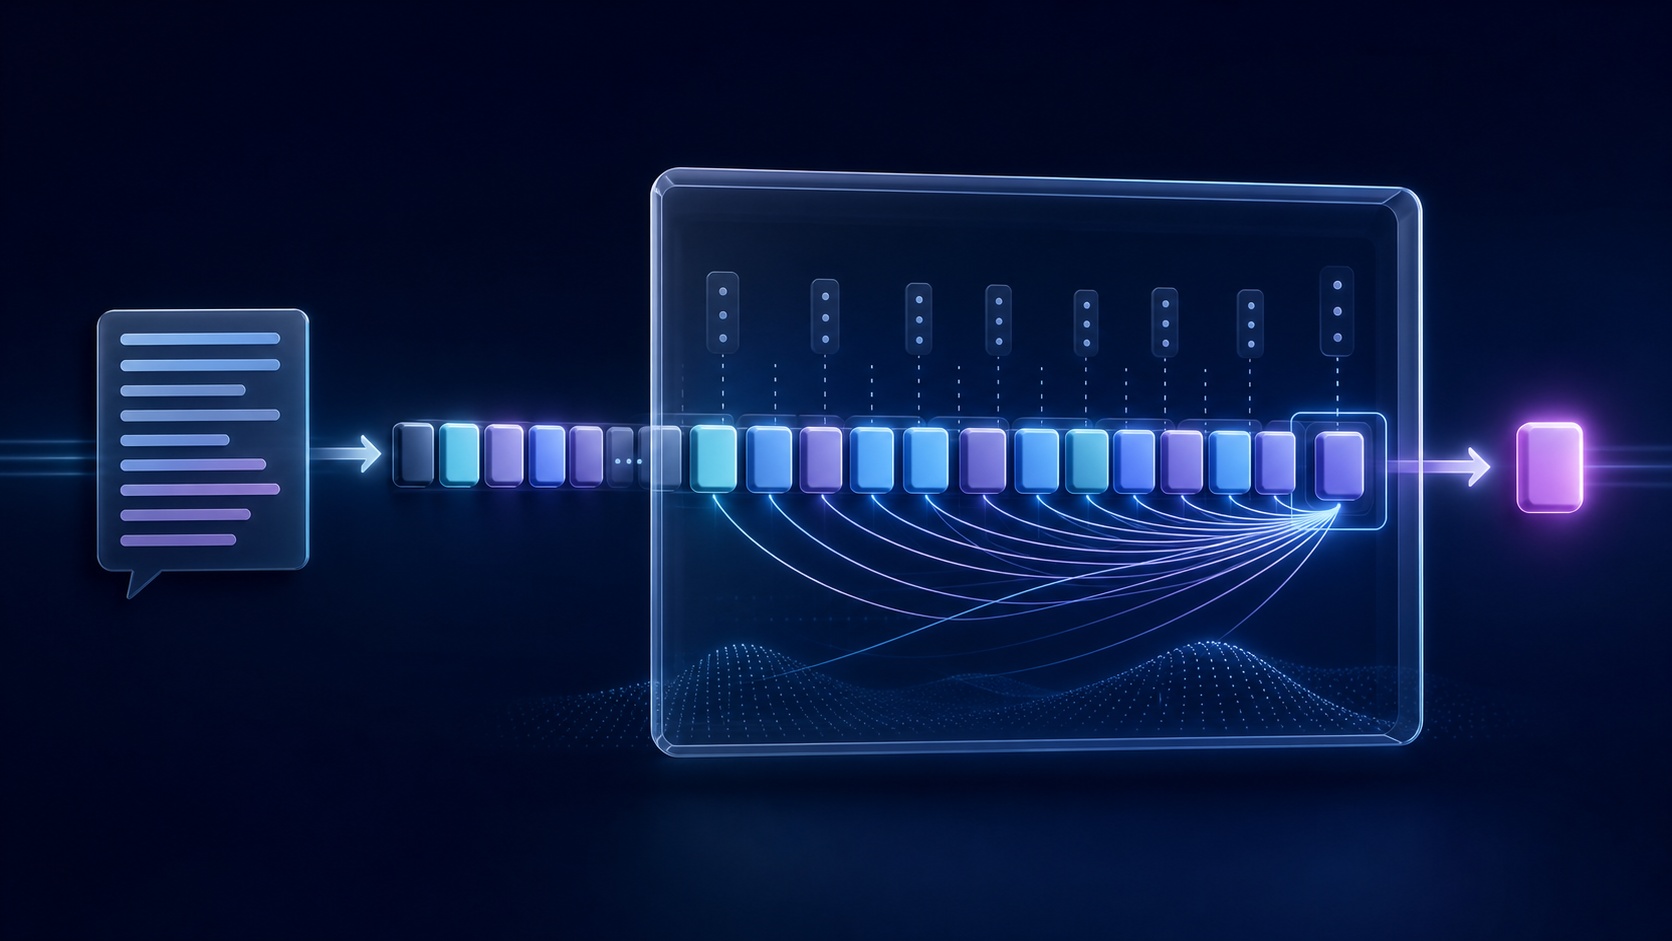
LLM看到的是词元,而非句子
词元是模型处理文本的基本单位。一个词元并不总是代表一个单词。短而常用的单词可能是一个词元,但长单词可能会被分成多个片段。空格和标点符号也可能成为独立的词元,并且根据实现方式,空格可能包含在下一个单词片段中。
概念上,可以考虑以下分割方式:
"생성형 AI는 문장을 토큰으로 처리한다"

→ ["생성", "형", " AI", "는", " 문장", "을", " 토큰", "으로", " 처리", "한다"]
此示例旨在说明原理。实际结果会因模型使用的分词器和词汇表而异。即使是同一个句子,GPT系列、Llama系列和BERT系列模型也可能以不同的方式进行分割。
使用比单词更小的子词(subword)单位的原因是为了在词汇表大小和表达能力之间保持平衡。
- 如果只使用单词单位,则难以处理词典中没有的新词、错别字或专有名词。
- 如果只使用字符单位,几乎可以表达所有句子,但输入长度会过度增加。
- 子词将频繁出现的字符串组合成较大的单元,并将不常见的字符串分割成较小的片段。
因此,即使是首次出现的产品名称或新造词,也不会被视为一个完全未知的单词,而是可以表示为已知小片段的组合。
分词并非简单地按空格分割
实际的分词器更像是一个包含多个步骤的流水线。Hugging Face Tokenizers 文档将典型流程描述为规范化、预分词、子词模型和后处理阶段。
원문
→ Normalizer
→ Pre-tokenizer
→ Subword model
→ Post-processor
→ Token ID 배열
规范化
此阶段涉及统一大小写字母、整理 Unicode 表示或将特定字符转换为标准形式。并非所有模型都使用相同的规范化。有些模型会保留大小写,规范化规则也可能因训练目的而异。
预分词
这是根据空格或标点符号等初步分割文本的阶段。像英语这样单词边界通过空格相对清晰的语言,与像韩语这样助词和词尾与词根结合的语言,其词元分布可能会有所不同。
子词分割
这涉及使用BPE、WordPiece、Unigram、SentencePiece等方法将字符串分割成模型词汇表中存在的片段。尽管这些算法的详细目标不同,但它们的共同目的是用有限的词汇表高效地表示各种字符串。
添加特殊词元
根据模型不同,会添加表示句子开始和结束、说话者角色、分隔符、填充等特殊词元。在聊天API中,开发者看到的 메시지 可能是简单的 system、user、assistant 结构,但当传递给模型时,可能会添加表示角色和边界的内部词元和模板。
因此,仅凭屏幕上可见的字符数难以准确得知实际的输入词元数量。
以英语标准估算韩语词元数量可能会出错
“一个英语词元大约是几个字符”之类的经验法则经常被提及,但将其直接应用于韩语可能会导致较大的误差。
韩语中,助词和词尾与词根结合,并且处理韩语音节的方式也因分词器而异。即使是含义相同的句子,其词元数量也可能因语言和书写方式而大相径庭。代码、URL、长数字、表情符号和不熟悉的产品名称也可能使用比预期更多的词元。
사람이 보는 길이
≠ 단어 수
≠ 글자 수
≠ 모델이 계산하는 토큰 수
如果成本或上下文使用量对系统至关重要,则不应仅使用估算值,而应使用与实际部署模型兼容的分词器进行测量。如果模型发生变化,分词器和聊天模板也可能随之改变,因此需要进行回归测试。
词元转换为数字和向量
分词完成后,每个词元都会被转换为词汇表中定义的整数ID。
["생성", "형", " AI"]
→ [18452, 317, 9552]
这些数字并不直接表示单词的含义。它们更像是用于在词典中查找词元的标识符。模型通过这些ID在嵌入表中查询,将其转换为高维向量。
Token ID
→ Embedding vector
→ Transformer layer
→ 문맥을 반영한 표현
最初的嵌入是词元本身的学习表示。随后,当它通过 Transformer 层时,同一个词元会根据其周围的上下文获得不同的内部表示。
例如,“银行”这个字符串可以指金融机构,也可以指河岸。模型通过计算与周围词元的关系来反映在当前句子中更接近哪种含义。此时,发挥核心作用的结构是自注意力(Self-Attention)。
上下文窗口是模型在当前计算中可以参考的工作空间
上下文窗口是模型在生成单个响应时可以参考的词元范围。它常被描述为LLM的记忆容量,但更准确的看法是,它是一个用于处理当前请求的有限工作空间,而非永久记忆。
在聊天服务中,上下文不仅包含用户刚刚输入的问题。
시스템·개발자 지시
+ 이전 사용자 메시지
+ 이전 모델 응답
+ 현재 사용자 질문
+ RAG로 검색한 문서
+ 도구 실행 결과
+ 이미지·파일에서 변환된 입력
+ 새로 생성할 응답 토큰
= 전체 컨텍스트 사용량
开发者未直接编写的内部格式和特殊词元也会占用部分空间。如果工具定义或 JSON 模式很长,它们也可能包含在输入词元中。
让我们假设一个上下文限制为100的简单模型。
| 组成部分 | 使用词元 |
| — | — |
| 系统指令 | 10 |
| 先前对话 | 35 |
| 搜索文档 | 25 |
| 当前问题 | 10 |
| 为响应预留空间 | 20 |
| 总计 | 100 |
如果在这里再添加20个词元用于搜索文档,就会超出总限制。此时,系统必须拒绝请求,或截断旧对话,或减少搜索文档,或缩短最大可响应长度。
也就是说,上下文窗口为100个词元,并不意味着输入可以全部使用100个词元。还需要同时考虑输出将使用的词元预算。
长对话中遗忘先前内容的原因
当对话变长时,服务无法无限地将所有消息传递给模型。当接近上下文限制时,会采用以下策略:
- 删除最旧的消息。
- 总结过去的对话,使其更短。
- 只选择相关性高的消息。
- 截断附件文档或工具结果的一部分。
- 如果输入过大,则使请求本身失败。
例如,OpenAI Responses API 的截断选项区分了当输入超出上下文限制时自动删除较早的对话项,以及不使用自动截断并返回错误的方式。尽管具体策略因服务和 API 而异,但重要原理是相同的。
即使模型看起来记住了过去的对话,实际上也往往是因为这些内容被重新包含在当前上下文中,从而可以被参考。
如果过去的 메시지 被截断或错误地总结,模型就无法在当前计算中直接看到这些内容。这也是为什么用户最初设定的输出格式或重要约束条件在对话后期可能会被模型忽略的原因。
并非上下文窗口内的所有内容都能同样被良好记住
上下文限制较长意味着可以放入许多词元。但这并不意味着所有输入信息都能始终被准确地利用。
模型通过注意力机制计算每个词元与其他词元的相关性。然而,长输入可能包含相似信息、不相关信息、冲突指令和重复句子。如果重要事实被埋藏在数十万个词元之间,模型可能会忽略它们或将其视为不那么重要。
长上下文可能出现的问题如下:
- 遗漏文档中间的关键信息。
- 如果前后指令冲突,一致性会受到影响。
- 错误地关联相似的名称或数字。
- 如果搜索结果过多,会受到不相关信息的影响。
- 输入词元增加导致成本和首次响应延迟时间增加。
因此,“上下文越长越好”的说法并不准确。实际质量不仅受上下文长度的影响,还受信息选择、布局、结构、冗余和冲突情况的影响。
注意力机制连接上下文,但并非永久存储
Transformer 的自注意力机制计算当前上下文中词元之间的关系。直观上,可以将其理解为为每个词元创建权重,以确定它应该参考其他词元的程度。
Query: 지금 처리하는 토큰이 찾으려는 정보
Key: 각 토큰이 가진 검색 단서
Value: 실제로 전달할 정보
它通过比较当前位置的查询(Query)与先前词元的键(Key)来计算相关性,然后用这些权重结合值(Value)。这个计算在多个头和多个层中重复进行,从而反映出语法关系、指代、主题、格式、代码结构等多种模式。
然而,注意力机制与数据库检索不同。它不是通过键精确查询特定句子,也不是在模型内部永久存储对话内容的功能。它是一种基于当前输入的词元计算所需表示的机制。
响应是逐个词元生成的
上下文处理完成后,模型会计算所有可能出现在下一个位置的词元的分数,并将其转换为概率分布。
현재 문맥: "컨텍스트 윈도우는 모델의"

다음 토큰 후보
작업: 31%
기억: 24%
입력: 18%
처리: 11%
기타: 16%
模型从这个分布中选择下一个词元。它可能总是选择得分最高的词元,也可能根据 Temperature 或 Top-p 等采样设置从多个候选词元中选择一个。
选定的词元会立即附加到上下文的末尾。
1단계: "컨텍스트 윈도우는 모델의"
예측: "작업"

2단계: "컨텍스트 윈도우는 모델의 작업"
예측: "공간"

3단계: "컨텍스트 윈도우는 모델의 작업 공간"
예측: "입니다"
这个过程会重复,直到选择到终止词元、达到最大输出长度或满足停止条件。
这意味着LLM并非一次性完成长篇回答并显示出来,而是将前面生成的内容再次用作上下文,逐个词元地连接。因此,如果在早期选择了错误的假设,后续的句子也会自然地延续该假设,从而可能产生更复杂的错误。
同一个问题出现不同答案的原因
下一个词元候选的概率很少只有一个是100%。多种表达在语法或语义上都可能很自然。如果启用了采样,即使是同一个问题,也可能选择不同的词元,这种差异会改变后续的整个句子。
输出还会受到以下因素的影响:
- 系统和开发者指令
- 先前对话内容和顺序
- 检索到的外部文档
- 工具执行结果
- 模型版本和分词器
- Temperature 和 Top-p
- 最大输出长度
- 安全策略和输出后处理
因此,LLM的响应与其说是查询固定答案的结果,不如说是在给定上下文和生成设置下生成的一条路径。
词元预测与事实核查是不同的问题
模型预测下一个词元的自然度。这个过程本身并不意味着从数据库中验证事实。
由于在训练过程中学习了大量事实和模式,它经常能生成准确的答案,但在缺乏确凿证据的情况下,它也能继续生成看似合理的句子。这是产生幻觉的基本背景之一。
언어적으로 자연스러운 다음 토큰
≠ 외부 세계에서 검증된 사실
在对准确性要求高的任务中,应结合使用官方资料检索、RAG、计算工具、代码执行、数据库查询等外部验证手段。而且,将外部资料放入上下文并不意味着自动保证正确答案。需要准确检索相关文档,放入足够的部分,并区分来自不同来源的主张。
RAG并非使上下文更长,而是更好地选择上下文的技术
RAG(检索增强生成)是一种检索与问题相关的文档并将其内容添加到模型上下文中的结构。
사용자 질문
→ 관련 문서 검색
→ 필요한 구간 선택
→ 질문과 함께 컨텍스트 구성
→ LLM 응답 생성
好的 RAG 的核心并非放入大量文档。它是关于在有限的上下文中放置高度相关的信息,以便模型能够找到回答所需的依据。
无条件地放入过多的搜索结果可能会导致以下问题:
- 重要文档被埋没在不相关文档之间。
- 相互冲突的文档版本被同时包含。
- 词元成本和延迟时间增加。
- 可能暴露于恶意文档的间接提示注入。
因此,文档分割大小、检索数量、重新排序、去重、来源标注和置信度过滤都很重要。
长上下文的实用设计
保持重要指令简短明确
将核心要求整理到单独的区域,而不是将其埋藏在冗长的背景说明中。
[목표]
점검 결과를 경영진용으로 요약한다.

[반드시 지킬 조건]
- 확인되지 않은 사실을 만들지 않는다.
- 위험도와 근거를 함께 표시한다.
- 표는 5행 이내로 작성한다.

[참고 자료]
...
总结当前工作状态而非旧对话
如果代理正在执行一项长期任务,最好以结构化的方式维护当前目标、已完成步骤、失败原因和剩余任务的摘要,而不是持续累积所有日志。
只检索并放入文档中必要的部分
与其无条件地放入数百页的文档,不如搜索与问题相关的部分,并提供搜索结果的来源和文档版本。
分开管理输入和输出预算
将输入填满到上限可能不会留下足够的响应空间。应预留余量,包括预期的输出长度和工具调用结果。
观察实际词元使用量
利用 API 响应中的 usage 信息或兼容的分词器记录输入和输出词元。不仅要检查平均值,还要查看长请求的上限百分位数,以防止成本突然增加或超出限制。
import tiktoken

encoding = tiktoken.get_encoding("o200k_base")
text = "LLM은 문장을 토큰으로 나누어 처리합니다."

token_ids = encoding.encode(text)

print(token_ids)
print("token count:", len(token_ids))
此示例是一个简单的代码,用于验证分词原理。实际 API 模型的词元计算可能包含模型特定的编码、消息格式、特殊词元和工具定义,因此应同时查阅官方 SDK 和模型文档。
常见误解
| 误解 | 更接近实际的解释 |
| — | — |
| 词元等同于单词 | 单词、子词、空格、标点符号、字节片段等都可以是词元。 |
| 上下文窗口是模型的永久记忆 | 它更接近于当前响应计算可用的有限工作空间。 |
| 只要在限制内,所有内容都能准确找到 | 在长输入中,重要信息可能会被埋没或冲突。 |
| 输出是一次性完成的 | 它逐个预测下一个词元,并将其重新添加到上下文中。 |
| 下一个词元预测是简单的自动补全 | 它是通过大规模训练和多个 Transformer 层计算复杂上下文表示的自回归生成。 |
| 自然流畅的句子就是事实 | 自然流畅与事实核查是两个独立的问题。 |
| 上下文很长就不需要 RAG | 为了时效性、成本、访问控制和来源追踪,检索和选择过程仍然很重要。 |
再次连接整个过程
LLM 的响应生成可以总结如下:
- 用户的文本、系统指令、先前对话和检索到的文档构成一个输入。
- 分词器将输入分割成以子词为中心的词元。
- 每个词元被转换为整数 ID 和嵌入向量。
- Transformer 使用注意力机制计算上下文窗口内词元之间的关系。
- 生成最后一个位置之后下一个词元的概率分布。
- 根据生成设置选择一个词元。
- 将选定的词元添加到上下文中,并重复相同的计算。
- 当达到终止词元或输出限制时,将词元解码回字符串并作为响应显示。
텍스트
→ 토큰
→ 토큰 ID
→ 임베딩
→ Attention과 Transformer
→ 다음 토큰 확률
→ 토큰 선택
→ 반복 생성
→ 텍스트 응답
结论
理解 LLM 的最佳起点是暂时放下“模型理解句子并取出答案”的印象。
模型将文本转换为词元,计算当前上下文窗口内词元之间的关系,然后逐个生成下一个词元。上下文窗口是进行这些计算的有限工作空间,能够放入长上下文与准确利用其内容是两回事。
了解这个原理会改变提示的编写方式。它会促使您明确放置重要指令,减少不必要的上下文,总结长对话,通过 RAG 选择必要的依据,并同时管理输入和输出的词元预算。
LLM 的质量并非仅由模型大小决定。将哪些信息分词并放入上下文中,以及如何组织这个有限的空间,将极大地影响实际的响应质量。
发表回复