大規模言語モデルに質問を入力すると、画面には自然な文章が表示されます。あまりにも自然なので、モデルが文章を丸ごと読み込み、人間のように意味を理解し、頭の中に保存された答えを取り出しているかのように感じられます。
しかし、実際の処理過程はこれとは異なります。LLMは私たちが入力した文章をそのまま扱うわけではありません。まずテキストを小さな単位であるトークン(token)に分割し、各トークンを数字に変換した後、制限されたコンテキストウィンドウ(context window)内でトークン間の関係を計算します。そして、現在の文脈の次に続く可能性が高いトークンを一つ選択します。選択されたトークンは再び文脈に追加され、同じ計算が繰り返されます。
사용자 입력
→ 토큰화
→ 토큰 ID와 벡터 변환
→ 컨텍스트 안의 관계 계산
→ 다음 토큰 확률 예측
→ 토큰 하나 선택
→ 컨텍스트에 추가
→ 종료 조건까지 반복
この流れを理解すれば、「なぜ同じ質問でも答えが少しずつ異なるのか」、「長い文書を入力したのに一部の内容を見落とすのはなぜか」、「会話が長くなると前の指示を忘れるのはなぜか」、「トークン数がコストと速度に影響を与えるのはなぜか」といった疑問を一挙に説明できます。
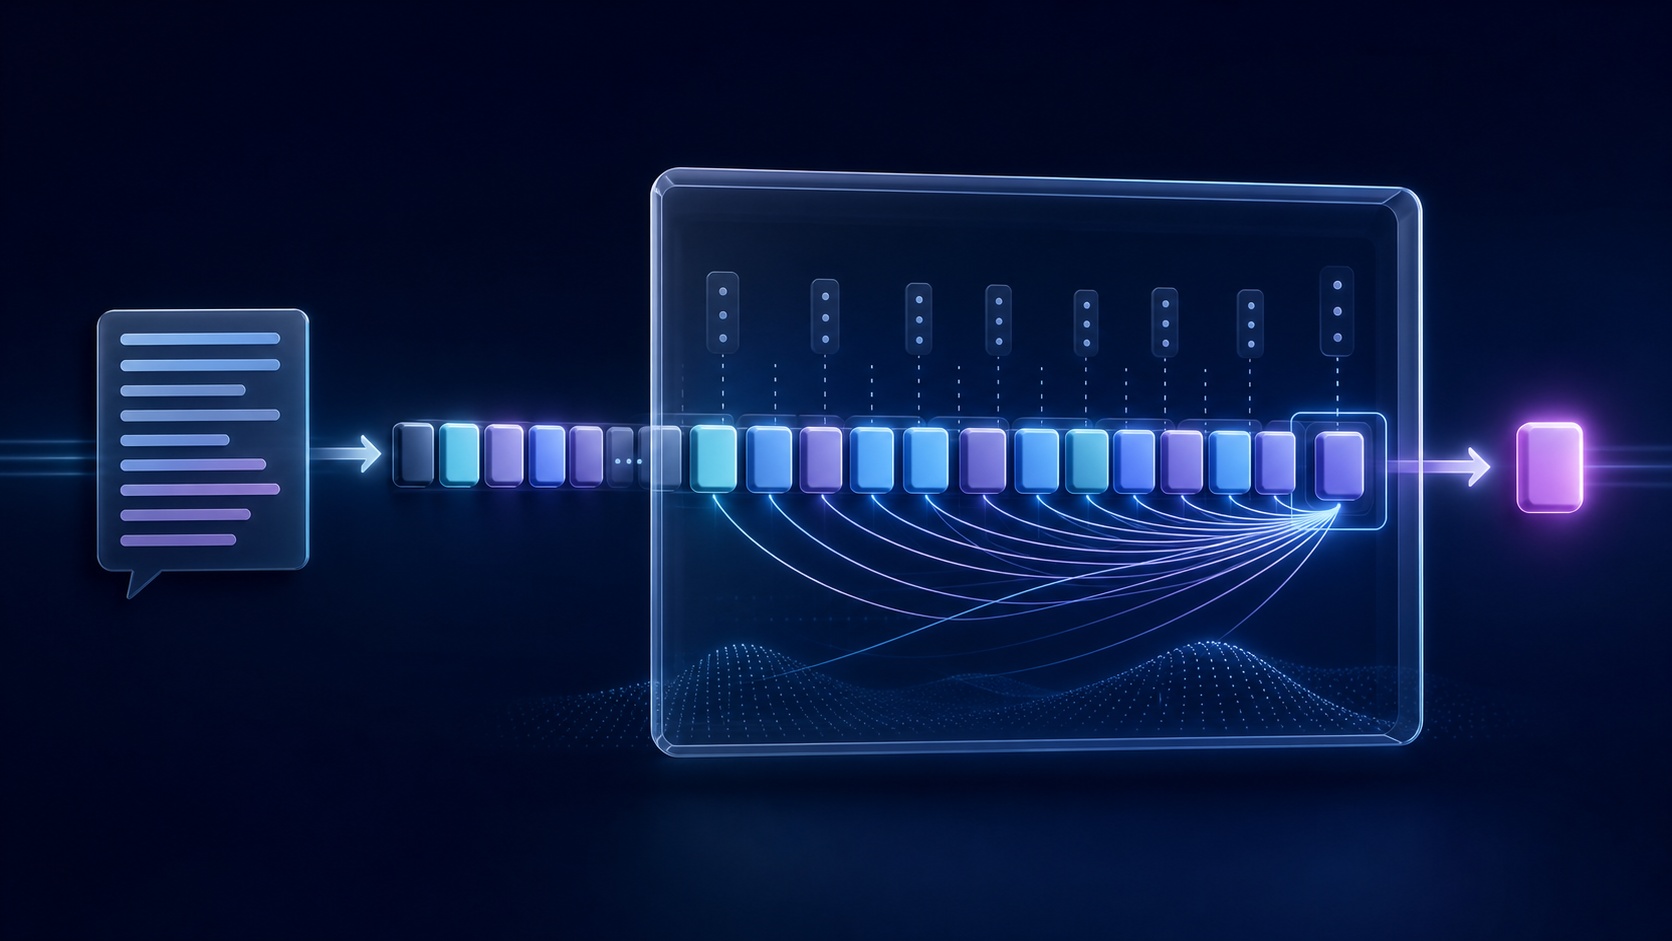
LLMは文章ではなくトークンを見る
トークンは、モデルがテキストを処理する基本単位です。一つのトークンが常に一つの単語を意味するわけではありません。短く頻繁に使われる単語は一つのトークンになることがありますが、長い単語は複数の断片に分割されることがあります。空白や句読点が別々のトークンになることもあり、実装によっては空白が次の単語の断片に含まれることもあります。
概念的には、以下のような分割を考えることができます。
"생성형 AI는 문장을 토큰으로 처리한다"

→ ["생성", "형", " AI", "는", " 문장", "을", " 토큰", "으로", " 처리", "한다"]
この例は原理を説明するためのものです。実際の結果は、モデルが使用するトークナイザーと語彙辞書によって異なります。同じ文章であっても、GPT系、Llama系、BERT系のモデルでは異なる分割が行われることがあります。
このように単語よりも小さいサブワード(subword)単位を使用する理由は、語彙辞書のサイズと表現力のバランスを保つためです。
- 単語単位のみを使用すると、辞書にない新語、誤字脱字、固有名詞の処理が困難になります。
- 文字単位のみを使用すると、ほぼすべての文章を表現できますが、入力長が過度に長くなります。
- サブワードは、頻繁に登場する文字列は大きくまとめ、稀な文字列はより小さな断片に分割します。
そのため、初めて見る製品名や新しく作られた単語も、完全に未知の単語として処理するのではなく、すでに知っている小さな断片の組み合わせで表現することができます。
トークン化は単に空白で分割する作業ではない
実際のトークナイザーは、複数の段階を経るパイプラインに近いものです。Hugging Face Tokenizersのドキュメントでは、代表的な流れを正規化、事前分割、サブワードモデル、後処理の段階で説明しています。
원문
→ Normalizer
→ Pre-tokenizer
→ Subword model
→ Post-processor
→ Token ID 배열
正規化
大文字と小文字を統一したり、Unicode表現を整理したり、特定の文字を標準形式に変換する段階です。すべてのモデルが同じ正規化を使用するわけではありません。大文字小文字を保存するモデルもあり、学習目的によって正規化ルールが異なる場合があります。
事前分割
空白や句読点などを基準にテキストを一次的に分割します。英語のように空白で単語の境界が比較的明確に現れる言語と、韓国語のように助詞や語尾が結合する言語では、トークン分布が異なる場合があります。
サブワード分割
BPE、WordPiece、Unigram、SentencePieceなどの方式で、文字列をモデルの語彙辞書に存在する断片に分割します。アルゴリズムの細かな目標は異なりますが、共通の目的は、限られた語彙辞書で多様な文字列を効率的に表現することです。
特殊トークンの追加
モデルによっては、文の開始と終了、話者の役割、区切り文字、パディングなどを表す特殊トークンが追加されます。チャットAPIで開発者が見るメッセージは単純なsystem、user、assistant構造ですが、モデルに渡される際には、役割と境界を表現する内部トークンとテンプレートが追加されることがあります。
したがって、画面に表示される文字数だけを数えても、実際の入力トークン数を正確に知ることは困難です。
韓国語のトークン数を英語基準で推定すると誤りがある可能性がある
「英語の1トークンはおおよそ何文字」といった経験則がよく紹介されますが、これを韓国語にそのまま適用すると誤差が大きくなる可能性があります。
韓国語は語根に助詞や語尾が結合し、ハングル音節の処理方法もトークナイザーごとに異なります。同じ意味の文章であっても、言語や表記方法によってトークン数が大きく異なることがあります。コード、URL、長い数字、絵文字、馴染みのない製品名も、予想よりも多くのトークンを使用する可能性があります。
사람이 보는 길이
≠ 단어 수
≠ 글자 수
≠ 모델이 계산하는 토큰 수
コストやコンテキスト使用量が重要なシステムであれば、推定値だけを使用せず、実際にデプロイされているモデルと互換性のあるトークナイザーで測定する必要があります。モデルが変更されると、トークナイザーとチャットテンプレートも一緒に変わる可能性があるため、回帰テストが必要です。
トークンは数字とベクトルに変わる
トークン化が終わると、各トークンは語彙辞書に定義された整数IDに変換されます。
["생성", "형", " AI"]
→ [18452, 317, 9552]
この数字は単語の意味を直接表す値ではありません。辞書からトークンを探すための識別子に近いものです。モデルはこのIDを埋め込みテーブルで検索し、高次元ベクトルに変換します。
Token ID
→ Embedding vector
→ Transformer layer
→ 문맥을 반영한 표현
最初の埋め込みはトークン自体の学習された表現です。その後、Transformerレイヤーを通過するにつれて、同じトークンも周囲の文脈に応じて異なる内部表現を持つようになります。
例えば、「銀行」という文字列は金融機関を意味することもあれば、川岸を意味することもあります。モデルは周囲のトークンとの関係を計算しながら、現在の文章でどちらの意味に近いかを反映します。このとき、核となる役割を果たす構造がSelf-Attentionです。
コンテキストウィンドウはモデルが現在の計算に参照できる作業空間である
コンテキストウィンドウは、一度の応答を生成する際にモデルが参照できるトークンの範囲です。しばしばLLMの記憶容量のように説明されますが、永続的な記憶というよりも現在のリクエストを処理するための制限された作業空間と見る方が正確です。
チャット型サービスでは、コンテキストにはユーザーが今入力した質問だけが入るわけではありません。
시스템·개발자 지시
+ 이전 사용자 메시지
+ 이전 모델 응답
+ 현재 사용자 질문
+ RAG로 검색한 문서
+ 도구 실행 결과
+ 이미지·파일에서 변환된 입력
+ 새로 생성할 응답 토큰
= 전체 컨텍스트 사용량
開発者が直接作成していない内部フォーマットや特殊トークンも一部の空間を使用します。ツール定義やJSONスキーマが長い場合、これも入力トークンに含まれることがあります。
コンテキストの限度が100という単純なモデルを仮定してみましょう。
| 構成要素 | 使用トークン |
| — | — |
| システム指示 | 10 |
| 以前の会話 | 35 |
| 検索文書 | 25 |
| 現在の質問 | 10 |
| 応答のために残された空間 | 20 |
| 合計 | 100 |
ここで検索文書をさらに20トークン追加すると、全体の限度を超えます。このとき、システムはリクエストを拒否するか、古い会話を切り詰めるか、検索文書を減らすか、応答可能な最大長を減らす必要があります。
つまり、コンテキストウィンドウが100トークンだからといって、入力に100トークンすべてを使用できるわけではありません。出力が使用するトークン予算も一緒に考慮する必要があります。
長い会話で前の内容を忘れる理由
会話が長くなると、サービスはすべてのメッセージを無限にモデルに渡すことはできません。コンテキストの限度に近づくと、次のような戦略を使用します。
- 最も古いメッセージを削除する。
- 過去の会話を要約して短くする。
- 関連度の高いメッセージのみを選択する。
- 添付文書やツール結果の一部を切り詰める。
- 入力が大きすぎる場合は、リクエスト自体を失敗させる。
例えば、OpenAI Responses APIのtruncationオプションは、入力がコンテキストの限度を超えたときに自動的に前方の会話項目を削除する方法と、自動切り詰めを使用せずにエラーを返す方法を区別します。具体的なポリシーはサービスとAPIによって異なりますが、重要な原理は同じです。
モデルが過去の会話を記憶しているように見えても、実際にはその内容が現在のコンテキストに再び含まれているため、参照できる場合が多い。
過去のメッセージが切り詰められたり、誤って要約されたりすると、モデルはその内容を現在の計算で直接見ることができません。ユーザーが最初に定めた出力形式や重要な制約条件を会話の後半で見落とす理由もここにあります。
コンテキストウィンドウ内にあるからといって、すべてが同じようにうまく記憶されるわけではない
コンテキストの限度が長いということは、多くのトークンを入れることができるという意味です。入力されたすべての情報を常に正確に活用するという意味ではありません。
モデルは各トークンが他のトークンとどれだけ関連しているかをAttentionで計算します。しかし、長い入力には互いに似た情報、無関係な情報、衝突する指示、繰り返された文章が一緒に入ることがあります。重要な事実が数十万トークンの間に埋もれてしまうと、モデルがそれを見落としたり、重要度が低いと扱ったりする可能性があります。
長いコンテキストで発生する可能性のある問題は以下の通りです。
- 文書の途中にある核心情報を見落とす。
- 前後の指示が衝突すると一貫性が揺らぐ。
- 似た名前や数字を誤って関連付ける。
- 検索結果が多すぎると関連のない情報に影響される。
- 入力トークン増加によりコストと初回応答遅延時間が増える。
そのため、「コンテキストが長ければ長いほど無条件に良い」という言葉は正確ではありません。実際の品質は、コンテキストの長さだけでなく、情報の選択、配置、構造、重複、衝突の有無に影響されます。
Attentionは文脈を接続するが、永続的な保存場所ではない
TransformerのSelf-Attentionは、現在のコンテキストにあるトークン間の関係を計算します。直感的には、各トークンが他のトークンをどれだけ参照すべきかという重みを作成する過程として理解できます。
Query: 지금 처리하는 토큰이 찾으려는 정보
Key: 각 토큰이 가진 검색 단서
Value: 실제로 전달할 정보
現在の位置のQueryと先行するトークンたちのKeyを比較して関連度を求め、その重みでValueを結合します。この計算が複数のヘッドと複数のレイヤーで繰り返されることで、文法関係、対象の指称、主題、形式、コード構造といった多様なパターンが反映されます。
ただし、Attentionはデータベース検索とは異なります。特定の文章をキーで正確に照会するものではなく、モデル内部に会話内容を永続的に保存する機能でもありません。現在入力されたトークンを基に必要な表現を計算するメカニズムです。
応答は次のトークンを一つずつ生成される
コンテキスト処理が終わると、モデルは次の位置に来る可能性のあるすべてのトークンのスコアを計算し、確率分布に変換します。
현재 문맥: "컨텍스트 윈도우는 모델의"

다음 토큰 후보
작업: 31%
기억: 24%
입력: 18%
처리: 11%
기타: 16%
モデルはこの分布から次のトークンを選択します。最もスコアが高いトークンを常に選択することもできますし、TemperatureやTop-pのようなサンプリング設定に応じて複数の候補の中から一つを選択することもできます。
選択されたトークンは直ちにコンテキストの末尾に付加されます。
1단계: "컨텍스트 윈도우는 모델의"
예측: "작업"

2단계: "컨텍스트 윈도우는 모델의 작업"
예측: "공간"

3단계: "컨텍스트 윈도우는 모델의 작업 공간"
예측: "입니다"
この過程は、終了トークンが選択されるか、最大出力長に達するか、中断条件が満たされるまで繰り返されます。
LLMが長い答えを一度に完成させて画面に表示するのではなく、前に生成した内容を再び文脈として使用しながらトークンを一つずつ繋げていくという意味です。そのため、序盤で誤った前提を選択すると、後の文章もその前提を自然に引き継ぎ、より精巧な誤りを生み出す可能性があります。
同じ質問に異なる答えが出る理由
次のトークン候補の確率が一つだけ100%であることは稀です。複数の表現が文法的に、あるいは意味的に自然である可能性があります。サンプリングが有効になっている場合、同じ質問に対しても異なるトークンが選択されることがあり、その違いがその後の文章全体を変えることになります。
出力は次の要素にも影響を受けます。
- システムと開発者の指示
- 以前の会話内容と順序
- 検索された外部文書
- ツール実行結果
- モデルバージョンとトークナイザー
- TemperatureとTop-p
- 最大出力長
- 安全ポリシーと出力後処理
したがって、LLMの応答は、定められた答えを照会した結果というよりも、与えられたコンテキストと生成設定から作られた一つの経路です。
トークン予測と事実確認は別の問題である
モデルは次のトークンの自然さを予測します。この過程自体が、事実をデータベースで検証するという意味ではありません。
学習過程で多くの事実とパターンを習得しているため、正確な答えを頻繁に生成できますが、確実な根拠がない状況でもそれらしい文章を続けることができます。これが幻覚が発生する基本的な背景の一つです。
언어적으로 자연스러운 다음 토큰
≠ 외부 세계에서 검증된 사실
正確性が重要な業務では、公式資料検索、RAG、計算ツール、コード実行、データベース照会のような外部検証手段を併用する必要があります。そして、外部資料をコンテキストに入れたからといって、自動的に正解が保証されるわけではありません。関連文書を正確に検索し、十分な部分を入れ、出所が異なる主張を区別する必要があります。
RAGはコンテキストを長くする技術ではなく、より適切に選択する技術である
RAGは、質問に関連する文書を検索し、その内容をモデルのコンテキストに追加する構造です。
사용자 질문
→ 관련 문서 검색
→ 필요한 구간 선택
→ 질문과 함께 컨텍스트 구성
→ LLM 응답 생성良いRAGの核心は、文書をたくさん入れることではありません。モデルが答えに必要な根拠を見つけられるように、関連性の高い情報を制限されたコンテキストの中に配置することです。
検索結果を無条件にたくさん入れると、次の問題が生じる可能性があります。
- 重要な文書が関連のない文書の間に埋もれる。
- 互いに衝突するバージョンの文書が一緒に入る。
- トークンコストと遅延時間が増加する。
- 悪意のある文書による間接的なプロンプトインジェクションに晒される可能性がある。
したがって、文書分割サイズ、検索個数、再順序付け、重複除去、出所表示、信頼度フィルタリングが重要です。
長いコンテキストをうまく使う実務設計
重要な指示は短く明確に保つ
核心となる要件を長い背景説明の間に埋もれさせず、別途の区画に整理します。
[목표]
점검 결과를 경영진용으로 요약한다.

[반드시 지킬 조건]
- 확인되지 않은 사실을 만들지 않는다.
- 위험도와 근거를 함께 표시한다.
- 표는 5행 이내로 작성한다.

[참고 자료]
...
古い会話よりも現在の作業状態を要約する
エージェントが長いタスクを実行する場合、すべてのログを継続的に蓄積するよりも、現在の目標、完了した段階、失敗原因、残りの作業を構造化して維持する方が良いです。
文書は必要な部分だけを検索して入れる
数百ページ全体を無条件に入れるよりも、質問に関連する区間を検索し、検索結果の出所と文書バージョンを一緒に提供します。
入力と出力の予算を分離して管理する
入力を限度まで満たすと、十分な応答空間が残らない可能性があります。予想される出力長とツール呼び出し結果まで含めて余裕を持たせる必要があります。
実際のトークン使用量を観測する
API応答のusage情報や互換性のあるトークナイザーを利用して、入力・出力トークンを記録します。平均だけでなく、長いリクエストの上位パーセンタイルも確認することで、突然のコスト増加や限度超過を防ぐことができます。
import tiktoken

encoding = tiktoken.get_encoding("o200k_base")
text = "LLM은 문장을 토큰으로 나누어 처리합니다."

token_ids = encoding.encode(text)

print(token_ids)
print("token count:", len(token_ids))
この例はトークン化の原理を確認するための簡単なコードです。実際のAPIモデルのトークン計算には、モデルごとのエンコーディング、メッセージフォーマット、特殊トークン、ツール定義が追加される可能性があるため、公式SDKとモデル文書を一緒に確認する必要があります。
よくある誤解
| 誤解 | 実際により近い説明 |
| — | — |
| トークンは単語と同じである | 単語、サブワード、空白、句読点、バイト断片などがトークンになり得る。 |
| コンテキストウィンドウはモデルの永続的な記憶である | 現在の応答計算に利用できる制限された作業空間に近い。 |
| 限度内に入れればすべての内容を正確に探す | 長い入力では重要な情報が埋もれたり、衝突したりする可能性がある。 |
| 出力は一度に完成する | 次のトークンを一つずつ予測し、再び文脈に追加する。 |
| 次のトークン予測は単純な自動補完である | 大規模な学習と複数のTransformerレイヤーを通じて複雑な文脈表現を計算する自動回帰生成である。 |
| 自然な文章は事実である | 自然さと事実検証は別々の問題である。 |
| コンテキストが長ければRAGは必要ない | 最新性、コスト、アクセス制御、出所追跡のために検索と選択過程は依然として重要である。 |
全体プロセスを再度つなぎ合わせると
LLMの応答生成は次のようにまとめることができます。
- ユーザーのテキストとシステム指示、以前の会話、検索文書が一つにまとめられ、入力が構成されます。
- トークナイザーが入力テキストをサブワード中心のトークンに分割します。
- 各トークンは整数IDと埋め込みベクトルに変換されます。
- Transformerがコンテキストウィンドウ内のトークン関係をAttentionで計算します。
- 最後の位置の次に続くトークンの確率分布を作成します。
- 生成設定に従ってトークンを一つ選択します。
- 選択されたトークンをコンテキストに追加し、同じ計算を繰り返します。
- 終了トークンまたは出力限度に達すると、トークンを再び文字列にデコードして応答として表示します。
텍스트
→ 토큰
→ 토큰 ID
→ 임베딩
→ Attention과 Transformer
→ 다음 토큰 확률
→ 토큰 선택
→ 반복 생성
→ 텍스트 응답
結論
LLMを理解する最良の出発点は、「モデルが文章を理解し、答えを取り出す」という印象を一時的に手放すことです。
モデルはテキストをトークンに変換し、現在のコンテキストウィンドウ内に入ってきたトークンの関係を計算した後、次のトークンを一つずつ生成します。コンテキストウィンドウはこの計算のための制限された作業空間であり、長い文脈を入れることができるという事実と、その内容を正確に活用するという事実は異なります。
この原理を知ると、プロンプトの作成も変わります。重要な指示を明確に配置し、不要な文脈を減らし、長い会話を要約し、RAGで必要な根拠だけを選択し、入力と出力のトークン予算を一緒に管理するようになります。
LLMの品質はモデルのサイズだけで決定されるわけではありません。どのような情報をトークンとしてコンテキストに入れ、その制限された空間をどのように構成するかが、実際の応答品質を大きく左右します。
コメントを残す