こんにちは!今日は、Argo Workflowsの核となる設計思想であるDAGとSteps、そしてワークフロー間でデータをやり取りする主要な手段であるArtifactについて深く掘り下げていきます。🚀
この記事を読み終える頃には、複雑なパイプラインをどのような構造で設計すべきか、そして前の段階の成果物を次の段階に安全に渡す方法を完全に理解できるようになるでしょう。
Argo Workflowsでタスクを配置する方法は大きく分けて2つあります。それはSteps(順次実行)とDAG(依存関係ベース)です。似ているように見えますが、使用事例とデータ参照方法には大きな違いがあります。
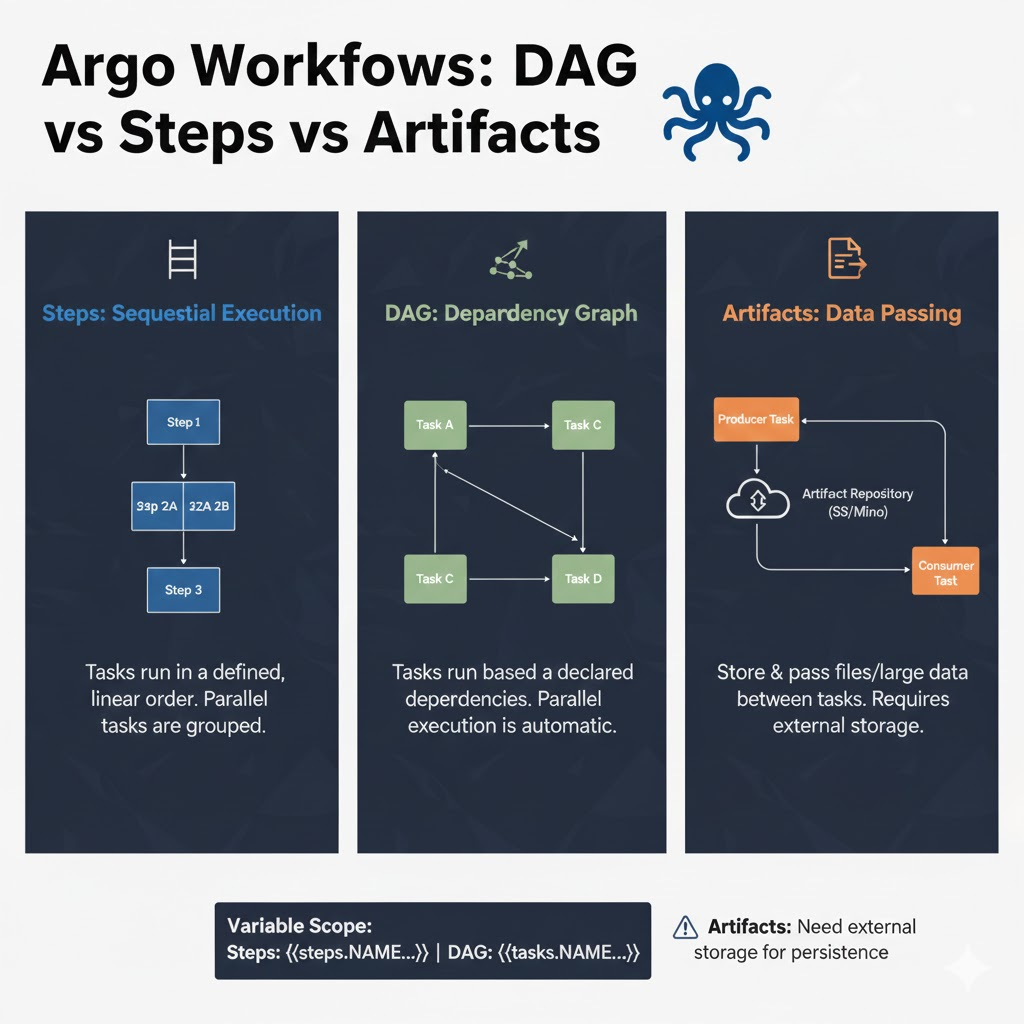
1. Steps: 順次的な段階実行 🪜
Stepsは、文字通りタスクを「段階的に」リストアップする方法です。
✅ どのような場合に使用しますか?
- タスクの流れが上から下へ明確に流れる場合。
- 複数のタスクを同時に実行(並列)したり、特定のグループが終了した後に次のグループに進む必要がある場合。
- 構造が単純で直感的なパイプラインを設計する場合。
📝 コード例と説明 (Steps)
YAML
apiVersion: argoproj.io/v1alpha1
kind: Workflow
metadata:
  generateName: steps-example-
spec:
  entrypoint: main
  templates:
  - name: main
    steps:
    - - name: step1 # 最初のステップ (並列グループ 1)
        template: echo
        arguments: {parameters: [{name: message, value: "Step 1"}]}
    - - name: step2-a # 第二のステップ (並列実行 A)
        template: echo
        arguments: {parameters: [{name: message, value: "Step 2-A"}]}
      - name: step2-b # 第二のステップ (並列実行 B)
        template: echo
        arguments: {parameters: [{name: message, value: "Step 2-B"}]}

  - name: echo
    inputs:
      parameters: [{name: message}]
    container:
      image: alpine:latest
      command: [echo, "{{inputs.parameters.message}}"]
2. DAG: 複雑な依存関係に基づく実行 🕸️
DAG (Directed Acyclic Graph) は、タスク間の
「依存関係」
を明示的に定義します。
✅ どのような場合に使用しますか?
- タスクが複雑に絡み合っており、順序立ててリストアップするのが難しい場合。
- 特定のタスクが複数の先行タスクの結果に依存する場合。
- 効率的な並列処理が極めて重要な場合(依存関係のないタスクは即座に実行されます)。
📝 コード例と説明 (DAG)
YAML
apiVersion: argoproj.io/v1alpha1
kind: Workflow
metadata:
  generateName: dag-example-
spec:
  entrypoint: main
  templates:
  - name: main
    dag:
      tasks:
      - name: A
        template: echo
      - name: B
        depends: "A" # Aが成功した場合のみ実行
        template: echo
      - name: C
        depends: "A" # Aが成功した場合のみ実行 (Bと並列)
        template: echo
      - name: D
        depends: "B && C" # BとCの両方が成功した場合のみ実行
        template: echo

  - name: echo
    container:
      image: alpine:latest
      command: [echo, "Running task"]
3. 以前の結果(Output)を取得する方法の違い 🔄
この2つの方法は、変数を参照する構文(Variable Scope)が異なります。この部分を間違えるとワークフローが実行されないので注意してください!
① Stepsでの参照
steps.
- 例: {{steps.generate-id.outputs.parameters.id}}
② DAGでの参照
tasks.
- 例: {{tasks.generate-id.outputs.parameters.id}}
💡 核心的な違い: 参照する接頭辞がstepsかtasksかの違いです。構造に合った正しいキーワードを使用する必要があります。
4. Artifact: 大容量データ転送の要 📦
Parameterが短い文字列や数値を渡すのに対し、Artifactはファイル、ディレクトリ、大容量データを転送する際に使用します。(S3、GCS、Minioなどの外部ストレージが必要です。)
✅ Artifactの特徴
- Input/Output: あるステップでファイルを生成(outputs.artifacts)し、次のステップでそれを入力(inputs.artifacts)として受け取ります。
- 永続性: ポッドが削除されてもデータは外部ストレージに残るため、後で結果を確認できます。
📝 実践コード: Artifactの受け渡し
YAML
apiVersion: argoproj.io/v1alpha1
kind: Workflow
metadata:
  generateName: artifact-passing-
spec:
  entrypoint: main
  templates:
  - name: main
    dag:
      tasks:
      - name: generate-file
        template: producer
      - name: consume-file
        depends: "generate-file"
        template: consumer
        arguments:
          artifacts:
          # 前のタスクの出力を入力として接続
          - name: input-file
            from: "{{tasks.generate-file.outputs.artifacts.result-file}}"

  - name: producer # ファイルを作成するテンプレート
    container:
      image: alpine:latest
      command: [sh, -c]
      args: ["echo 'important data' > /tmp/out.txt"]
    outputs:
      artifacts:
      - name: result-file # この名前でアーティファクトを作成
        path: /tmp/out.txt # コンテナ内の実際のパス

  - name: consumer # ファイルを受け取るテンプレート
    inputs:
      artifacts:
      - name: input-file # 入力アーティファクトの定義
        path: /tmp/in.txt # コンテナ内のどこに配置するか
    container:
      image: alpine:latest
      command: [cat, /tmp/in.txt]
5. 要約と選択ガイド 📊
| 区分 | Steps | DAG |
| — | — | — |
| 哲学 | 順次的な流れ (Sequential) | 依存関係ネットワーク (Dependency) |
| 可読性 | 単純な流れに有利 | 複雑な関係把握に有利 |
| 変数参照 | {{steps.NAME.outputs…}} | {{tasks.NAME.outputs…}} |
| 並列処理 | リストのリスト ([ [A, B] ]) で定義 | dependsがなければ自動並列実行 |
どちらを選択すべきですか?
- 流れが単純な場合は、Stepsを選択して直感性を高めましょう。
- タスク間の前後関係が複雑で、非線形なパイプラインの場合は、DAGが正解です。
- データがファイル形式の場合は、迷わずArtifactを構成してください。
Argo Workflowsの強力さは、このような構造的な柔軟性から生まれます。あなたのビジネスロジックに最適な構造を設計してみてください! 🛠️
コメントを残す