LLMや分析システムに入力されるデータには、氏名、電話番号、メールアドレス、口座番号、IPアドレスなどの個人情報が混入しやすくなっています。「モデルに個人情報を出力しないように」と指示しても、すでに原文が外部モデルやログに転送された後では手遅れです。
Microsoft Presidioは、テキスト・画像・構造化データから個人識別情報(PII)を検出し、非識別化するオープンソースのツール群です。その核心は、Analyzerが個人情報の候補とその位置を特定し、Anonymizerがその位置をマスキング・削除・置換・暗号化するという責任の分離にあります。
この記事では、Presidioとは何か、正規表現フィルターと何が違うのか、AnalyzerとAnonymizerがどのように連携するのか、LLM・RAGパイプラインのどこに配置すべきか、そしてその限界について集中的に考察します。
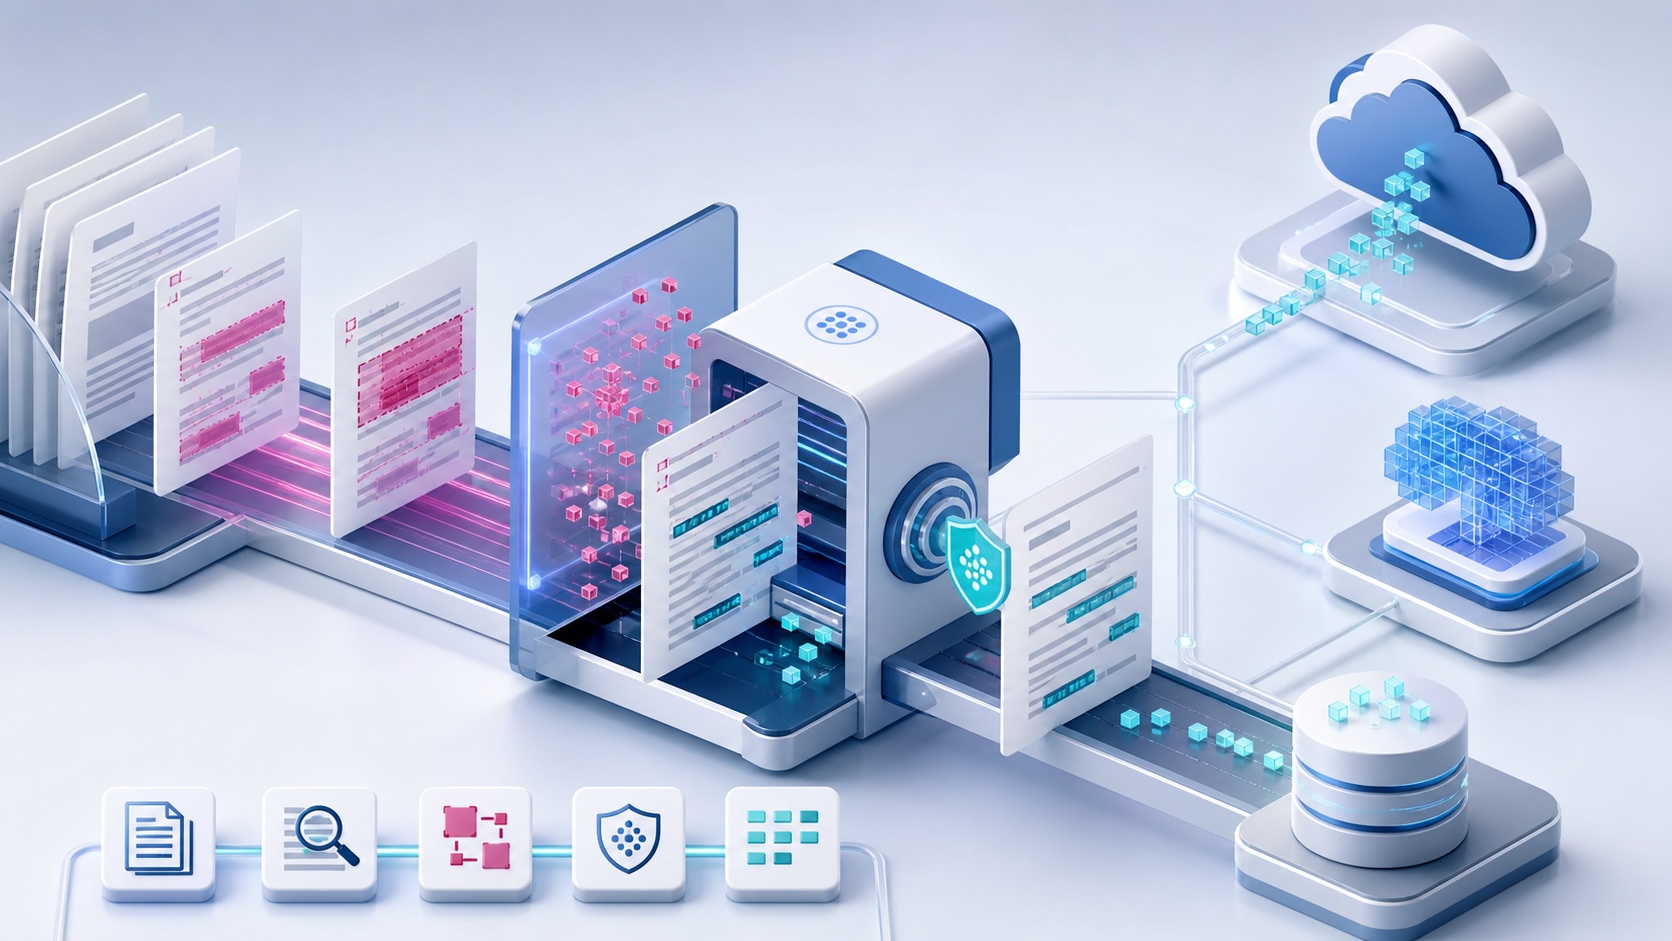
Presidioを一文で説明すると
Presidioはデータ全体をオーケストレーションするプラットフォームではなく、アプリケーションが呼び出すことができるPII検出・非識別化エンジンです。
원문
  → Presidio Analyzer: 엔터티 종류·위치·점수 탐지
  → 정책 결정: 무엇을 어떻게 처리할지 선택
  → Presidio Anonymizer: 마스킹·삭제·치환·해시·암호화
  → 비식별화된 데이터
Pythonライブラリとしてアプリケーション内に組み込むこともできますし、AnalyzerとAnonymizerをHTTPサービスやコンテナとして実行することも可能です。Microsoftで始まったプロジェクトですが、現在、公式ドキュメントとコンテナのデプロイパスはData Privacy Stackに移行しているため、古いMCRイメージや以前のドキュメントリンクをそのまま使用しない方が良いでしょう。
なぜ正規表現いくつかで終わらないのか
メールアドレスやカード番号のように形式が明確な値は、正規表現で検出できます。しかし、人名、地域、組織名のように文脈によって意味が変わる値は、パターンだけでは判断が難しいです。数字列も電話番号、注文番号、日付、または単なる数量である可能性があります。
Presidio Analyzerは複数のEntityRecognizerを同時に実行します。公式ドキュメントでは、正規表現、固有表現認識(NER)、チェックサム、文脈単語、およびユーザー定義ロジックを組み合わせることができると説明しています。各結果は通常、エンティティの種類、開始・終了位置、信頼スコアとして表現されます。
from presidio_analyzer import AnalyzerEngine

analyzer = AnalyzerEngine()
results = analyzer.analyze(
    text="연락처는 010-1234-5678입니다.",
    language="ko"
)
この例が日本語で即座に望ましい結果を出すと仮定してはいけません。言語ごとのNLPモデルとRecognizerのサポート状況を確認し、国内の電話番号・住民登録番号・事業者番号のような組織固有のエンティティは、ユーザー定義のRecognizerとテストデータで補強する必要があります。
主要構成要素
| 構成要素 | 役割 | 実務で決定すること |
| — | — | — |
| AnalyzerEngine | RecognizerとNLPエンジンを調整してPII候補を検出 | 言語、対象エンティティ、スコア閾値 |
| EntityRecognizer | 特定のPIIタイプを検出する検出器 | 正規表現・NER・外部モデル・ユーザー定義ロジック |
| RecognizerRegistry | 使用するRecognizerのリストを管理 | 国・業務別の有効化範囲 |
| NlpEngine | トークン化・NERなどの言語処理 | spaCy, Transformers, Stanzaとモデル |
| Context Aware Enhancer | 周辺単語で検出スコアを補強 | 文脈単語と誤検出の調整 |
| AnonymizerEngine | 検出位置に変換演算を適用 | エンティティごとの非識別化ポリシー |
| Operator | replace・redact・mask・hash・encryptなどを実行 | 可逆性、再識別リスク、キー・Salt管理 |
Presidioは「どのような情報が個人情報か」を組織の代わりに決定するものではありません。検出可能なエンティティと実際の規制・契約上の保護対象は異なる場合があるため、ポリシー層で別途マッピングを行う必要があります。
Analyzerは何を返すのか
Analyzerは原文を変更せず、候補区間を返します。例えば、文字列の10番目から23番目までがPHONE_NUMBERで、信頼スコアは0.85といった具合です。この分離のおかげで、アプリケーションは同じ検出結果に対して異なるポリシーを適用できます。
- ログには完全に削除する。
- 相談画面には最後の4桁だけを残す。
- 統計分析には、同一人物を連結できる仮名値に置換する。
- 権限のある業務処理には暗号化し、別途キーで復元する。
スコアは事実の有無を保証する確率ではありません。閾値を高くすると誤検出は減りますが、未検出が増える可能性があり、低くするとより多く検出する代わりに正常なデータが隠される可能性があります。
Anonymizerはどのようにデータを変更するのか
Presidio AnonymizerはAnalyzerの区間情報を受け取り、Operatorを適用します。公式ドキュメントには、replace、redact、mask、hash、encrypt、custom、keepなどの演算が説明されています。
| Operator | 結果 | 適したケース | 注意点 |
| — | — | — | — |
| replace | LLMプロンプト・ログ | 元の値の復元不可 | |
| redact | 該当文字列を削除 | 外部共有・最小収集 | 文脈が壊れる可能性あり |
| mask | 一部の文字を*などに変更 | 相談画面・確認UI | 残った文字で再識別可能 |
| hash | Saltを利用したハッシュ | 統計連結・重複分析 | Salt管理と辞書攻撃を考慮 |
| encrypt | キーで暗号化 | 承認された再識別が必要な業務 | キーを本文・プロンプトと分離する必要あり |
| custom | ユーザー関数で置換 | 仮名生成・業務ルール | 関数のセキュリティと決定性の検証が必要 |
最新のドキュメントでは、ハッシュ演算がデフォルトでエンティティごとにランダムなSaltを使用すると説明されています。複数のレコードで同じ個人情報を同じハッシュで連結するには、一貫したSaltを直接提供する必要がありますが、そのSaltが流出すると再識別リスクが高まります。Saltと暗号化キーは、プロンプトや一般的な設定ファイルではなく、KMS・Key Vault・Secrets Managerのような信頼できるストレージで管理する必要があります。
LLMの前にPresidioを置く理由
LLMが個人情報を出力しないように検査するだけでは、入力の露出を防ぐことはできません。最も基本的な配置は、モデル呼び出し前に原文をAnalyzerとAnonymizerに通すことです。
사용자 입력·업로드 문서
  → Presidio 탐지
  → 업무 정책에 따른 비식별화
  → LLM 호출
  → LLM 출력 재검사
  → 사용자
入力と出力の両方に検査が必要な理由があります。入力にはユーザーが提供した個人情報があり、出力にはモデルが対話履歴・検索ドキュメント・ツール結果から取得した個人情報が現れる可能性があります。ただし、同じ文章を複数の段階で無条件に重複マスキングすると、文脈と品質が損なわれるため、各境界の目的を明確にする必要があります。
RAGではどこに配置すべきか
RAGは、質問に関連するドキュメントをVector DBから検索し、原文チャンクをLLMプロンプトに挿入する方式です。Presidioは埋め込みベクトル自体を意味のある形で検査するツールではありません。検索後に返された原文チャンクを検査する必要があります。
推奨されるフローは以下の通りです。
Application: 인증·Tenant 확정
  → Retrieval API: Tenant Filter와 문서 권한 적용
  → Vector DB 검색
  → 반환된 원문 청크
  → Presidio: PII 탐지·비식별화
  → LLM 프롬프트 조립
Presidioはテナント権限を判断しません。アクセスしてはいけないドキュメントを先に検索しておいて、個人情報だけをマスキングするのは正しい認可ではありません。ドキュメントアクセス制御とセキュリティトリミングをまず適用し、許可された原文の個人情報を追加で検査する必要があります。
NeMo Guardrailsと併用する場合、Retrieval RailのCustom ActionからPresidioを呼び出すか、アプリケーションが所有する検索API内で呼び出すことができます。NeMoがLLM全体のフローを調整し、Presidioは要求されたテキストのPIIを処理します。
ライブラリとHTTPサービス、どちらを選択すべきか
Pythonアプリケーションであれば、presidio-analyzerとpresidio-anonymizerを同じプロセスにインストールする方法が最も単純です。ネットワーク転送がなく、きめ細やかなユーザー定義が容易ですが、NLPモデルがアプリケーションのメモリと起動時間を占有します。
複数の言語のアプリケーションや複数のチームが共通のポリシーを使用する場合、AnalyzerとAnonymizerをHTTPサービスとして分離することができます。公式のインストールドキュメントは現在、GHCRのdata-privacy-stackイメージを案内しており、運用環境では`latest`ではなく明示的なリリースダグの固定を推奨しています。
podman run -d --name presidio-analyzer
  -p 5002:3000
  ghcr.io/data-privacy-stack/presidio-analyzer:latest

podman run -d --name presidio-anonymizer
  -p 5001:3000
  ghcr.io/data-privacy-stack/presidio-anonymizer:latest
チュートリアルでは`latest`が便利ですが、運用デプロイでは検証済みのバージョンタグとイメージDigestを固定する必要があります。サービス分離はポリシーの一元化に有利ですが、原文の個人情報がネットワークをもう一度移動するため、TLS、サービス認証、リクエストログのマスキング、タイムアウトが必要です。
Presidioを必ず使うべきケース
- LLMプロンプトや応答でPIIを一貫して検出・マスキングする必要がある。
- ログ、データ分析、外部共有に同じ非識別化ポリシーを再利用する必要がある。
- 正規表現以外にNER、文脈、チェックサム、ユーザー定義Recognizerが必要である。
- PythonライブラリとHTTPサービスの中からデプロイ方式を選択する必要がある。
- エンティティごとに削除・部分マスキング・ハッシュ・暗号化ポリシーを異なる方法で適用する必要がある。
逆に、入力フィールドが厳密に構造化されており、メールアドレスの1フィールドだけを削除すればよい小さなサービスであれば、単純な検証コードの方が適切かもしれません。Presidioの価値は、多様な非定型テキストと複数のポリシーを繰り返し処理する際に大きくなります。
必ず知っておくべき限界
Presidioは、すべての個人情報を自動的に見つける完全なDLP製品ではありません。言語やドメインによって誤検出・未検出があり、新しい識別子や結合識別子はデフォルトのRecognizerが知らない可能性があります。名前を消しても、職場、希少疾患、日付、地域を組み合わせると個人を再識別できる場合があります。
また、検出結果をログにそのまま残すと、保護しようとした原文が観測システムに複製される可能性があります。デバッグ用の決定トレース、APIリクエスト・応答、エラーメッセージ、サンプルデータはすべて個人情報処理の対象として扱う必要があります。
パフォーマンスも検討する必要があります。正規表現のみを使用するよりもNLPモデルを一緒に実行すると精度改善の可能性がありますが、CPU・GPU、メモリ、遅延時間が増加します。実際のデータの言語・長さ・エンティティ分布を反映したテストセットで閾値とRecognizerを調整する必要があります。
結論
Microsoft Presidioは、LLMセキュリティ全体を担うガードレールプラットフォームではありません。原文から個人情報の候補を検出するAnalyzerと、ポリシーに従って値を変更するAnonymizerを提供する専門エンジンです。
Presidioを使用すべき理由は、個人情報保護を「モデルにお願いする文章」ではなく、モデル呼び出しの前後で実行されるデータ処理ステップにするためです。しかし、テナント権限、法的処理根拠、暗号化キー、最終的なアクセス承認は、アプリケーションと信頼できるセキュリティ層が担当する必要があります。
正確な配置は簡単です。まず認証とドキュメント権限を強制し、許可された原文をPresidioで検出・非識別化した後、LLMや分析システムに転送します。この責任分離を守ることで、PresidioはLLM・RAG・ログパイプラインにおける個人情報露出の範囲を実質的に減らす強力な構成要素となります。
コメントを残す