開発者およびDevOpsエンジニアの皆さん、こんにちは!MSA(マイクロサービスアーキテクチャ)環境で、数多くのアプリケーションから吐き出されるログ、メトリック、トレースデータをどのように管理していますか?🤔 多くの皆さんが、データの量に圧倒されたり、異なる形式のデータを統合するのに苦労していることでしょう。
このような問題を解決するために登場した標準が、まさにOpenTelemetry (OTel) です。そして、OTelエコシステムの中心でデータフローを制御する強力なコンポーネントが、OpenTelemetry Collector です。
今日は、このCollectorが何であるか、特にデータを集計(Aggregation)し処理する方法について深く掘り下げていきます。
❓ OpenTelemetry Collectorとは何ですか?
最も簡単に例えるなら、Collectorはテレメトリーデータ専門の郵便局 📫 のようなものです。複数の場所(アプリケーション)から送られた手紙(データ)を受信し、分類し(処理)、最終目的地(モニタリングバックエンド)へ配達する役割を果たします。
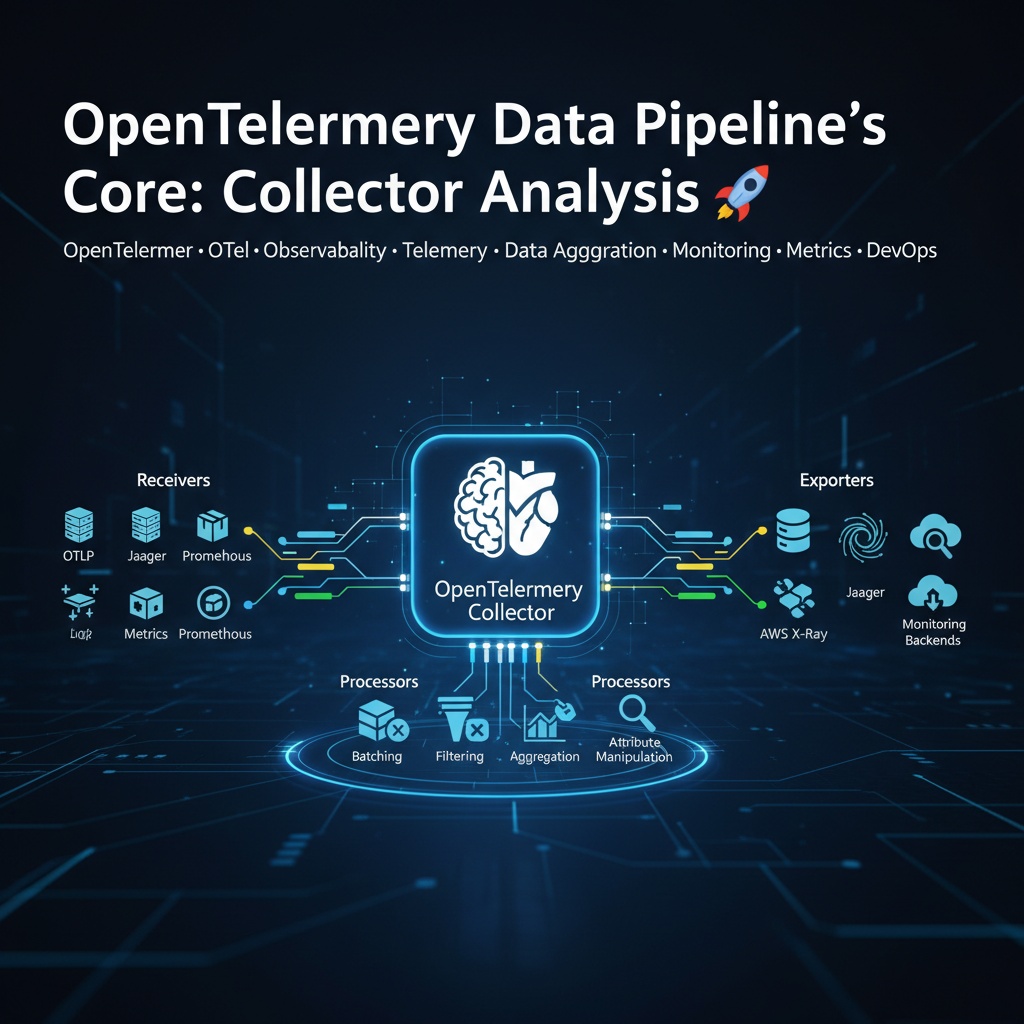
Collectorはベンダーに依存しない独立したサービスであり、以下の3つの主要なパイプライン段階を経ます。
- 受信 (Receivers) 📥: さまざまな形式(OTLP、Jaeger、Prometheusなど)のテレメトリーデータを受信する部分です。どのプロトコルでデータを受け取るかを定義します。
- 処理 (Processors) ⚙️: Collectorの最も強力な機能がこの段階にあります。受信したデータをエクスポートする前に加工するプロセスです。
- エクスポート (Exporters) 📤: 処理されたデータを最終的に保存・分析するバックエンド(Jaeger、Prometheus、AWS X-Rayなど)に送信します。
✨ データ集計と処理の魔術師、Processors
「データ集計方法を定義するコンポーネントは何ですか?」という質問の核心は、まさにこの処理(Processing)段階にあります。CollectorはProcessorsを通じて、データをバックエンドに送信する前にさまざまな操作を実行できます。
主な処理操作は以下の通りです。
- バッチ処理 (Batching): データを一つずつ送るのではなく、一定量または一定時間集めて一度に送信します。これにより、ネットワークオーバーヘッドを大幅に削減できます。効率的な宅配便の配送のために、荷物を集めて大きなトラックで一度に送るのと似ています。🚚
- フィルタリング (Filtering): 不要なデータを削除します。例えば、システムの状態を確認する/healthチェックリクエストに関するトレースは分析に大きな意味がないため、除外できます。📜 -> 🗑️
- 集計 (Aggregation): 複数のデータポイントを要約して新しいメトリックを生成します。例えば、1秒ごとに入ってくる数百の要求成功/失敗メトリックを、「1分あたりの要求成功率」のような意味のある指標に集計できます。
- 属性の追加/変更 (Attribute Manipulation): データに追加のコンテキスト情報を付与します。例えば、すべてのスパンにenvironment: productionやk8s.cluster.name: my-clusterのような属性を追加することで、後でデータをフィルタリングして分析しやすくなります。
📝 実際のCollector設定ファイル(config.yaml)の例
これらのプロセスがどのように設定されるかをコードで見てみましょう。以下は、OTLPでデータを受信し、バッチ処理後、コンソールログとして出力する簡単なCollector設定です。
# config.yaml

# 1. データの受信方法を定義します。
receivers:
  otlp:
    protocols:
      grpc:
      http:

# 2. データをどのように加工するかを定義します。(重要!)
processors:
  batch:
    # 200msごと、または100個のスパンが蓄積されたらバッチで送信します。
    timeout: 200ms
    send_batch_size: 100
  memory_limiter:
    # Collectorが使用する最大メモリを制限し、安定性を高めます。
    check_interval: 1s
    limit_mib: 4000

# 3. 処理されたデータをどこに送信するかを定義します。
exporters:
  logging:
    # デバッグしやすいように、コンソールにログ形式で出力します。
    loglevel: debug

# 4. 上記コンポーネントをパイプラインに接続します。
service:
  pipelines:
    traces: # トレースデータパイプライン
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [logging]
    metrics: # メトリックデータパイプライン
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [logging]
上記の設定でservice.pipelines.tracesの部分を見ると、データフローが明確にわかります。
otlpレシーバーに入ってきたデータが -> memory_limiterとbatchプロセッサーを経て -> loggingエクスポーターコンポーネントに渡されます。このようにデータ集計(バッチ処理)のような処理方法を定義する主体は、まさにCollectorの設定ファイルです。
🤔 他のコンポーネントが正解ではないのはなぜですか?
OpenTelemetryエコシステムの他の要素と比較すると、Collectorの役割がさらに明確になります。
1. SDK (Software Development Kit)
- 役割: アプリケーションコード内部にインストールされ、テレメトリーデータを
生成(instrumentation)するライブラリです。👩💻
- なぜ違うのか?: SDKはデータが発生するまさにその場所にあります。簡単なサンプリングや基本的な属性の追加は可能ですが、複数のサービスから来るデータを中央で集計したり、複雑なルーティングルールを適用したりするには適していません。SDKの役割はデータ生成に焦点が当てられており、Collectorは生成されたデータの中央処理と管理に焦点が当てられています。
2. Exporters (エクスポートコンポーネント)
- 役割: データを特定のバックエンドの形式に合わせて送信する役割を果たします。📤
- なぜ違うのか?: Exporterはパイプラインの最も最後の段階を担当します。データの最終目的地に送る「配達員」の役割に過ぎず、データを途中で加工したり集計したりするロジックは含まれていません。データ処理はすでにProcessor段階で完了しています。
🌟 結論: 全体的な文脈におけるCollectorの重要性
OpenTelemetryを使用した可観測性(Observability)システムを構築する際、Collectorは単にデータを転送するプロキシではありません。
Collectorはテレメトリーデータパイプラインの脳 🧠 と心臓 ❤️ です。
アプリケーションはSDKを通じてデータ生成にのみ集中し、データ処理と転送のすべての複雑さをCollectorに委任できます。これにより、以下の利点が得られます。
- 関心事の分離: アプリケーションコードはビジネスロジックにのみ集中できます。
- 柔軟性と拡張性: 新しいモニタリングバックエンドを追加したり、データ処理ルールを変更したりする際に、アプリケーションを再デプロイする必要なく、Collectorの設定を変更するだけで済みます。
- パフォーマンス最適化: バッチ処理などを通じてネットワークトラフィックを削減し、バックエンドの負荷を軽減します。
- データ標準化: 複数のソースから入ってきたデータを一貫した形式に整形してバックエンドに送信できます。
したがって、テレメトリーデータの集計、フィルタリング、補強など、データ処理方法を定義したい場合、その答えはまさにOpenTelemetry Collectorにあります。
コメントを残す