GPT‑6.1 Sol 是 OpenAI 的 AI 模型名称。如果您正在考虑是否从现有的 GPT‑6 Sol 切换,那么从重复的编码和文档工作开始,在相同条件下进行比较是值得的。然而,仅仅因为名称中的数字增加了,就判断所有任务都变得更准确或更快,这是困难的。
本文根据 2026 年 10 月 4 日确认的官方文档,整理了选择标准。这不是基于实际模型调用的性能实验或使用体验。我将从官方说明、公开价格以及未来需要亲自验证的项目三个方面进行阐述。
首先,区分模型的角色
OpenAI 将 GPT‑6.1 Sol 描述为一个在复杂任务中以更低成本提供接近 Astra 性能的模型。建议将其用于重复的、长时间的编码、应用程序和文档工作,并将 Astra 保留给最困难的任务。Luna 是针对范围明确的重复性任务的选项。这只是产品用途的说明,不保证在特定项目中会产生相同的结果。 官方模型选择指南
选择模型时,重要的不是任务的名称,而是失败时的负担。润色博客文章很容易修改,但如果混入了没有根据的技术说明,就需要重新调查。同样,编写短函数和分析涉及多个服务的故障,所需的判断是不同的。与其用一个模型统一所有任务,不如将验证成本也考虑在内进行划分,这样更容易做出判断。
| 任务 | 首先比较的选项 | 人工确认部分 |
| — | — | — |
| 带测试的小代码修改 | 现有 6 Sol 和 6.1 Sol | 测试结果,修改范围 |
| 整合多份资料的文档草稿 | 6.1 Sol | 遗漏,数值,来源链接 |
| 限制多的复杂设计 | 6.1 Sol 和 Astra | 前提,替代方案,失败条件 |
| 格式固定的提取·分类 | Luna 等小型选项 | 遗漏率,格式遵守 |
上表是本文的评估计划。它不是衡量模型优劣的结果表。
API 单价和应用使用量需要单独计算
API 是程序调用模型的接口。令牌是计算输入·输出的单位,与字数并非一一对应。以下是每个请求输入在 272K 令牌以下时的 Standard 文本单价。
WRIMO-MD-TABLE-1]依据:[官方 API 价格表、6 Sol API 文档、6.1 Sol API 文档。长输入、缓存写入、区域处理、Fast 模式、工具使用等有单独条件,因此不能仅凭上表计算最终账单。
差异在于缓存输入单价。缓存是一种在再次处理重复输入时重用的方式,但实际命中与否取决于请求配置和服务条件。以下是多个 Standard 请求的虚拟使用量,每个请求的输入都在 272K 令牌以下。通用输入是指非缓存写入的普通输入,不包括缓存写入、工具、区域处理等额外费用。如果单个请求的输入超过 272K,则该请求的整体输入·缓存单价将翻倍,输出单价将变为 1.5 倍。
일반 입력 20만 토큰 + 캐시 적중 입력 80만 토큰 + 출력 10만 토큰
6 Sol:   0.2 × 2 + 0.8 × 0.20 + 0.1 × 10 = $1.56
6.1 Sol: 0.2 × 2 + 0.8 × 0.10 + 0.1 × 10 = $1.48
차이: $0.08
即使缓存读取单价减半,此示例的总成本也仅减少约 5.1%。如果将整个输入都按缓存费用计算,或者认为总成本减半,结果将大相径庭。上述计算未包含缓存写入和工具等额外费用。
ChatGPT Work·Codex 的积分计算也与 API 美元单价无关。GPT-6 Sol 和 GPT-6.1 Sol 的通用输入·输出 Standard 积分单价是 Astra 的五分之一,但由于不同模型的实际令牌使用量可能不同,因此一个任务不一定就是五分之一的成本。订阅中包含的使用量也不能用相同的数字换算来断定。 官方价格指南
确认“更快”的比较对象
6.1 Sol 可根据账户和客户端使用 Standard·Fast 模式,Ultrafast 支持预计在未来推出。模型选择界面是否可见取决于套餐、工作区设置和部署情况。 模型支持指南
Fast 的使用量倍数与速度倍数不同。此外,Astra Ultrafast 的最大 8 倍数值是指相对于 Astra Standard 的令牌生成速度。这不能解释为 6.1 Sol 比现有 Sol 快 8 倍,或者包括调查和工具执行在内的任务会快 8 倍完成。 官方速度指南
在实际工作中,首次给出答案的时间和完成验证的时间可能不同。如果答案很快,但修正错误来源花费了很长时间,那么实际生产力就会降低。在模型比较中,测量直到最终可用结果产生的时间会更有用。
如果切换到 API,也要确认调用方式
切换到 API 时,除了模型名称外,还要确认调用方式。GPT-6.1 Sol 不支持 reasoning.effort 的 none·minimal 模式,并且工具调用使用 Responses API。Chat Completions 在没有工具调用的情况下受支持。如果直接迁移现有 GPT-6 Sol 的 none 设置或 Chat Completions 函数调用,将不兼容。请区分在应用程序中选择模型和替换程序 API 设置的情况进行确认。 6 Sol API 文档、6.1 Sol API 文档
切换前制作一个小型比较表
准备三个可以使用公开虚拟资料的日常任务。例如,修改一个简单的输入验证函数,比较两份官方文档的条件,撰写一篇短博客草稿。即使不将客户文档或实际账户·日志用于评估提示,也可以确认基本的任务适用性。
为每个任务提供相同的资料和要求,并记录模型、推理设置和速度模式。如果在比较过程中更改要求,将难以判断差异是来自模型。通过改变执行顺序重复操作,并查看重复结果,而不是偶然出现的一次好答案。
| 评估项目 | 记录值 |
| — | — |
| 完成质量 | 满足必要条件的数量,重大错误数量 |
| 依据 | 来源是否存在,主张与来源是否一致 |
| 修改负担 | 人工修改次数·审查时间 |
| 所需时间 | 从开始到验证完成 |
| 成本 | 实际使用量和适用费用条件 |
编码方面,同时检查测试是否通过以及是否存在不必要的更改。文档方面,确认是否存在遗漏条件或错误数值。博客方面,不仅评估文章是否易读,还要评估是否编造了未经证实的故事或产品性能。
如果两个模型都满足标准,可以选择成本和修改负担较小的一方。如果复杂任务的差异很大,则可以确定 Astra 负责的范围,并将简单任务转移到更小的模型。这种方法还可以减少每次发布新模型时一次性切换所有任务的负担。
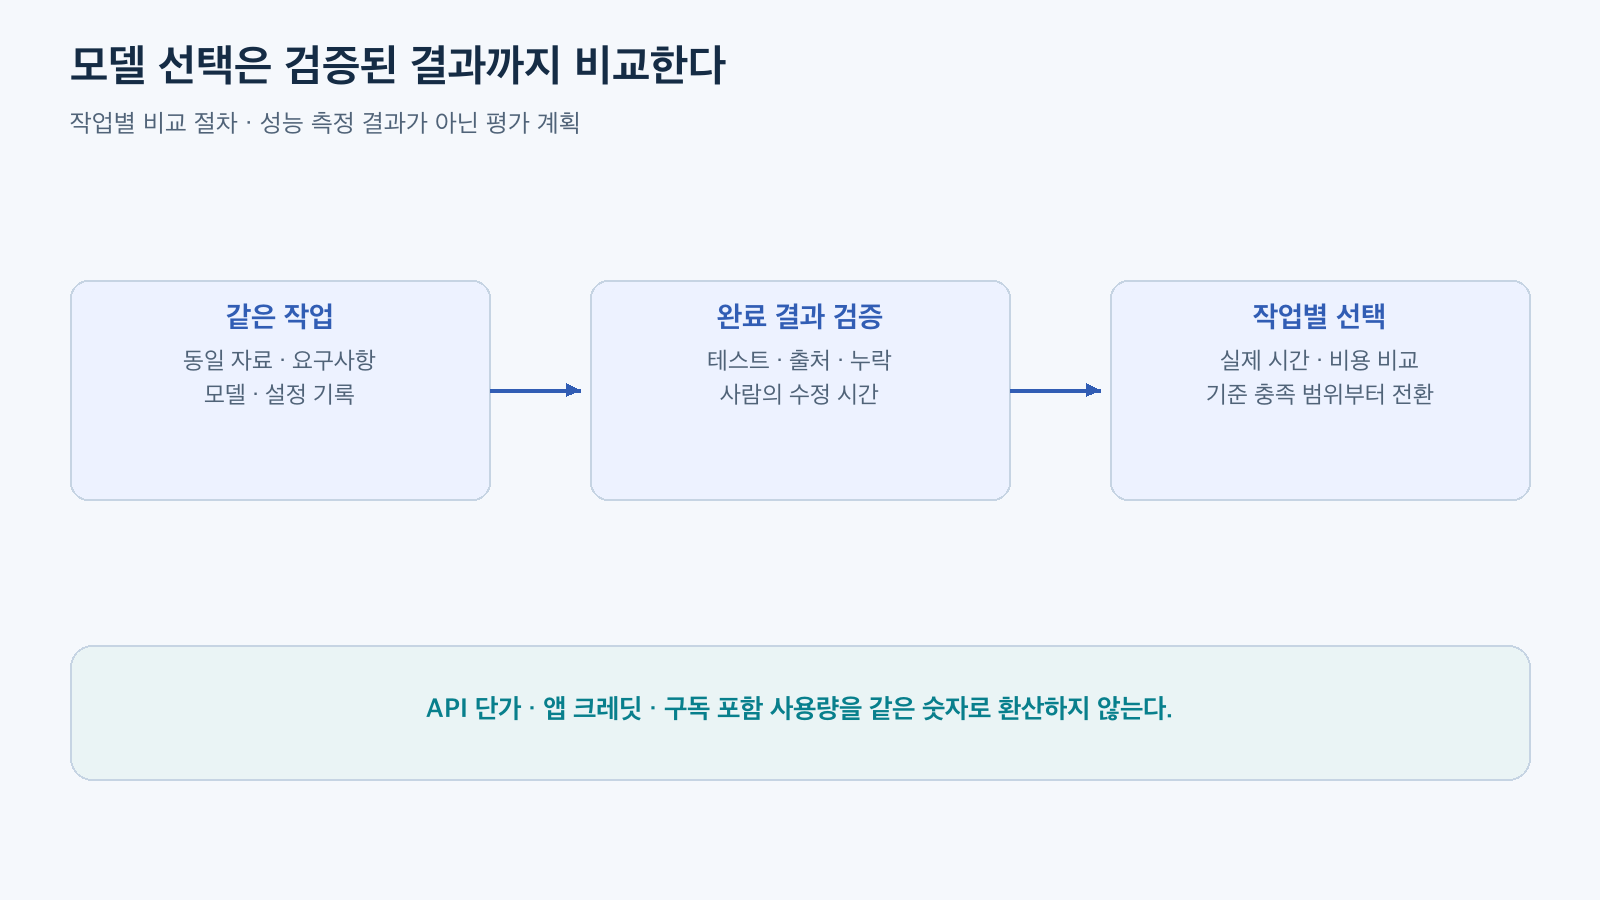
图:按任务划分的比较流程 · 评估计划,而非性能测量结果 · 根据官方文档重新组织
不要仅凭发布间隔猜测开发原因
即使在短时间内发布了名称相似的模型,发布间隔也不代表开发周期。没有根据将公开资料未解释的紧急修复、竞争应对、内部故障等原因作为事实。选择所需的信息是当前支持条件和从自身任务中获得的结果。
6.1 Sol 是重复性编码和文档任务的良好比较候选。如果现有的 6 Sol 已经满足您的标准,那么可以先进行小规模评估,然后从结果和验证成本得到改善的任务开始迁移。比模型名称更重要的是它能否稳定地满足相同的要求。
发表回复