大家好!👋 您是否已经通过引入Prometheus开始了基本的节点或数据库监控?如果是这样,那么下一步很可能就是“直接在我们的应用程序中嵌入指标”,即Instrumentation。
然而,当您真正开始时,可能会陷入“指标名称该如何命名?”、“应该使用哪种类型?”、“标签可以随意添加吗?”之类的困惑。
今天,我将帮助您解决这些困扰,并以易于理解的方式总结应用程序Instrumentation的核心最佳实践,让您也能听到别人说:“你真的很懂Prometheus!”
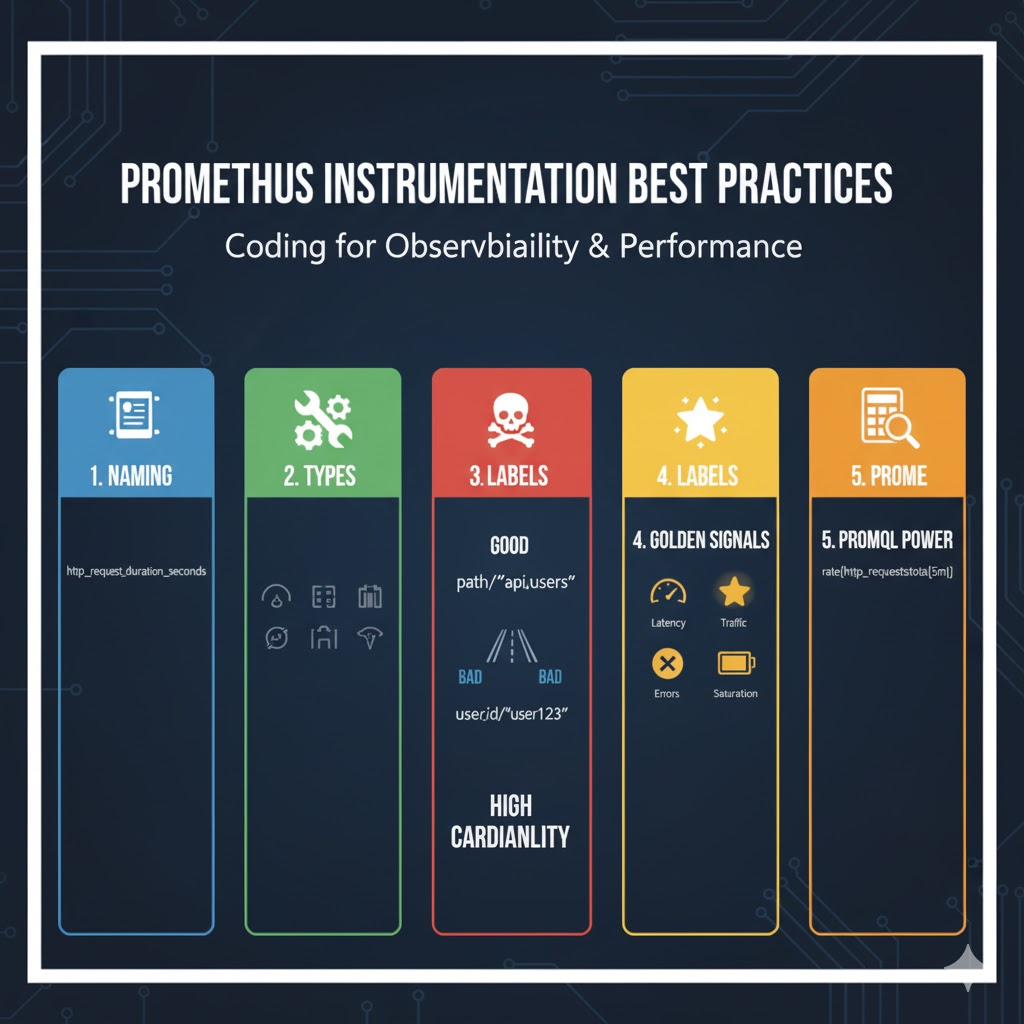
1. 保持命名一致性:为未来做出的最佳投资
这是最基本但也是最重要的规则。如果指标名称杂乱无章,将来使用PromQL查询时会造成很大的混乱。建议遵循以下标准命名规则:
[库/应用程序前缀]_[测量对象]_[单位]
- 前缀 (Prefix): 明确指出该指标属于哪个应用程序或库。(例如:http_, prometheus_, api_)
- 测量对象 (Metric Name): 明确表示正在测量什么。(例如:requests_total, request_duration_seconds)
- 单位 (Unit): 明确指标的单位。特别是表示时间时,强烈建议使用基本单位,如seconds;数据大小使用bytes。(而不是ms, KB)
✅ 好的例子:
- api_http_requests_total: API服务器的总HTTP请求数 (计数器使用_total后缀)
- process_resident_memory_bytes: 进程的物理内存使用量 (字节单位)
- http_request_duration_seconds: HTTP请求处理时间 (秒单位)
❌ 坏的例子:
- requests: 不清楚是什么请求。
- memory: 缺少单位,不清楚是MB还是KB。
- http_latency_ms: 使用毫秒(ms)而不是基本单位。
2. 选择合适的指标类型:使用正确的工具 🛠️
Prometheus有四种指标类型。选择适合情况的类型可以确保数据的含义准确无误。
- 计数器 (Counter) 📈: 用于只增不减的值。(例如:累计请求数、累计错误数)
- 与rate()、increase()函数一起使用,计算“每分钟请求数”等。
- 仪表盘 (Gauge) 🌡️: 用于值可升可降的当前状态值。(例如:当前连接用户数、CPU利用率、队列中的任务数)
- 直方图 (Histogram) 📊: 用于了解观测值的分布。主要用于测量响应时间(Latency)。
- 通过histogram_quantile()函数优化,用于计算百分位数,例如“95%的请求在多少秒内处理完成?”。对于大多数响应时间测量,直方图是正确的选择。
- 摘要 (Summary) 📝: 类似于直方图,但直接在客户端计算百分位数。由于聚合困难,除了特殊情况外,建议使用直方图。
3. ⚠️ 最重要!管理标签和基数
标签(Label)是Prometheus的强大功能,但如果使用不当,它也可能是一把双刃剑,甚至可能导致服务器崩溃。核心在于管理基数(Cardinality)。
基数是指标签值的唯一组合有多少种的度量。
- 低基数 (Low Cardinality) 👍: 标签值的种类有限。(例如:method=”GET”, “POST”, status=”200″, “404”, “500”)
- 高基数 (High Cardinality) 💣: 将用户ID、电子邮件、会话ID、请求ID等可能无限增长的值用作标签的情况。
高基数是导致Prometheus服务器内存使用量爆炸式增长和性能严重下降的罪魁祸首! 绝不能将唯一标识符用作标签值。
✅ 好的标签
示例: http_requests_total{method=”POST”, path=”/api/v1/login”, status=”200″} (method, path, status的种类是有限的。)
❌ 绝对要避免的标签
示例: http_requests_total{user_id=”user12345″, session_id=”a1b2c3d4e5f6g7″} (每当用户增加时,就会无限生成新的时间序列(time series)。)
4. 测量什么?四大黄金信号 (Four Golden Signals) ✨
“那么,到底应该测量什么呢?”对此问题的最佳答案是Google SRE提出的“四大黄金信号”。围绕这四个直接影响用户体验的指标进行测量,您就不会失败。
- 延迟 (Latency) 🐢: 处理请求所需的时间。区分成功请求和失败请求的时间进行测量非常重要。
- 流量 (Traffic) 🚦: 服务接收到的请求量。(例如:每秒HTTP请求数)
- 错误 (Errors) 💥: 失败请求的比例。应明确跟踪系统中发生的所有类型的错误。
- 饱和度 (Saturation) 🈵: 指示服务“满载”程度的指标。测量系统中最受限制的资源(如CPU、内存、磁盘空间)的负载。
5. 将计算交给PromQL:应用程序保持简单 🧠
不要在应用程序代码中执行复杂的计算。没有必要计算“每秒请求数”之类的比率并将其作为指标暴露。
- 应用程序的角色: 只需专注于暴露原始数据(raw data)。每次请求到来时,只需将计数器增加1即可。(http_requests_total.inc())
- PromQL的角色: 使用PromQL这个强大的查询语言,执行所有所需的计算、聚合和分析,例如rate(http_requests_total[5m])。
通过这种角色分离,应用程序代码变得简单,并且收集到的数据可以更灵活地利用。
总结
一个优秀的监控系统始于良好构建的可观测性(Observability),而第一步就是以正确的方式嵌入指标。请务必记住今天介绍的5个最佳实践,以构建一个稳定且易于分析的监控环境!
标签: Prometheus, 监控, Instrumentation, 最佳实践, SRE, DevOps, Observability, 基数
发表回复