大家好!在MSA(微服务架构)环境中,为了了解系统状态并解决问题,’分布式追踪(Distributed Tracing)’已不再是可选项,而是必不可少的技术。然而,追踪和存储所有请求会产生海量数据,给成本和性能带来负担。😥
为了解决这个问题,我们采用了 ‘采样(Sampling)’ 技术。这意味着只选择性地存储部分追踪数据。采样主要有两种方式:即 头部采样(Head-based) 和 尾部采样(Tail-based)。
今天,我们将轻松详细地了解这两种方式有何不同,以及它们各自的优缺点!
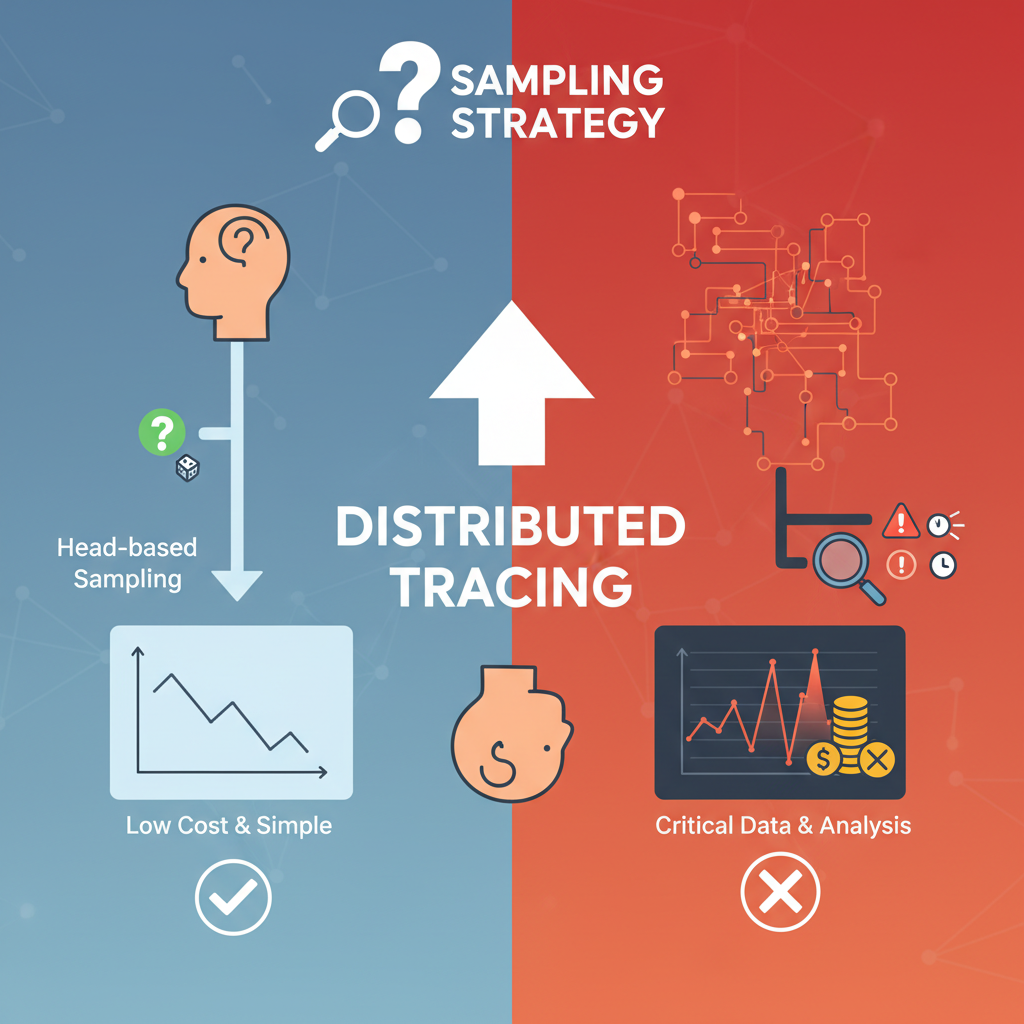
🚀 预先决定!头部采样 (Head-based Sampling)
头部采样,顾名思义,是一种在追踪的 ‘头部(Head)’ 决定一切的方式。
更详细地解释,它是在 分布式追踪的第一个请求(span)开始的那一刻,决定“是否记录此追踪?”。这个决定在追踪完全结束之前做出,一旦决定,就会相同地传播给属于该追踪的所有子请求(span)。
🤔 它是如何运作的?
- 第一个请求进入系统,追踪开始。
- 此时,根据预设的采样率(例如:只保存10%的追踪),概率性地决定是否采样。🎲
- “采样决定”信息被封装在上下文(Context)中,并持续传递给下一个服务。
- 如果最初决定“不保存”,则与此追踪相关的所有请求数据都不会被收集。
👍 优点:
- 轻量且快速: 在追踪开始时即做出决定,因此系统开销小,实现简单。
- 资源高效: 无需在内存中保留整个追踪,资源使用率非常低。
- 成本可预测: 由于按固定比例采样,数据存储成本易于预测。
👎 缺点:
- 可能错过重要数据: 由于采样决定是随机做出的,因此很有可能错过包含偶尔发生的关键错误或严重延迟现象的追踪。(这就像没有给彩票中奖者入场券一样!)
🧐 事后决定!尾部采样 (Tail-based Sampling)
尾部采样与头部采样正好相反。它是在追踪的 ‘尾部(Tail)’,即 所有操作完成后才决定是否采样 的方式。
在所有跨度(span)被收集并形成一个完整的追踪之后,会彻底检查该追踪的全部内容,以判断其是否值得保存。
🤔 它是如何运作的?
- 首先临时收集属于单个追踪的所有请求(span)数据,以重建整个追踪。🧩
- 根据完整的追踪信息,按照预定义的规则决定是否采样。
- 规则示例:
- 追踪中是否包含“错误(Error)”?🚨
- 总处理时间是否超过500毫秒?🐢
- 是否包含“支付”等特定重要业务逻辑?💰
- 最终只保存符合规则的“有价值”追踪。
👍 优点:
- 获得高可见性: 可以100%收集分析所需的关键追踪,例如发生错误或异常缓慢的请求。
- 准确分析: 由于不会错过系统中的问题情况,因此对于调试和性能分析非常有用。
👎 缺点:
- 高资源使用率: 所有追踪数据必须首先存储在内存或缓冲区中,因此需要更多的计算资源和存储空间。
- 实现复杂性: 需要收集、重构和分析所有跨度的逻辑,因此实现更为复杂。
📊 一目了然的比较!
| 分类 | 头部采样 (Head-based) | 尾部采样 (Tail-based) |
| 决定时机 | 追踪 开始前 (第一个跨度生成时) | 追踪 完成后 (所有跨度收集后) |
| 判断标准 | 概率(例如:10%比例) | 追踪的全部内容(错误、延迟时间等) |
| 优点 | ✅ 低成本、简单、资源高效 | ✅ 获取重要数据、准确分析 |
| 缺点 | ❌ 可能丢失重要数据 | ❌ 高成本、复杂、高资源使用率 |
| 推荐对象 | 了解系统整体流量走向 | 故障分析、SLO/SLA监控等 |
## ✨ 结论
总而言之,最核心的区别在于, 头部采样 是在追踪 完成之前 做出决定,而 尾部采样 是在追踪 完成之后 做出决定。
很难说哪种方式绝对更好。根据系统规模、成本以及您希望观察的内容,选择合适的采样策略至关重要。
- 如果 “只想了解我们系统平时如何运行的大致统计数据”,那么 头部采样 可能是一个好的起点。
- 如果 “希望捕获所有绝不能错过的错误或性能下降”,那么应积极考虑 尾部采样。
希望您能选择最适合您系统的采样策略,从而构建更稳定、更可靠的服务!😊
发表回复