进入LLM和分析系统的数据很容易混入姓名、电话号码、电子邮件、银行账号和IP地址等个人信息。即使你指示模型“不要输出个人信息”,如果原文已经发送到外部模型或日志,那就为时已晚了。
Microsoft Presidio是一个开源工具集,用于在文本、图像和结构化数据中查找并去识别个人身份信息(PII)。其核心是职责分离:Analyzer负责查找PII候选及其位置,而Anonymizer负责对这些位置进行遮蔽、删除、替换或加密。
本文将重点探讨Presidio是什么,它与正则表达式过滤器有何不同,Analyzer和Anonymizer如何协作,应将其放置在LLM和RAG管道的何处,以及其局限性。
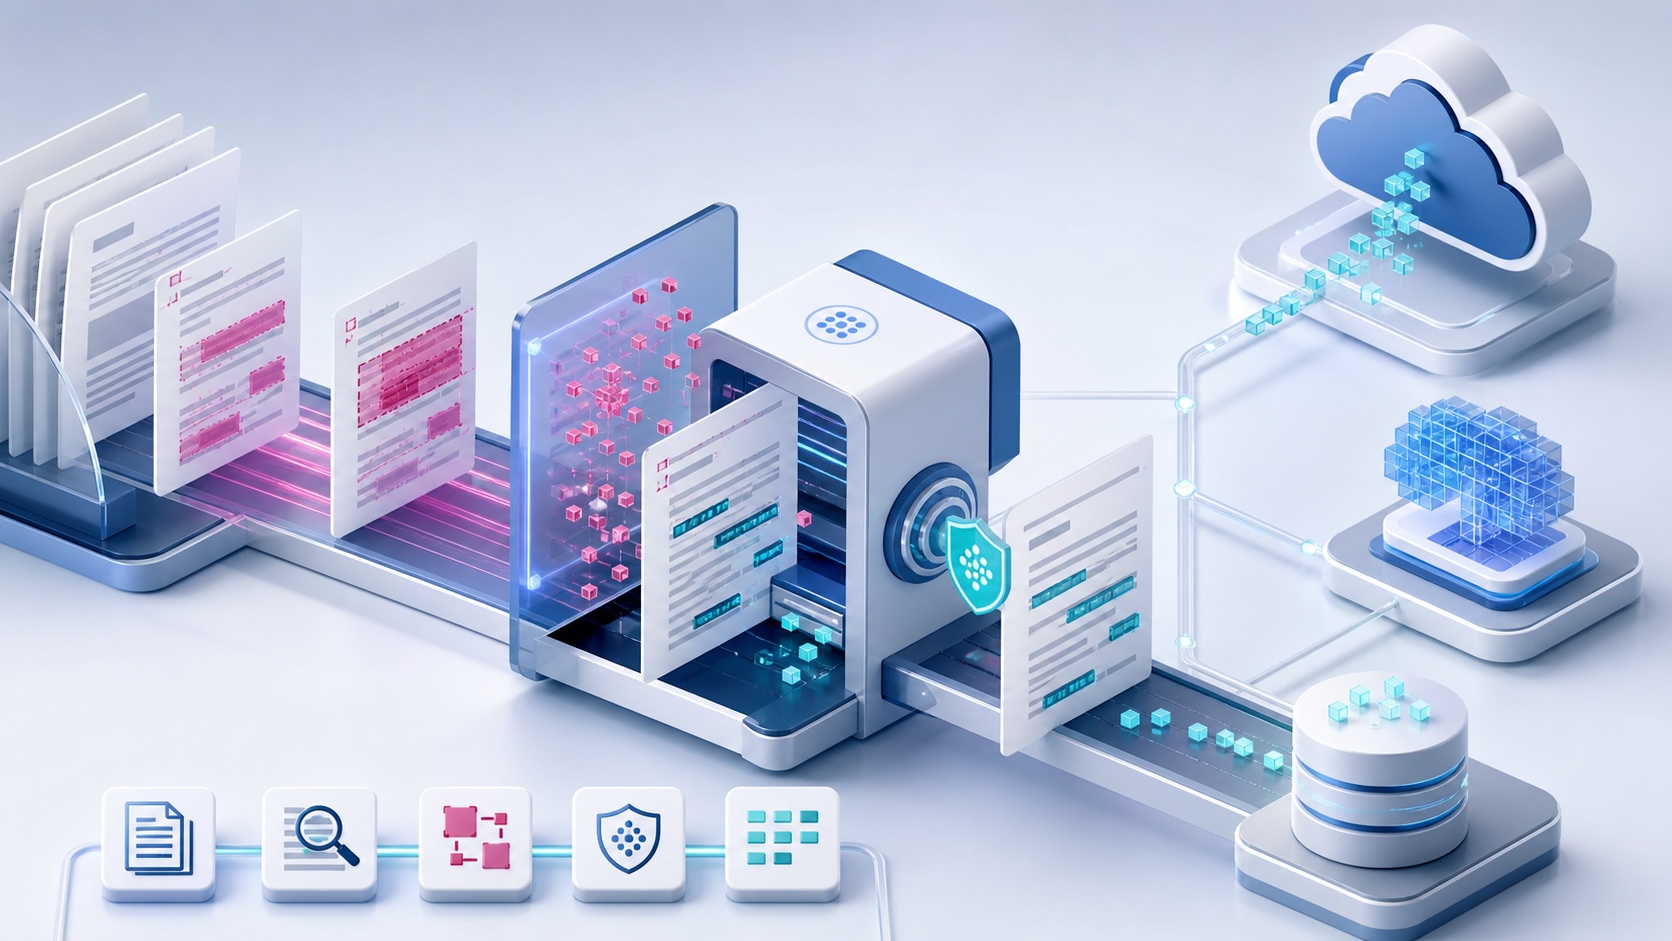
一句话概括Presidio
Presidio不是一个协调整个数据的平台,而是一个应用程序可以调用的PII检测和去识别引擎。
원문
  → Presidio Analyzer: 엔터티 종류·위치·점수 탐지
  → 정책 결정: 무엇을 어떻게 처리할지 선택
  → Presidio Anonymizer: 마스킹·삭제·치환·해시·암호화
  → 비식별화된 데이터
它可以作为Python库嵌入到应用程序中,也可以将Analyzer和Anonymizer作为HTTP服务或容器运行。尽管它始于Microsoft项目,但目前官方文档和容器部署路径正在迁移到Data Privacy Stack,因此最好不要继续使用旧的MCR镜像或过时的文档链接。
为什么几个正则表达式不够用
像电子邮件或银行卡号这样格式明确的值可以通过正则表达式找到。然而,像人名、地区、组织名称这样根据上下文意义不同的值,仅凭模式很难判断。一串数字也可能是电话号码、订单号、日期或简单的数量。
Presidio Analyzer同时运行多个EntityRecognizer。官方文档解释说,它可以结合正则表达式、命名实体识别(NER)、校验和、上下文词和用户自定义逻辑。每个结果通常表示为实体类型、起始/结束位置和置信度分数。
from presidio_analyzer import AnalyzerEngine

analyzer = AnalyzerEngine()
results = analyzer.analyze(
    text="연락처는 010-1234-5678입니다.",
    language="ko"
)
不要假设这个例子在韩语中会立即产生期望的结果。您应该检查每种语言的NLP模型和Recognizer支持状态,并使用用户自定义Recognizer和测试数据来增强组织特定的实体,例如国内电话号码、居民登记号和企业注册号。
核心组件
| 组件 | 作用 | 实践中需要决定的事项 |
| — | — | — |
| AnalyzerEngine | 协调Recognizer和NLP引擎以检测PII候选 | 语言、目标实体、分数阈值 |
| EntityRecognizer | 查找特定PII类型的检测器 | 正则表达式、NER、外部模型、用户自定义逻辑 |
| RecognizerRegistry | 管理要使用的Recognizer列表 | 按国家/业务激活范围 |
| NlpEngine | 分词、NER等语言处理 | spaCy, Transformers, Stanza和模型 |
| Context Aware Enhancer | 通过周围词语增强检测分数 | 上下文词语和误报调整 |
| AnonymizerEngine | 对检测到的位置应用转换操作 | 按实体划分的去识别策略 |
| Operator | 执行替换、删除、遮蔽、哈希、加密等 | 可逆性、再识别风险、密钥/Salt管理 |
Presidio不会替组织决定“什么信息是个人信息”。可检测的实体与实际受法规/合同保护的数据可能不同,因此需要在策略层单独进行映射。
Analyzer返回什么
Analyzer返回候选区间而不改变原文。例如,字符串的第10到23个字符是PHONE_NUMBER,置信度分数为0.85。这种分离使得应用程序可以根据相同的检测结果应用不同的策略。
- 在日志中完全删除。
- 在咨询界面只保留最后四位。
- 在统计分析中,替换为可以关联同一人的假名值。
- 对于有权限的业务处理,进行加密并使用单独的密钥恢复。
分数不保证事实的准确性。提高阈值可以减少误报,但可能增加漏报;降低阈值可以捕获更多,但可能会掩盖正常数据。
Anonymizer如何改变数据
Presidio Anonymizer接收Analyzer的区间信息并应用Operator。官方文档中描述了replace、redact、mask、hash、encrypt、custom、keep等操作。
| 操作符 | 结果 | 适用场景 | 注意事项 |
| — | — | — | — |
| replace | 替换为 |
LLM提示词·日志 | 无法恢复原始值 |
| redact | 删除相应字符串 | 外部共享·最小收集 | 上下文可能被破坏 |
| mask | 将部分字符更改为*等 | 咨询界面·确认UI | 剩余字符可能导致再识别 |
| hash | 使用Salt进行哈希 | 统计关联·重复分析 | 考虑Salt管理和字典攻击 |
| encrypt | 使用密钥加密 | 需要授权再识别的业务 | 密钥必须与正文·提示词分离 |
| custom | 通过用户函数替换 | 假名生成·业务规则 | 需要验证函数的安全性和确定性 |
最新文档解释说,哈希操作默认对每个实体使用随机Salt。要在多个记录中将相同的个人信息与相同的哈希关联起来,必须直接提供一致的Salt,但如果该Salt泄露,再识别的风险就会增加。Salt和加密密钥应在KMS、Key Vault、Secrets Manager等可信存储中管理,而不是在提示词或通用配置文件中。
为什么将Presidio置于LLM之前
仅仅检查LLM不输出个人信息不足以防止输入泄露。最基本的部署是在调用模型之前,将原文通过Analyzer和Anonymizer。
사용자 입력·업로드 문서
  → Presidio 탐지
  → 업무 정책에 따른 비식별화
  → LLM 호출
  → LLM 출력 재검사
  → 사용자
输入和输出都需要检查是有原因的。输入包含用户提供的个人信息,输出可能包含模型从对话历史、搜索文档或工具结果中获取的个人信息。然而,如果在多个阶段无条件地重复遮蔽同一句话,可能会损害上下文和质量,因此必须明确每个边界的目的。
在RAG中应该如何部署
RAG是一种从Vector DB中查找与问题相关的文档,并将原文块插入LLM提示词中的方式。Presidio不是一个能够有意义地检查嵌入向量本身的工具。它应该检查检索后返回的原文块。
推荐的流程如下:
Application: 인증·Tenant 확정
  → Retrieval API: Tenant Filter와 문서 권한 적용
  → Vector DB 검색
  → 반환된 원문 청크
  → Presidio: PII 탐지·비식별화
  → LLM 프롬프트 조립
Presidio不判断租户权限。先搜索不应访问的文档,然后只遮蔽个人信息,这不是正确的授权。应首先应用文档访问控制和安全修剪,然后进一步检查允许的原文中的个人信息。
如果与NeMo Guardrails一起使用,可以在Retrieval Rail的Custom Action中调用Presidio,或者在应用程序拥有的搜索API中调用。NeMo协调整个LLM流程,Presidio处理请求文本中的PII。
选择库还是HTTP服务
对于Python应用程序,将presidio-analyzer和presidio-anonymizer安装在同一个进程中是最简单的方法。没有网络传输,易于进行细粒度自定义,但NLP模型会占用应用程序内存和启动时间。
如果多语言应用程序或多个团队使用通用策略,可以将Analyzer和Anonymizer分离为HTTP服务。官方安装文档目前指向GHCR上的data-privacy-stack镜像,并建议在生产环境中固定到明确的发布标签,而不是`latest`。
podman run -d --name presidio-analyzer
  -p 5002:3000
  ghcr.io/data-privacy-stack/presidio-analyzer:latest

podman run -d --name presidio-anonymizer
  -p 5001:3000
  ghcr.io/data-privacy-stack/presidio-anonymizer:latest
虽然`latest`在教程中很方便,但在生产部署中应固定到经过验证的版本标签和镜像摘要。服务分离有利于策略集中化,但由于原文个人信息会再次通过网络传输,因此需要TLS、服务认证、请求日志遮蔽和超时。
必须使用Presidio的场景
- 需要在LLM提示词或响应中一致地检测和遮蔽PII。
- 需要在日志、数据分析和外部共享中重用相同的去识别策略。
- 除了正则表达式,还需要NER、上下文、校验和以及用户自定义Recognizer。
- 需要在Python库和HTTP服务之间选择部署方式。
- 需要对每个实体应用不同的删除、部分遮蔽、哈希、加密策略。
相反,如果输入字段严格结构化,并且一个小型服务只需要删除一个电子邮件字段,那么简单的验证代码可能更合适。Presidio的价值在于重复处理各种非结构化文本和多种策略时才能体现出来。
必须了解的局限性
Presidio不是一个能够自动查找所有个人信息的完整DLP产品。它存在语言和领域相关的误报和漏报,新的标识符和组合标识符可能不被默认的Recognizer所知。即使删除了姓名,结合工作地点、罕见疾病、日期和地区仍然可能重新识别个人。
此外,如果将检测结果直接保留在日志中,旨在保护的原文可能会在观测系统中被复制。调试决策跟踪、API请求/响应、错误消息和样本数据都应作为个人信息处理对象来对待。
性能也需要考虑。与仅使用正则表达式相比,同时运行NLP模型可能会提高准确性,但会增加CPU/GPU、内存和延迟。应使用反映实际数据语言、长度和实体分布的测试集来调整阈值和Recognizer。
结论
Microsoft Presidio不是一个负责LLM整体安全的护栏平台。它是一个专业的引擎,提供Analyzer来查找原文中的个人信息候选,并提供Anonymizer根据策略更改值。
使用Presidio的原因是将个人信息保护从“请求模型的一句话”变为在模型调用前后执行的数据处理步骤。然而,租户权限、合法处理依据、加密密钥和最终访问批准必须由应用程序和可信的安全层负责。
正确的部署很简单:首先强制执行认证和文档权限,然后使用Presidio检测和去识别允许的原文,最后将其传递给LLM或分析系统。通过遵守这种职责分离,Presidio将成为LLM、RAG和日志管道中实际减少个人信息暴露范围的强大组件。
发表回复