在本地PC或公司GPU服务器上运行LLM时,Ollama、vLLM和llama.cpp几乎总是同时出现。这三者都可以下载模型进行推理并提供HTTP API,但它们的设计理念却大相径庭。
Ollama将复杂的模型执行过程封装成产品,使其易于使用;vLLM则专注于在GPU上以高吞吐量服务多个用户请求。llama.cpp是一个基于C/C++的轻量级运行时,擅长在各种CPU和GPU上精细地执行GGUF模型。
本文将不以简单的速度排名为依据,而是根据个人实验、应用程序开发、企业服务和边缘部署等实际目的来比较这三种工具。
一目了然的结论
| 工具 | 最适合的场景 | 模型格式与生态系统 | 核心优势 | 首先要确认的弱点 |
| — | — | — | — | — |
| Ollama | 在笔记本·工作站上快速运行模型并与应用程序连接 | 自有模型库、Modelfile、GGUF导入 | 安装和模型管理简便,支持macOS·Windows·Linux | 大规模多用户服务的精细调优受限 |
| vLLM | 在NVIDIA·AMD GPU服务器上以高并发吞吐量提供API | 以Hugging Face模型为中心,支持多种量化方式 | PagedAttention、连续批处理、分布式推理、OpenAI兼容API | 安装·GPU兼容性·运营设计相对复杂 |
| llama.cpp | 在CPU·Apple Silicon·小型GPU·边缘设备上轻量且精细地运行 | 以GGUF为中心 | 低依赖性、广泛的硬件支持、量化和卸载控制 | 用户需要更深入地理解模型转换和选项选择 |
最简短的总结如下:
个人开发者应从Ollama开始,基于GPU的多用户服务应从vLLM开始,资源受限环境和精细本地调优应从llama.cpp开始考虑。
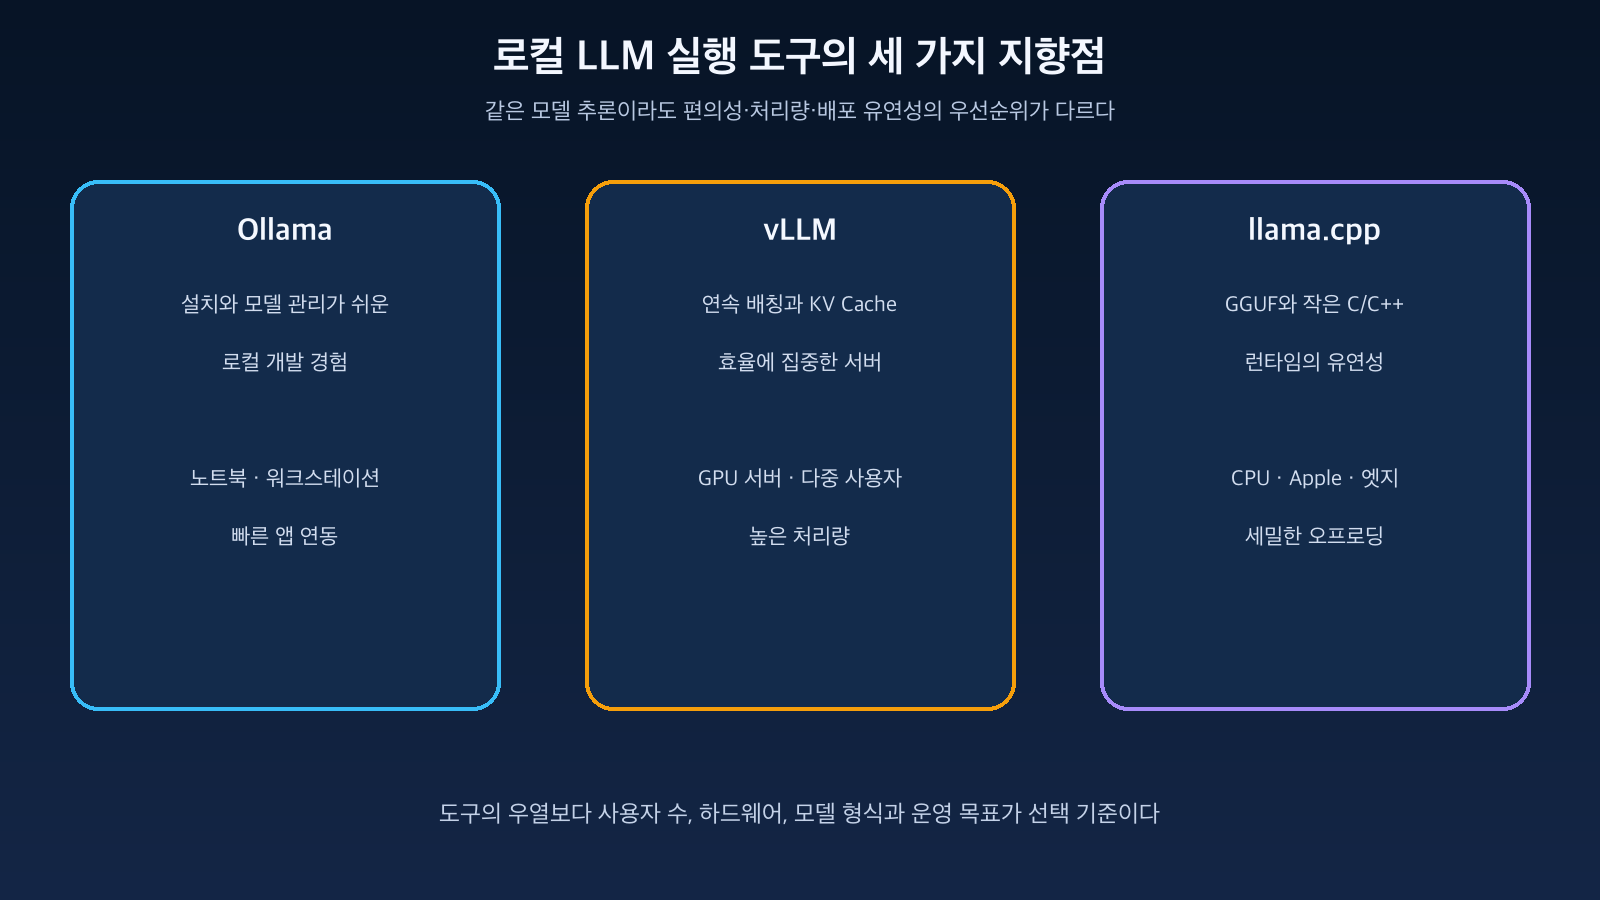
图:三种工具的主要用途和执行层 · 基于Ollama、vLLM、llama.cpp官方文档重构
Ollama — 将本地LLM视为应用程序
Ollama的优势在于将模型文件、聊天模板、执行选项和API服务器整合为一体的用户体验。在macOS、Windows、Linux上安装后,只需指定模型名称即可连续完成下载和运行。
ollama run gemma3本地服务器默认在http://localhost:11434运行,并提供自己的API。
curl http://localhost:11434/api/chat -d '{
  "model": "gemma3",
  "messages": [{"role": "user", "content": "KV Cache를 설명해줘"}]
}'
官方Modelfile是一个蓝图,它将基础模型、系统提示、参数、模板和适配器一起定义。这非常适合团队管理重复使用的本地模型配置。
FROM gemma3
PARAMETER temperature 0.2
SYSTEM 당신은 인프라 기술 문서를 설명하는 조력자다.
Ollama支持Apple GPU的Metal加速,NVIDIA、AMD ROCm和实验性的Vulkan支持也在官方文档中有所说明。它能最快地满足“先在本地对话并连接到应用程序”的需求,而不是直接构建模型和组合服务器选项。
然而,本地API默认不需要认证。官方认证文档也明确指出localhost:11434的本地访问没有认证。因此,应避免将API绑定到0.0.0.0并直接暴露到内网或互联网,而应单独配置反向代理、认证和防火墙。
vLLM — 让GPU高效共享多个请求
vLLM更像是一个推理服务器引擎,而非个人聊天应用。在多个用户同时发送长提示的环境中,KV Cache会占用大量GPU内存,且请求长度不同会导致内存碎片化和空闲时间。
vLLM通过PagedAttention将KV Cache像页面一样管理,并通过连续批处理(continuous batching)减少GPU的空闲时间。最新的官方文档将分块预填充(chunked prefill)、前缀缓存(prefix caching)、推测解码(speculative decoding)、多种量化和分布式并行化作为主要功能。
vllm serve Qwen/Qwen2.5-7B-Instruct
  --dtype auto
  --api-key local-token
默认服务器在http://localhost:8000运行,并提供OpenAI兼容API。
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local-token",
)

response = client.chat.completions.create(
    model="Qwen/Qwen2.5-7B-Instruct",
    messages=[{"role": "user", "content": "안녕하세요"}],
)
如果现有应用程序使用OpenAI SDK,只需更改base_url即可轻松连接到本地服务器。除了Chat Completions,Responses、Embeddings和语音相关API等支持范围也在扩展,但不应假设所有OpenAI选项都能完全相同地工作。应在官方兼容性文档中查看每个端点的限制。
vLLM的优势在并发用户增加时会变得明显。反之,如果一个人在笔记本上一次只执行一个请求,那么其收益可能不足以抵消安装和操作的复杂性。
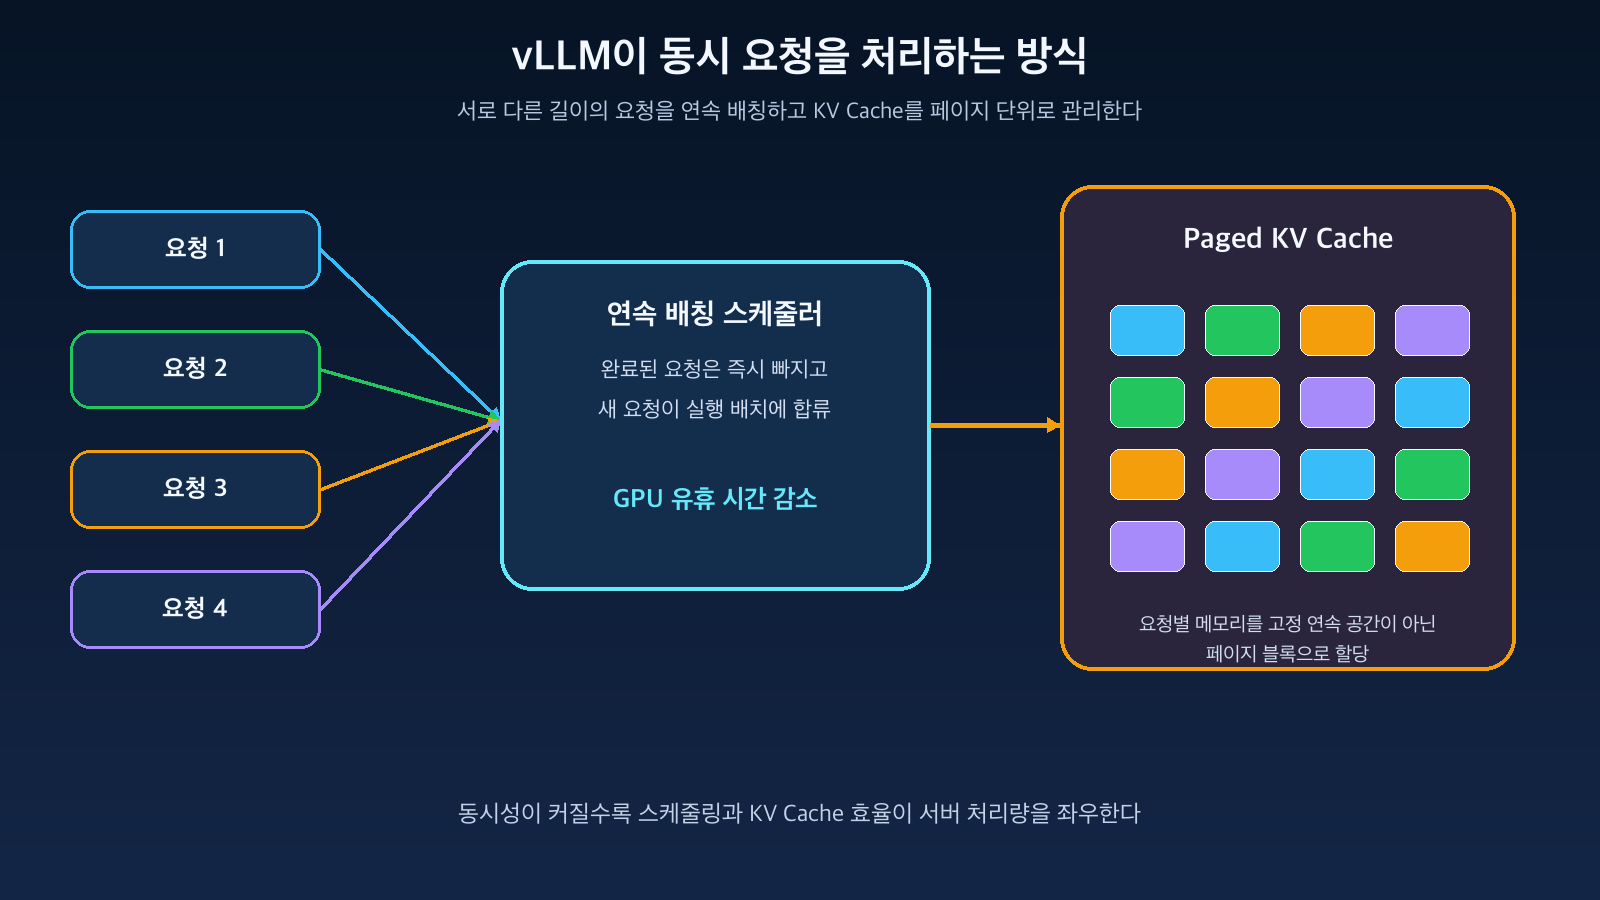
图:vLLM的连续批处理和页面级KV Cache管理概念 · 基于vLLM官方文档重构
llama.cpp — 以小型运行时和GGUF拓展硬件边界
llama.cpp是一个基于C/C++的推理项目。它可以在广泛的环境中运行模型,包括纯CPU系统、Apple Silicon、消费级GPU以及混合CPU·GPU卸载。
核心模型格式是GGUF。GGUF文件不仅包含模型权重,还可以包含执行所需的元数据,并以Q4·Q5·Q8等多种量化级别发布。量化是一种权衡,它以牺牲潜在精度为代价,减少内存使用和提高速度。
llama-cli -m model.Q4_K_M.gguf -p "Self-Attention을 설명해줘"使用llama-server可以运行一个轻量级的HTTP服务器,提供基本的Web UI和OpenAI兼容的Chat Completions端点。
llama-server -m model.Q4_K_M.gguf --port 8080官方README还提供了并行解码、嵌入、重排序、基于语法的结构化输出和推测解码。可以精细调整GPU层数、上下文大小、批处理和线程等选项,这对于希望将运行时嵌入到嵌入式、边缘或桌面产品的开发者来说非常有利。
另一方面,用户需要理解模型的GGUF兼容性、量化类型和内存预算。即使是“相同的7B模型”,所需的内存和结果质量也会因量化级别、上下文长度和KV Cache精度而异。
为什么相同的模型内存和速度会不同?
在选择工具之前,首先要考虑模型大小和执行条件。大致的权重内存可以这样估算:
가중치 메모리 ≈ 파라미터 수 × 파라미터당 바이트例如,一个8B模型如果只用FP16进行简单计算,大约需要16GB的权重空间。4位量化理论上可以减少到约4GB,但实际执行时还需要额外的元数据、运算缓冲区、KV Cache和运行时冗余空间。
特别是当上下文变长和并发请求增加时,KV Cache会变大。在个人单次对话中,模型权重是主要负担,但在服务器中,并发用户数和最大上下文会极大地改变容量规划。
| 比较标准 | 个人单次请求 | 多用户服务器 |
| — | — | — |
| 最关注点 | 安装便利性,模型是否能载入内存 | 吞吐量、延迟、KV Cache和批处理 |
| 量化效果 | 扩大在低配置设备上的运行可能性 | 可能增加每个GPU承载的模型·请求数量 |
| 上下文增加的影响 | 单次对话的KV Cache增加 | 所有活跃请求的KV Cache累加 |
| 代表性选择 | Ollama或llama.cpp | 以vLLM为中心进行评估 |
三种工具并非完全独立
Ollama和llama.cpp在GGUF和本地推理领域有连接点,vLLM在最新版本中也支持包括GGUF在内的多种量化方式。因此,如果断言“GGUF必然是llama.cpp”或“Hugging Face模型必然是vLLM”,可能会错过最新功能。
然而,支持与否和运营适用性是不同的。能够读取某种格式的事实,与该格式是该引擎的主要路径的事实,需要区分开来。性能和稳定性会因模型架构、量化内核和硬件后端而异,因此应使用实际的候选模型进行基准测试。
按目的选择指南
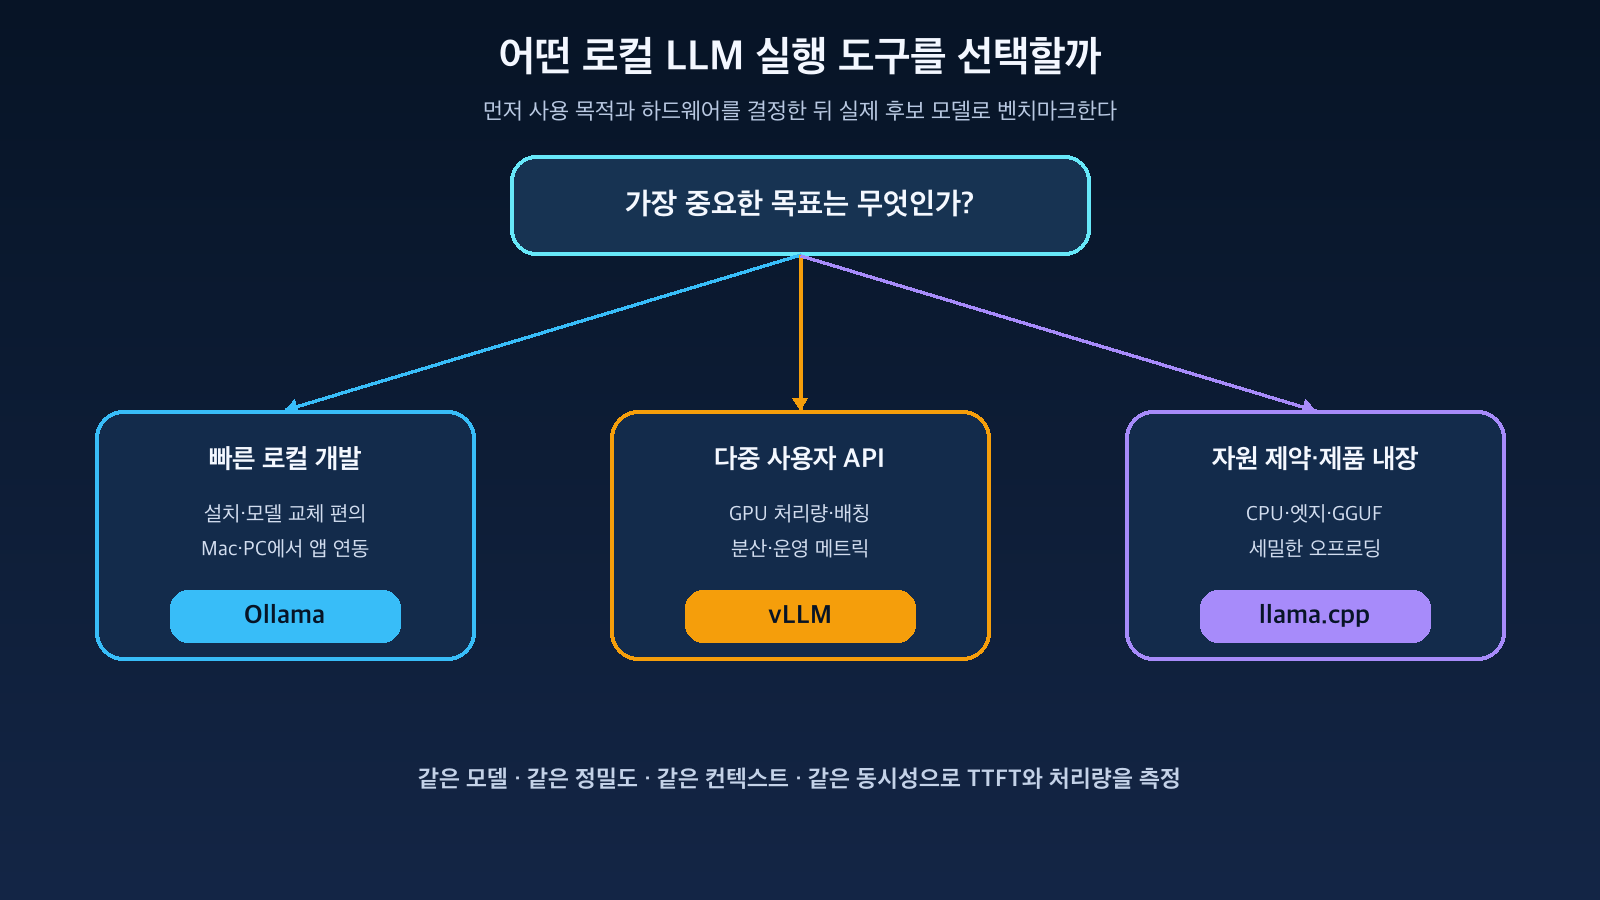
图:根据使用目的和硬件选择Ollama·vLLM·llama.cpp的流程 · 基于三个项目的官方文档重构
如果开发者在笔记本上测试RAG
Ollama最方便。模型安装和更换简单,本地API即时可用,因此易于与LangChain、LlamaIndex、Open WebUI等工具连接。在MacBook的Apple Silicon上也能利用Metal加速。
如果公司内部聊天机器人有多人同时使用
最好首先在GPU服务器上考虑vLLM。其连续批处理、KV Cache管理、OpenAI兼容API、指标和分布式执行功能符合服务运营目的。但是,认证、TLS、请求限制和租户隔离需要在单独的网关中设计。
如果需要嵌入到CPU服务器或边缘设备中
llama.cpp很强大。它可以作为可执行文件和库的形式包含,并且可以精细调整GGUF量化和CPU·GPU卸载。
如果单个GPU只有少数用户使用
应在相同的模型、相同的上下文、相同的并发条件下测量Ollama和vLLM。如果设置便利性更重要,Ollama更有优势;如果请求吞吐量和运营指标更关键,vLLM更具优势。
基准测试时容易忽略的标准
不应仅凭每秒令牌数来下结论。
- TTFT (Time To First Token):生成第一个令牌的延迟
- TPOT (Time Per Output Token):后续令牌生成间隔
- 并发请求数增加时的总吞吐量
- 长提示的预填充时间
- 最大上下文中的内存使用量
- 模型加载时间和冷启动
- 量化导致的回答质量变化
- 故障重启、指标、日志和部署自动化
即使是相同的模型名称,如果精度和量化文件不同,比较也不公平。应固定输入长度、输出长度、并发性、采样参数,并使用实际业务提示进行测量。
运营安全不能由推理引擎代劳
仅仅因为在本地运行并不意味着安全。如果将API暴露给其他主机,则仍然需要一般的服务安全措施。
- 应用TLS和认证的API网关
- 按用户·应用程序的速率限制和使用量限制
- 模型文件和缓存目录的访问控制
- 可信的模型来源和哈希验证
- 提示·响应日志中的个人信息脱敏
- 容器和GPU节点的最小权限
- 工具调用模型的执行权限分离和审批
特别是,应避免将Ollama本地API直接暴露到网络、多个系统共享一个vLLM API密钥,或将llama-server未经认证连接到互联网的配置。
结论
Ollama、vLLM和llama.cpp是角色不同而非优劣之分的工具。
Ollama在轻松下载和运行模型以及与开发工具连接的本地体验方面表现出色。vLLM是一个推理服务引擎,可在GPU服务器上高效处理多个请求。llama.cpp则基于GGUF和轻量级C/C++运行时,适用于各种硬件和产品嵌入环境。
不要先选择工具;相反,应先确定用户数量、硬件、模型格式、上下文长度和操作方式,然后使用实际的候选模型进行测量。
如果从个人实验开始,Ollama是一个很好的起点;如果服务流量是问题,vLLM;如果资源限制和部署灵活性是关键,那么llama.cpp是更好的选择。
发表回复