新しいAIモデルが発表されるたびに、「今、最も性能の良いAIは何ですか?」という質問がつきまといます。しかし、検索してみると、あるサイトではClaudeが1位であり、別のサイトではGPTやGeminiが先行し、コーディングランキングではまた別のモデルが上位に現れます。
この違いは、どのサイトが間違っているからではありません。人々に好ましい回答を選ばせる評価、正解のある問題を自動採点する評価、実際のGitHubイシューを解決するエージェント評価が、それぞれ異なる能力を測定しているためです。
この記事では、2026年7月31日現在で多く活用されているAI性能比較サイトを評価方式別に整理します。ランキング表の数字をそのまま信じるのではなく、自身の用途に合ったシグナルを選び出す方法まで見ていきましょう。
まず結論:一つの「世界AI総合ランキング」は存在しない
AIモデルには、試験成績一つで表現しにくい様々な属性があります。
- 一般的な会話で人が好む回答を作成するか?
- 数学・科学・推論問題で正解を当てるか?
- 実際のソフトウェアリポジトリのバグを修正するか?
- 応答が速く、API費用が合理的か?
- 重みをダウンロードして社内環境に展開できるか?
- 長い文書や画像、ツール呼び出しを安定して処理できるか?
したがって、「AI 1位」という表現には必ず評価基準が付随しなければなりません。会話の好みで1位、コーディングエージェントで1位、費用対効果で1位は、それぞれ異なるモデルである可能性があります。
最も実用的なアプローチは、一つのサイトの総合点だけを見るのではなく、目的に応じて2〜3つの評価をクロスチェックすることです。
AI性能比較サイト一覧
| サイト | 主に測定するもの | 評価方式 | 最も適した質問 | 注意点 |
| — | — | — | — | — |
| Arena | 実際のユーザーの回答の好み | 匿名モデル間の1:1比較と人の投票 | どのチャットボットの回答を人々はより好むか? | 文体・回答の長さの影響が混ざる可能性あり |
| Artificial Analysis | 知能・速度・遅延・価格・コンテキスト | 多数のベンチマークとAPI実測 | 品質と費用、速度を一緒に比較すると? | 総合指数の構成と実行設定を確認する必要あり |
| LiveBench | 最新の客観式・正答型能力 | 新しい問題と客観的な自動採点 | 学習データ汚染の影響を減らした推論性能は? | 実際の会話体験全体を代表するものではない |
| SWE-bench | 実際のレポジトリイシュー解決能力 | コードエージェントがパッチを作成しテスト実行 | コーディングエージェントは実際のバグを修正できるか? | モデルだけでなくエージェント構造とツール設定の影響が大きい |
| Hugging Face Leaderboards | 公開重みモデルと分野別評価 | 公開データセット・再現可能な評価パイプライン | 直接デプロイするオープンモデルを比較するには? | 過去のOpen LLM Leaderboardは終了し、個別のリーダーボードの目的が異なる |
この表で重要な部分は「評価方式」です。同じモデル名が表示されても、プロンプト、推論強度、ツール使用、サンプリング設定、提供APIが異なれば結果は異なる可能性があります。
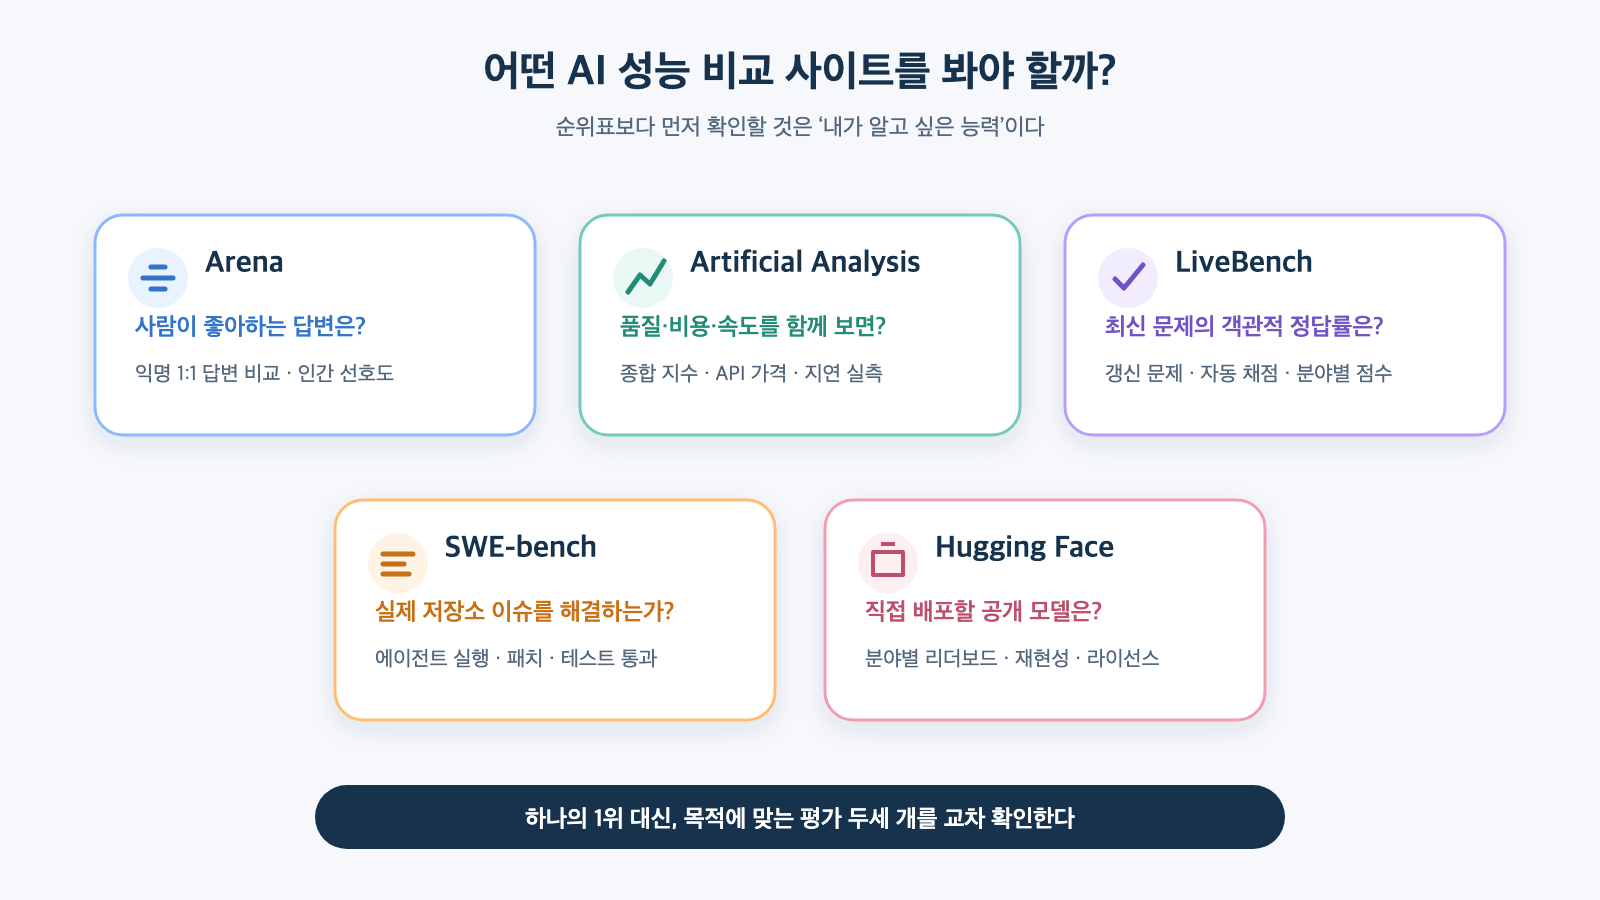
図:知りたいAI能力に応じた比較サイト選択案内 · Arena、Artificial Analysis、LiveBench、SWE-bench、Hugging Face Leaderboardsを基に再構成
1. Arena — 人が実際に好む回答を比較する
Arenaは、2つのモデルの名前を隠した状態で同じ質問に対する回答を表示し、ユーザーがより良い回答を選択するように促します。このような匿名1:1対決の結果を累積して、モデルの相対的な順位を計算します。
この方式の強みは、固定された試験問題だけでは捉えにくい実際の使用経験を反映するという点です。説明の自然さ、指示遵守、文章の品質、会話の流れなど、人が体感する要素が投票に含まれます。
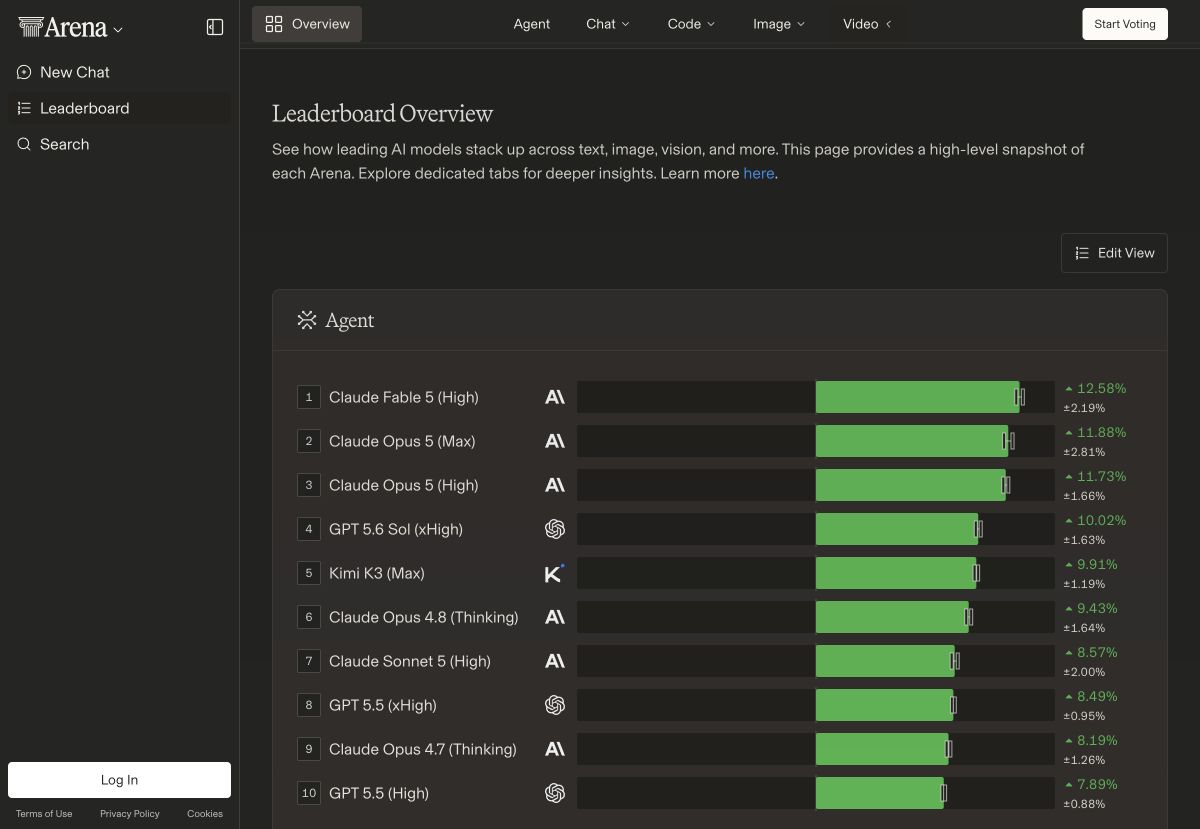
画面キャプチャ:Arena Leaderboard Overviewのエージェント順位 · 2026年7月31日現在 · Arena公式リーダーボード
Arenaの順位は、次の状況で特に有用です。
- 汎用チャットボットの全体的な回答満足度を比較する際
- 文章作成と説明能力が重要なモデルを探す際
- リリース直後の新モデルが既存モデルと比較してどのような反応を得るかを見る際
- テキストだけでなく、ビジョン・検索など詳細なArenaを確認する際
ただし、人の好みがそのまま事実の正確性や業務の成功率を意味するわけではありません。回答が長く、構造が華やかであれば、実際の内容よりも良い評価を受ける可能性があります。Arenaの研究陣も、回答の長さやMarkdownの使用といったスタイル要素を統制すれば順位が変わる可能性があることを分析しました。
したがって、Arenaは「人々がどの回答をより好んだか?」には強いですが、「どのモデルが数学問題をより正確に解いたり、実際のレポジトリのバグをより多く修正するか?」に対する単独の根拠として使用するには不十分です。
2. Artificial Analysis — 性能と費用、速度を一つの画面で見る
Artificial Analysisは、モデルの知能スコアだけでなく、API価格、出力速度、最初のトークン遅延時間、全体の応答時間、コンテキストウィンドウを一緒に比較します。
2026年7月現在、Intelligence Index v4.1は、知識業務、ツール使用、ターミナルコーディング、科学推論、幻覚抑制、長い文脈推論など、複数の評価を組み合わせています。サイトには総合スコアとともに各評価結果が提供されるため、平均だけを見るのではなく、詳細な強みを確認できます。
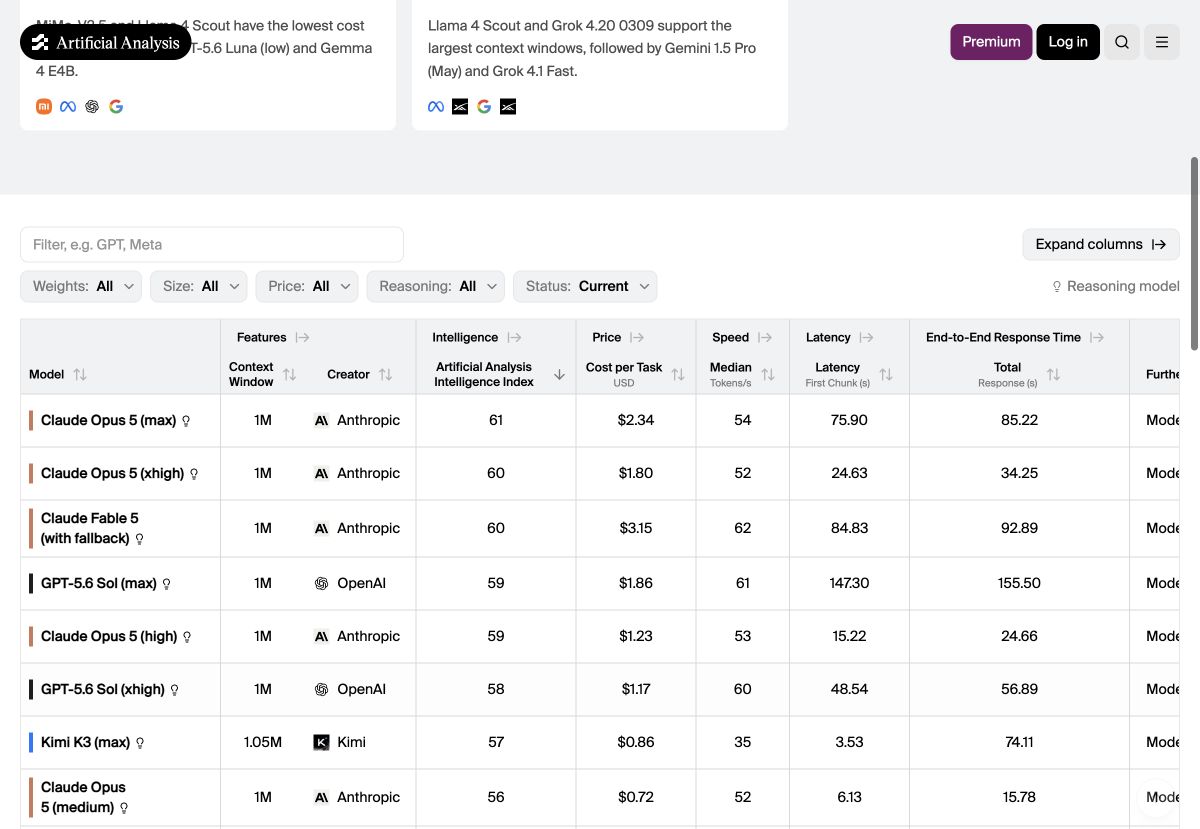
画面キャプチャ:モデル別Intelligence Index、タスクあたりの費用、速度、遅延時間比較 · 2026年7月31日現在 · Artificial Analysis公式リーダーボード
Artificial Analysisの最大の利点は、モデル導入を現実的な製品意思決定に繋げられる点です。最も高いスコアのモデルであっても、応答が遅すぎたり、タスクあたりの費用が過度に高ければ、大規模サービスには適さない可能性があります。
次の項目を一緒に見ることが推奨されます。
- Intelligence Index: 複数の能力を合わせた品質指標
- 個別評価: コーディング・知識・推論・エージェントなど業務関連の詳細スコア
- Cost per Task: 実際の評価作業1件を処理するのにかかった費用
- Output Speed: 最初の応答以降、1秒あたりに生成されるトークン数
- Time to First Answer Token: 推論時間を含め、最初の回答が出るまでの遅延
- End-to-End Response Time: 一定の長さの回答をすべて受け取るまでにかかる時間
- Context Window: 入力と出力を合わせて処理できる最大トークン範囲
APIベースのサービスを企画するなら、総合順位よりも「私たちのサービスが許容できる遅延と費用の中で最も高い品質を出すモデル」を探すのにこのサイトが有用です。
3. LiveBench — 最新の問題でデータ汚染を減らす
LiveBenchは、ベンチマーク問題が学習データに含まれてスコアが水増しされる汚染問題を減らすために作られました。最近の数学大会、論文、ニュース、データセットなどから問題を構成し、正解がある方式で自動採点します。
現在、サイトは推論、コーディング、エージェントコーディング、数学、データ分析、言語、指示遵守など、複数のカテゴリを分けて提供しています。モデルの全体スコアだけでなく、下位課題と成功したタスクあたりの費用も一緒に見ることができます。
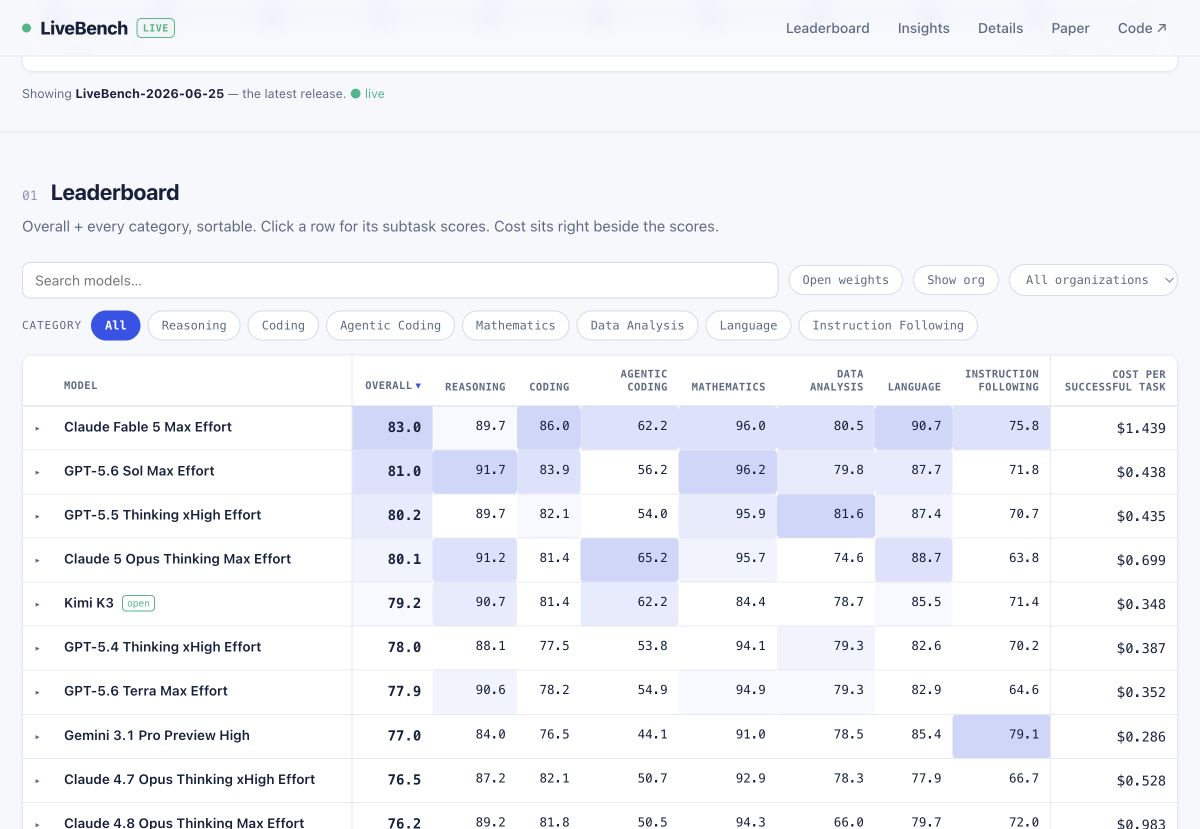
画面キャプチャ:LiveBench最新リリースの分野別スコアと成功タスクあたりの費用 · 2026年7月31日現在 · LiveBench公式リーダーボード
LiveBenchが有用な理由は次のとおりです。
- 古い有名な試験問題がモデルにすでに学習されている可能性を減らす
- 人や他のLLMの主観的な採点よりも客観的な正解を優先する
- 全体平均だけでなく、分野別の性能差を確認できる
- 公開モデルと非公開商用モデルを同じカテゴリで比較できる
しかし、最新の問題を客観的に採点するからといって、実際の業務を完全に再現するわけではありません。顧客相談の共感能力、長いプロジェクトの文脈維持、社内文書から根拠を探すRAG品質のような要素は、別途の実験が必要です。
LiveBenchは「新しい問題をどれだけ正確に解決するか」を見る強いシグナルとして活用し、使いやすさの評価はArenaや自社業務テストで補完する方が良いでしょう。
4. SWE-bench — モデルではなくコーディングエージェントシステムを評価する
SWE-benchは、実際のオープンソースリポジトリのイシューとコード状態を提供し、AIが問題を分析してパッチを作成し、テストを通過するかを評価します。
代表的なSWE-bench Verifiedは、人がレビューした500個の問題で構成されます。Multilingual, Lite, Full, Multimodalなど目的が異なる下位リーダーボードもあるため、結果を比較する際は同じデータセットを見ているかまず確認する必要があります。
画面キャプチャ:SWE-bench Verified公式結果表の解決率、平均費用、エージェントバージョン · 2026年7月31日現在 · SWE-bench公式リーダーボード
SWE-benchのスコアは、単純なコード生成能力よりも実際のソフトウェア作業に近いです。
이슈 설명 읽기
→ 저장소 탐색
→ 관련 코드와 테스트 분석
→ 수정안 작성
→ 테스트 실행
→ 실패 원인 확인과 재수정
→ 최종 패치 제출
ここで重要な点は、リーダーボードの一行がモデル単独の性能ではない可能性があるということです。同じモデルであっても、どのようなエージェントフレームワークを使用したか、検索・編集・テストツールをどのように提供したか、最大費用と繰り返し回数をどれくらいに設定したかによってスコアは変わる可能性があります。
コーディングツールを選ぶ際は、次を一緒に確認する必要があります。
- 同じSWE-benchの下位データセットか?
- モデルとエージェントのバージョンは同じか?
- ツール呼び出しと繰り返し回数制限は何か?
- 問題あたりの費用と実行時間はいくらか?
- 提出結果は公式検証を経ているか?
SWE-benchはコーディングAIを比較する上で重要な資料ですが、スコアを「言語モデルの純粋な知能」として読むのではなく、「モデル・プロンプト・ツール・エージェントが結合されたシステムの成功率」として読むべきです。
5. Hugging Face Leaderboards — オープンモデルは分野別リーダーボードで見る
Hugging FaceのLeaderboardsドキュメントは、Hubで公開モデルとデータセットを評価し、リーダーボードを構成する方法を提供します。モデルの重み、正確なリビジョン、精度、評価設定を一緒に記録できるため、再現性と直接デプロイ可能性を重視する場合に有用です。
画面キャプチャ:Hugging Face Hubの評価結果、コミュニティリーダーボード、Open LLM Leaderboardの区分 · 2026年7月31日現在 · Hugging Face Leaderboards公式ドキュメント
ここで一つ、必ず知っておくべき変化があります。広く知られていたHugging Face Open LLM Leaderboardは、2025年3月に公式に終了しました。運営陣は2年間で1万3千個以上のモデルを評価しましたが、推論モデルとアシスタントが発展するにつれて、既存の評価が徐々に現在の能力を適切に反映できなくなったと説明しました。
したがって、今は「Hugging Faceランキング」という一つの表を探すのではなく、目的別のコミュニティリーダーボードを選択する必要があります。
- 公開重み汎用言語モデル
- コーディングモデル
- 韓国語・多言語モデル
- ビジョン言語モデル
- 埋め込み・再ランキングモデル
- 特定ドメインまたは独自データセット評価
オープンモデルを社内に展開する場合、順位以外にもライセンス、モデルサイズ、活性パラメータ、要求GPUメモリ、量子化サポート、コンテキスト長、商業的利用制限を一緒に確認する必要があります。
なぜサイトごとに1位が異なるのか?
サイトごとに1位が異なる理由は、評価対象と採点過程が異なるためです。
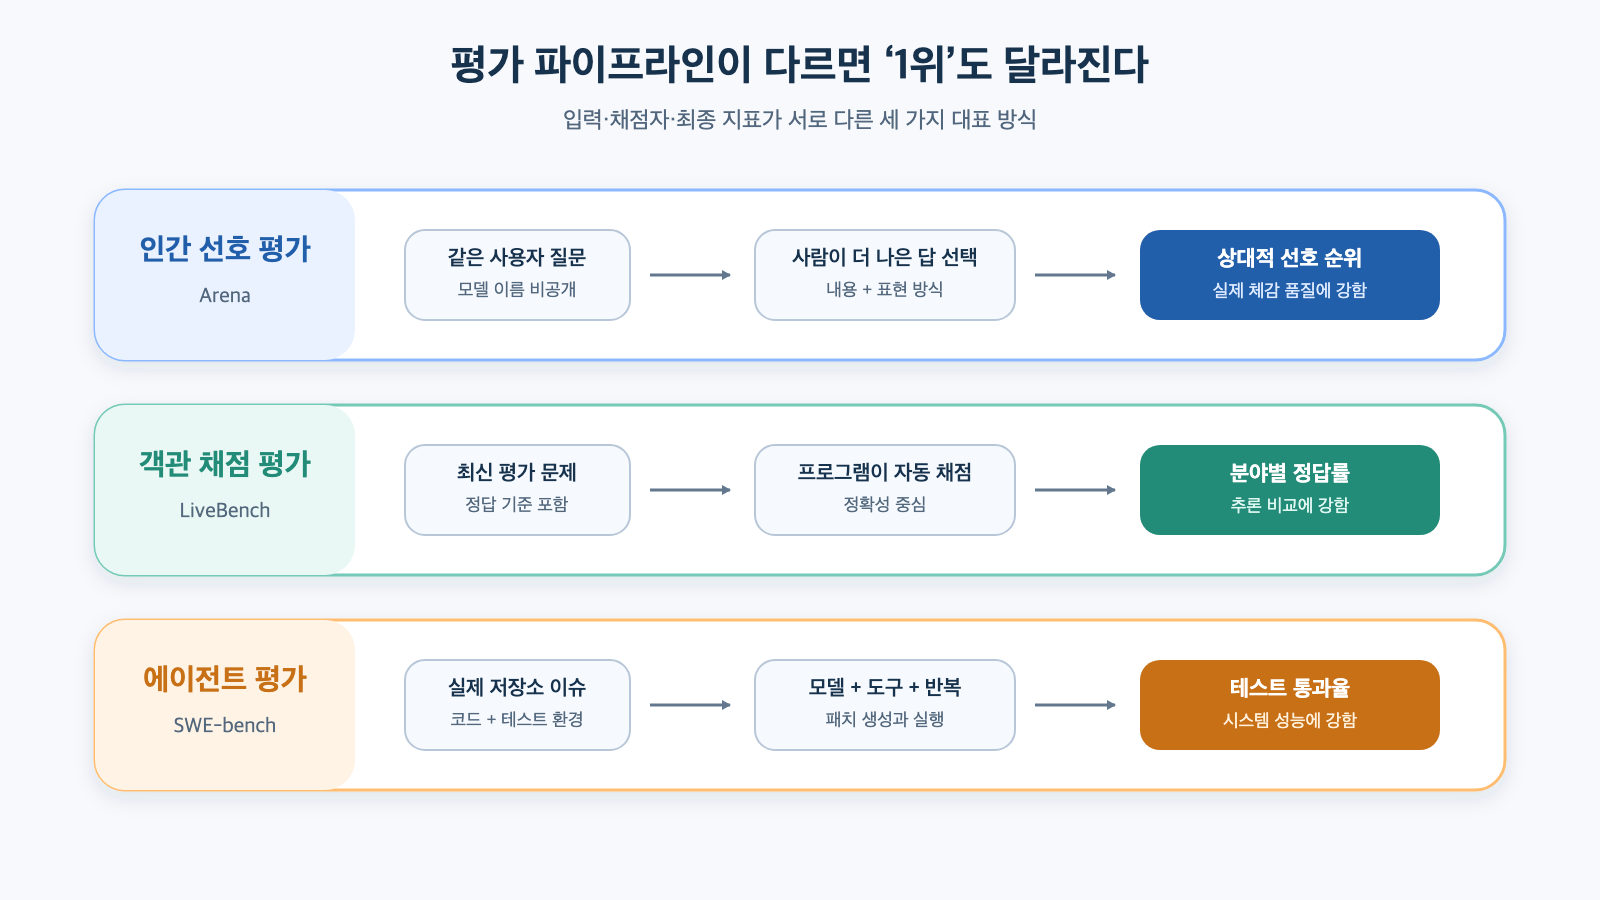
図:人間選好・客観採点・エージェント評価の入力と採点、最終指標の違い · Arena研究、LiveBench研究、SWE-benchを基に再構成
人の好みと正答率は異なる
Arenaでは、自然で親切な回答が高い好感を得る可能性があります。一方、LiveBenchでは最終的な答えが正確でなければ点数を得られません。見栄えの良い誤答は客観式ベンチマークで高い点数を得ることはできません。
モデル設定が異なる
同じモデルでも、推論の努力、温度、システムプロンプト、ツール使用の有無によって結果が異なります。モデル名が同じだからといって、同じ条件で評価されたと仮定してはいけません。
モデルとエージェントは異なる
SWE-benchのように複数の段階を実行する評価では、モデルだけでなく、ファイル検索、コード編集、テスト実行、エラー回復を担当するエージェント構造が性能に大きな影響を与えます。
評価時点が異なる
商用APIモデルは同じ名前でアップデートされる可能性があり、リーダーボードごとに新しいモデルを反映する速度も異なります。スコアの横にあるモデルバージョンと評価日付を確認する必要があります。
ベンチマーク汚染と最適化が存在する
公開された試験問題が学習データに含まれたり、開発会社が特定のベンチマークに合わせてモデルを調整したりすると、実際の汎化性能よりもスコアが高くなる可能性があります。LiveBenchのように問題を更新する理由もここにあります。
ランキング表を読む際に必ず確認すべき8つのこと
- 何を測定しているか:好み、正確性、コーディング成功率、速度のうちどれか?
- 誰が採点しているか:人、正解ベースのプログラム、LLM審査者のうちどれか?
- 同じモデル設定か:推論強度とツール使用条件は同じか?
- バージョンと日付があるか:モデルのエイリアスではなく、具体的なバージョンを比較したか?
- 標本と信頼区間は十分か:わずかな点数差が統計的に意味があるか?
- 費用は含まれているか:最高点数が実際の予算内で持続可能か?
- 公開重みと商用APIを区別しているか:直接デプロイできるモデルか?
- 自分の業務と似ているか:評価問題が実際の使用事例と十分に類似しているか?
上位2つのモデルの点数差が0.5点だからといって、実際に優劣が確定したと見ることはできません。信頼区間が重なったり、評価条件が異なれば、事実上同程度のレベルである可能性があります。
目的別にどのサイトを見ればよいか?
一般的なチャットボットと文章作成
Arenaで人の好感度を確認し、LiveBenchの言語・指示遵守スコアで正確性を補完します。最後には、韓国語の文体と事実検証を含む独自の質問セットを実行します。
APIベースのサービス
Artificial Analysisで知能、最初の応答遅延、全体の応答時間、タスクあたりの費用を一緒に見ます。候補を2〜3つに絞った後、実際のトラフィック長とシステムプロンプトで負荷テストを実行します。
コーディングエージェント
SWE-benchで同じデータセットとエージェント条件を比較します。単純なコード問題の点数よりも、リポジトリ探索とテスト通過率、問題あたりの費用を一緒に確認します。
社内構築型オープンモデル
Hugging Faceの分野別リーダーボードで候補を探し、ライセンスとハードウェア要件を確認します。その後、会社の文書、韓国語、セキュリティポリシー、RAG検索品質を独自に評価します。
研究と客観的推論能力
LiveBenchのように更新される正解ベースの評価とArtificial Analysisの個別ベンチマークをクロスチェックします。総合点数よりも、自身の研究分野に近い下位課題を優先します。
最も正確な方法は、小さな社内リーダーボードを作成することです
公開リーダーボードは候補を絞り込むツールであり、最終的な購入決定を代行するものではありません。実際の業務を代表する30〜100個の評価問題を作成すれば、はるかに正確な結論を得ることができます。
공개 리더보드로 후보 3~5개 선정
→ 실제 업무 질문과 정답 기준 준비
→ 같은 시스템 프롬프트와 도구 조건 적용
→ 품질·지연·비용·안전성 측정
→ 실패 사례를 사람이 검토
→ 용도별 모델과 폴백 정책 결정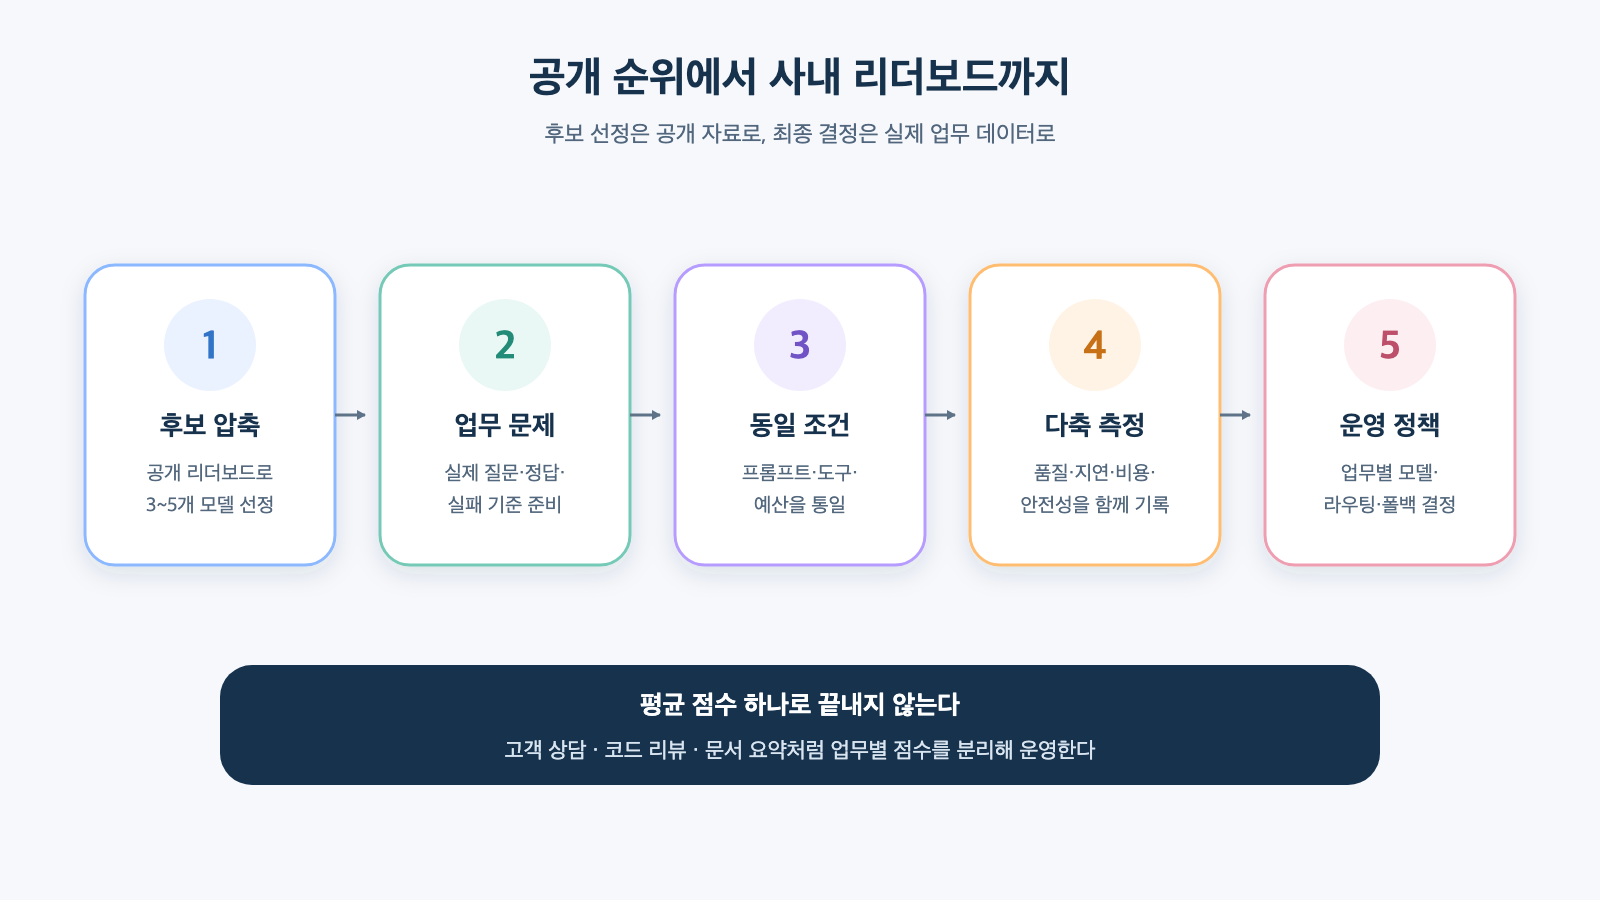
図:公開リーダーボード候補選定から業務別運用ポリシーまでの内部評価の流れ · Artificial Analysisモデル比較方法と本文の評価手順を基に再構成
例えば、セキュリティチームであれば、脆弱性説明の正確性、根拠リンク、過度な攻撃指示の遮断、ログ分析、韓国語レポートの品質を一緒に評価する必要があります。開発チームであれば、既存のリポジトリ規則遵守、テスト通過、修正範囲、トークン費用がより重要になる可能性があります。
平均点数一つだけを作成するよりも、「顧客相談」、「コードレビュー」、「文書要約」のように業務別に点数を分ける方が良いでしょう。そうすることで、一つのモデルをすべての業務に無理に適用するのではなく、用途別のルーティングやフォールバックを設計できます。
最終まとめ
AI性能比較サイトは、互いに競合する一つのランキング表ではなく、異なる質問に答える測定ツールです。
- Arenaは実際のユーザーの回答の好みを示します。
- Artificial Analysisは知能と価格、速度、遅延を一緒に比較します。
- LiveBenchは最新の問題と客観的な採点で推論能力を確認します。
- SWE-benchはモデルとツールが結合されたコーディングエージェントの実際のイシュー解決能力を評価します。
- Hugging Face Leaderboardsは、公開モデルと目的別の再現可能な評価を探す出発点です。
「世界AIランキング1位」という文章だけを見てモデルを選ぶのではなく、評価方式、モデルバージョン、費用と遅延、自身の業務との類似性を一緒に確認する必要があります。
公開ランキングで候補を絞り込み、実際の業務データで小さな独自の評価を行うこと、これがAIモデルを最も安全かつ現実的に選択する方法です。
コメントを残す