在Kubernetes环境中稳定运行复杂的批处理作业、CI/CD流水线和数据处理工作流绝非易事。特别是应对意外故障、管理可重用模板以及控制同时执行的任务数量,这些都是必不可少的要素。
今天,我们将深入详细地探讨Argo Workflows的核心高级功能:Retry Strategy、WorkflowTemplateRef 和 Semaphore。通过本文,让您的工作流更上一层楼,变得“更健壮、更高效、更易管理”!🚀
大家好!Argo Workflows是一个强大的工具,它允许在Kubernetes上运行基于容器的工作流。然而,在实际的生产环境中,我们需要构建的不仅仅是简单的任务执行,而是“故障弹性强”、“可重用”和“资源高效”的工作流。
接下来10分钟,我们将详细了解Argo Workflows中能够帮助您实现这三个目标的核心功能。
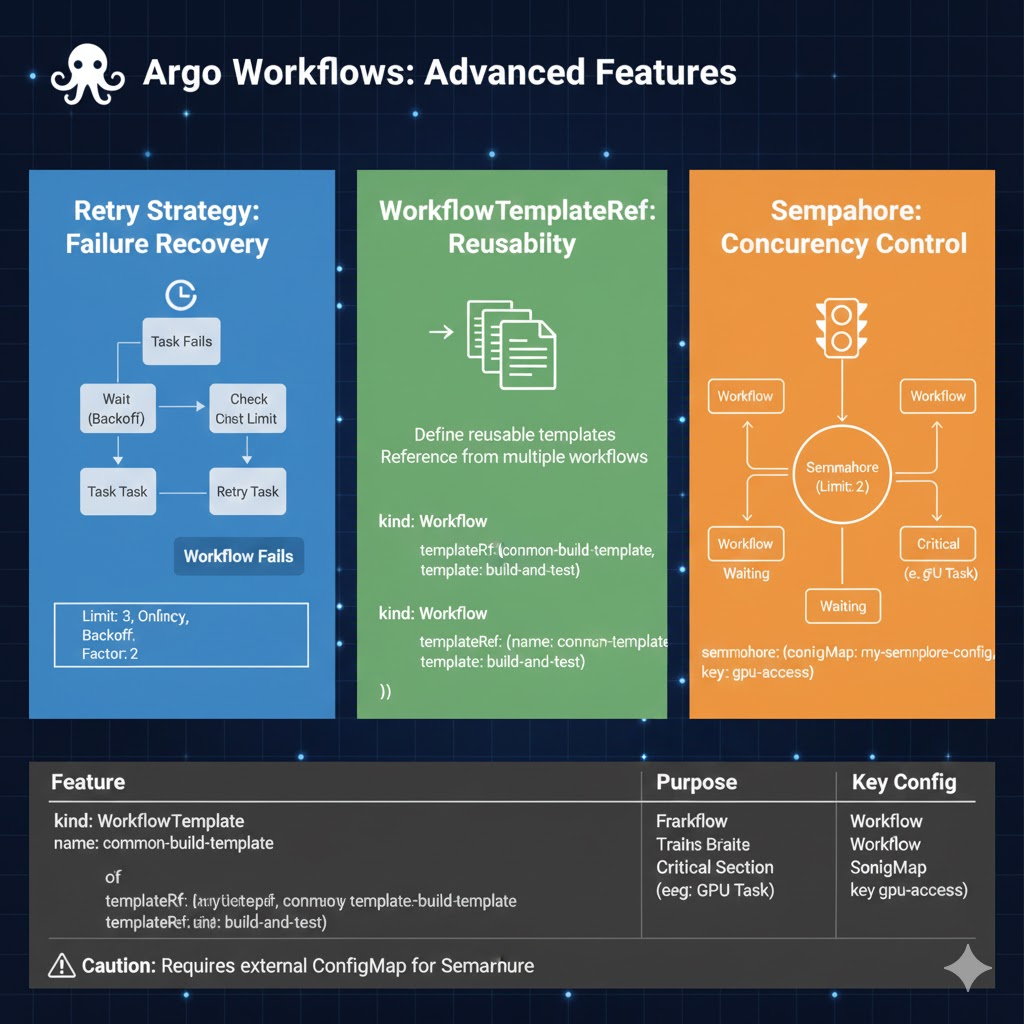
1. Retry Strategy: 构建故障弹性强的工作流 💪
当任务因网络不稳定、临时外部服务错误等意外原因失败时,盲目地重启整个工作流是低效的。retryStrategy可以在特定条件下自动重试任务,从而提高工作流的健壮性。
✅ 主要选项
- limit: 最大重试次数。
- retryPolicy: Always (总是重试), OnError (容器错误时), OnFailure (Pod失败时)。
- backoff: 重试间隔。duration (初始等待时间), factor (下次重试时等待时间增加的倍数), maxDuration (最大等待时间)。
📝 代码示例及说明
YAML
apiVersion: argoproj.io/v1alpha1
kind: Workflow
metadata:
  generateName: retry-example-
spec:
  entrypoint: main
  templates:
  - name: main
    steps:
    - - name: flaky-task # 假设一个有时会失败的任务
        template: unstable-operation

  - name: unstable-operation
    retryStrategy:
      limit: 3 # 最多重试3次
      retryPolicy: OnError # 如果容器返回非零错误代码则重试
      backoff:
        duration: "5s" # 首次重试前等待5秒
        factor: 2 # 下次等待时间从5秒 -> 10秒 -> 20秒递增
        maxDuration: "1m" # 最多等待1分钟(20秒后,最多等待1分钟)
    container:
      image: alpine:latest
      command: [sh, -c]
      args:
        # 50%概率失败的脚本
        - "echo 'Attempting operation...'; R=$((RANDOM % 2)); if [ $R -eq 0 ]; then echo 'Success!'; exit 0; else echo 'Failure!'; exit 1; fi"
2. WorkflowTemplateRef: 可重用的工作流库 📚
如果存在重复的工作流模式或常用任务组,可以将其定义为WorkflowTemplate,并在其他工作流中引用。这提高了代码的重用性,并降低了管理复杂性。
- 单一定义,多处使用: 一次定义的模板可以在多个工作流中像函数一样被调用。
- 参数传递: 在模板中定义参数,以便在调用时动态传递值。
- Namespace-scoped 或 Cluster-scoped: 模板可以配置为仅在特定命名空间中使用,或在整个集群中使用。
📝 代码示例及说明
① 定义 WorkflowTemplate (my-template.yaml)
YAML
apiVersion: argoproj.io/v1alpha1
kind: WorkflowTemplate # 与普通Workflow不同的kind!
metadata:
  name: common-build-template # 模板名称
  namespace: argo
spec:
  entrypoint: build-and-test
  templates:
  - name: build-and-test
    inputs:
      parameters:
      - name: git-url
      - name: commit-id
    container:
      image: docker:dind # Docker-in-Docker镜像使用示例
      command: [sh, -c]
      args:
        - |
          echo "Cloning {{inputs.parameters.git-url}} at {{inputs.parameters.commit-id}}"
          # 实际的构建/测试逻辑
          echo "Build successful!"
② 在 Workflow 中引用 WorkflowTemplate (my-workflow.yaml)
YAML
apiVersion: argoproj.io/v1alpha1
kind: Workflow
metadata:
  generateName: ci-pipeline-
spec:
  entrypoint: run-build
  templates:
  - name: run-build
    steps:
    - - name: app-build
        # 如何引用WorkflowTemplate
        templateRef:
          name: common-build-template # 要引用的WorkflowTemplate的名称
          template: build-and-test # 模板内的入口点
        arguments:
          parameters:
          - name: git-url
            value: https://github.com/my-org/my-app.git
          - name: commit-id
            value: a1b2c3d4e5
3. Semaphore: 资源并发控制 🚦
Semaphore是一种功能,用于在集群中特定资源(例如:GPU、特定外部API)有限时,控制同时使用该资源的工作流或任务的数量。它通过避免无限启动Pod来防止资源耗尽或外部服务过载。
✅ 主要特点
- 集群范围/命名空间范围: 通过
ClusterWorkflowTemplate或Workflow定义中的semaphore字段进行设置。 - 获取(Acquire)和释放(Release): 任务开始时获取Semaphore,完成后释放。
- 瓶颈管理: 当资源不足时,任务会进入等待状态,从而保持集群的稳定性。
📝 代码示例及说明
① 定义集群范围的 Semaphore (argocd-cm 或单独的 ConfigMap)
YAML
apiVersion: v1
kind: ConfigMap
metadata:
  name: my-semaphore-config
  namespace: argo
data:
  # 名为'gpu-access'的信号量最多允许2个工作流/任务同时执行
  semaphore.maxParallelism: "gpu-access:2"
② 在 Workflow 中使用 Semaphore
YAML
apiVersion: argoproj.io/v1alpha1
kind: Workflow
metadata:
  generateName: gpu-job-
spec:
  entrypoint: main
  templates:
  - name: main
    # 整个工作流使用'gpu-access'信号量。
    semaphore:
      # 上面定义的ConfigMap的名称和键
      configMap: my-semaphore-config
      key: gpu-access
    container:
      image: my-gpu-image:latest
      # 实际使用GPU资源的任务
      command: [python, "run_gpu_task.py"]
      resources:
        limits:
          nvidia.com/gpu: 1 # 请求1个GPU
💡 注意: semaphore的ConfigMap必须位于Argo Workflows控制器可访问的命名空间中。
4. 总结与实战应用指南 📊
| 功能 | 主要目的 | 何时使用? |
| — | — | — |
| Retry Strategy | 从瞬时故障中恢复 | 网络错误、外部API超时等非确定性故障 |
| WorkflowTemplateRef | 提高工作流重用性 | 通用构建逻辑、测试套件、数据预处理步骤 |
| Semaphore | 控制有限资源的并发性 | GPU、固定数量的外部API请求、数据库连接数等 |
—
🏁 结束语
Argo Workflows的retryStrategy、WorkflowTemplateRef和Semaphore分别是最大化故障恢复弹性、开发效率和资源管理效率的核心功能。通过适当地利用这些功能,您的工作流将能够更稳定、更灵活、更具成本效益地运行。
现在,基于这些知识,构建更强大的云原生工作流吧!🛠️
发表回复