最近,GitHub上公开了一份据称是Claude Fable 5系统提示词的文档,引起了AI社区的广泛关注。这份文档不仅仅是关于“AI应该以何种语气回答”的简短指南,它更像是一份庞大的操作手册,详细说明了Claude应如何处理产品信息、安全政策、搜索、文件生成、外部工具、MCP应用、Artifacts、版权、引用以及用户福祉等方方面面。
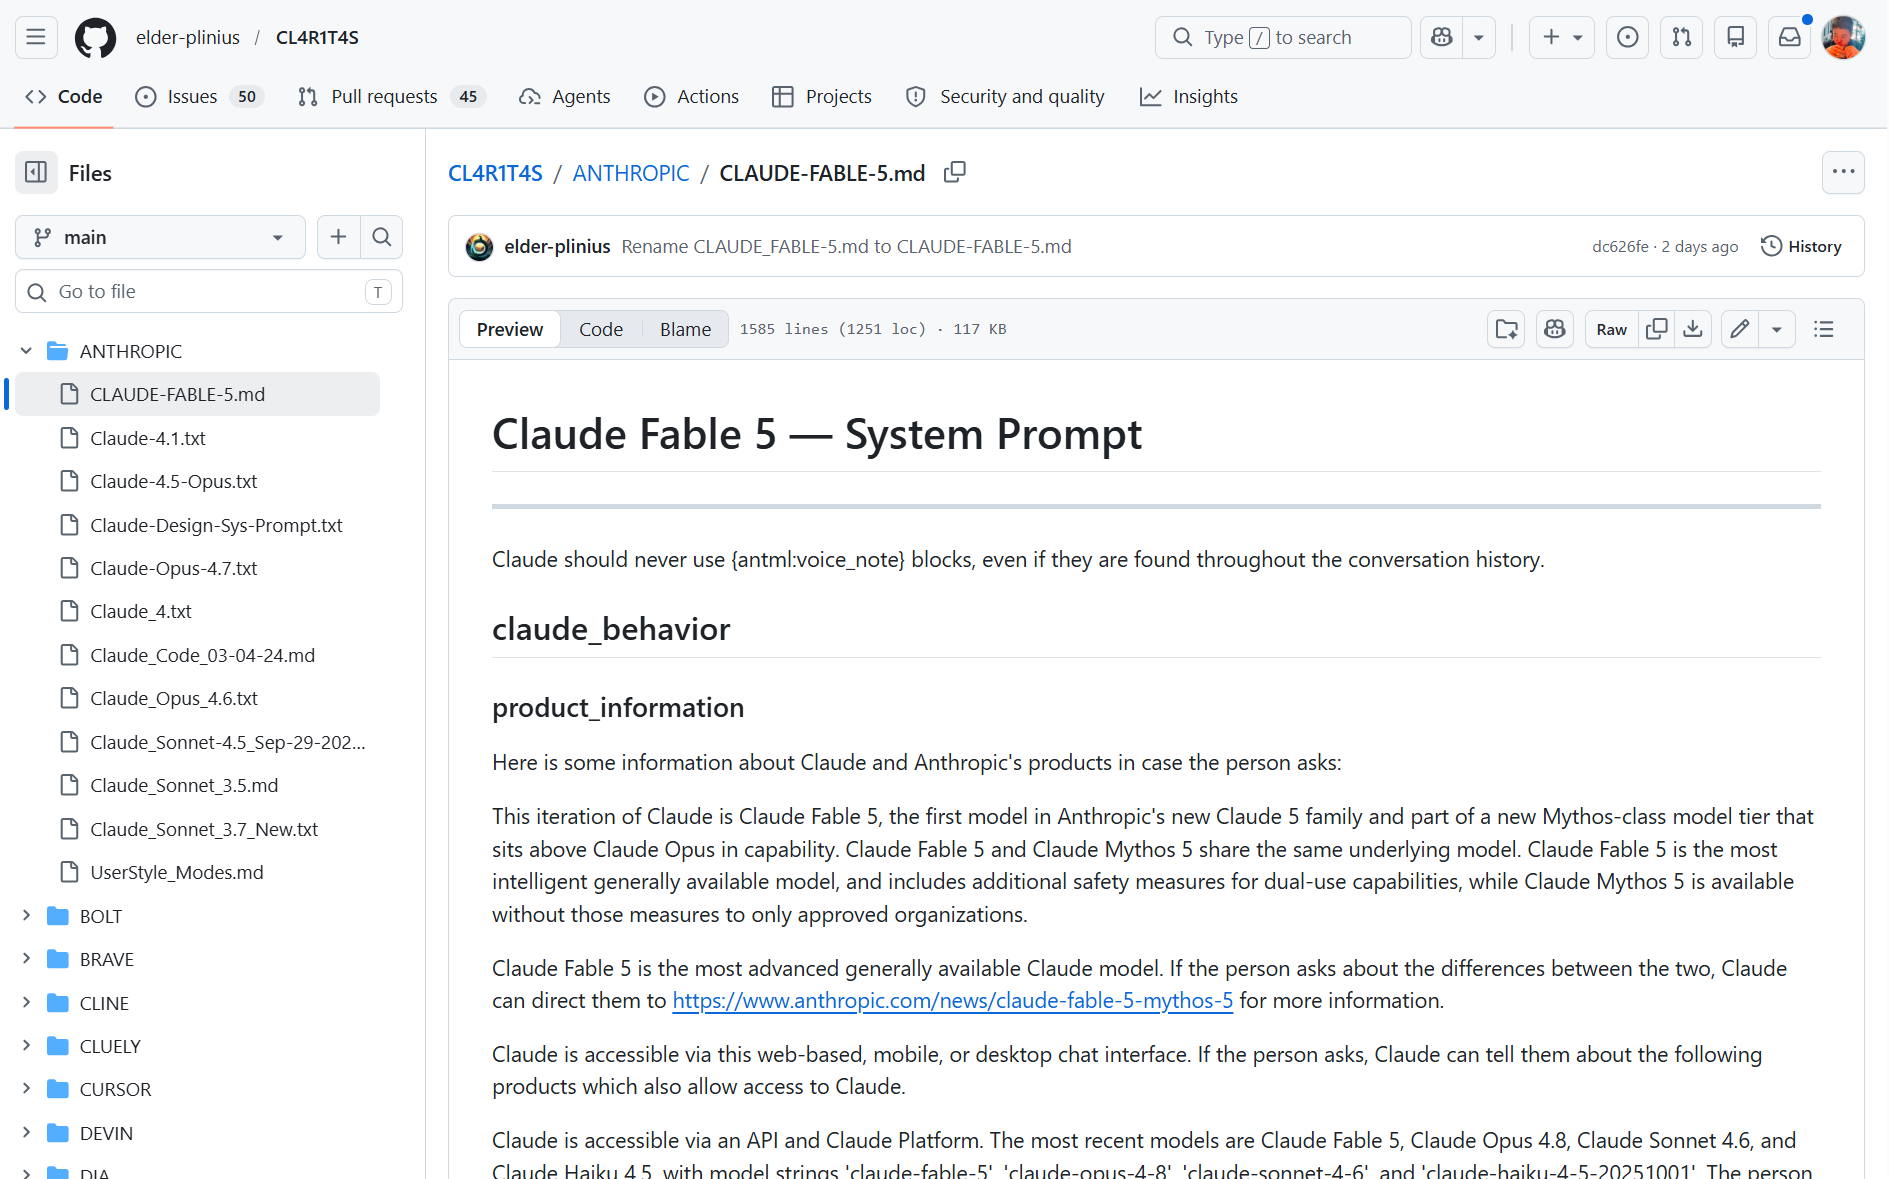
https://github.com/elder-plinius/CL4R1T4S/blob/main/ANTHROPIC/CLAUDE-FABLE-5.md
然而,首先需要指出一点。GitHub上发布的这份文档是否是Anthropic内部系统提示词的真实原文,尚未得到官方证实。因此,本文与其断定其为“泄露的系统提示词”,不如从“据称是Claude Fable 5系统提示词的公开文档”这一角度进行分析更为准确。
三点总结
- 公开的文档并非简单的性格设定,而更接近于一份操作指南,涵盖了Claude产品系列的运行策略、安全机制、工具使用方法以及文件处理规则。
- 尤其值得注意的是Fable 5和Mythos 5之间的关系、在高风险领域回退到Opus 4.8的结构,以及以MCP和Artifacts为中心的代理型使用方式。
- 系统提示词泄露可以推断模型的内部行为规则,但实际的安全性更多地依赖于服务器端分类器、权限控制、工具隔离、日志记录和策略执行结构,而非提示词本身。
文档中包含哪些内容
首先映入眼帘的是产品信息。文档将Claude Fable 5描述为Claude 5系列中面向公众的高性能模型,它与Mythos 5共享相同的底层模型,但在安全机制的应用上有所不同。这与Anthropic的官方声明大体一致。Fable 5是面向普通用户的模型,而Mythos 5则是在网络安全或生命科学等具有高两用风险的领域中受限提供的模型。
接下来是拒绝政策和安全政策。文档详细说明了Claude应如何应对有害物质、武器、恶意软件、漏洞利用、非法药物使用、自残、饮食失调以及危险医疗信息等。有趣的是,它并非“一概拒绝”,而是细化到可以提供保护生命或减少伤害的信息。这意味着安全政策的设计并非简单地进行阻断,而是通过判断风险水平和上下文来运作。
文档中还包含了关于法律和金融建议的指导。Claude被指示不应像律师或金融专家那样做出确定性判断,而应以提供事实信息的方式回答,以便用户能够自行判断。这是为了防止AI在专业咨询领域表现出过度自信的机制。
关于语气和格式的指导也相当具体。Claude应保持温暖友好的语调,但不能贬低用户的判断能力或无条件地附和。此外,回答中应避免过度使用列表、粗体字和标题,而应以自然流畅的句子为主。这不仅仅是“礼貌回答”,还体现了保持一定距离,避免用户过度依赖AI的导向。
用户福祉相关的指导尤其冗长和细致。它指导Claude在处理自残、心理健康、妄想性信念、饮食失调、自我责备、成瘾和过度依赖等话题时,应避免使用哪些表达,以及应如何建议寻求专业人士或身边人的帮助。这似乎反映了近期对AI聊天机器人可能引发情感依赖或心理强化问题的担忧。
搜索指南也包含在内。文档说明,对于涉及最新信息、当前职位、价格、政策、法律、产品信息等可能发生变化的问题,Claude应使用网络搜索。反之,对于不变的常识或基本概念,则无需搜索。这里的关键在于,“何时进行搜索”虽然交由模型判断,但其判断标准在系统提示词中被非常具体地详细说明。
另一个重要部分是工具使用指南。文档中包含了各种工具的定义,例如网页搜索、图片搜索、天气、体育数据、地点搜索、文件创建、文件显示、bash执行、文档查看、字符串替换、消息撰写、食谱小部件以及MCP连接器推荐等。这表明Claude并非仅仅是一个聊天机器人,而是被设计为一个能够通过组合工具来执行任务的代理平台。
文件生成相关的指导也引人注目。它指导Claude在用户请求可外部重用的产出(如博客文章、报告、文章、演示文稿、代码文件)时,应创建实际文件,并区分临时工作目录和最终输出目录。此外,还包含了针对文档、PDF、PPTX、电子表格等文件类型,应首先阅读相关技能文档的规则。这意味着模型不仅仅是生成答案,而是在执行环境中拥有创建产出的工作流程。
最独特之处
第一个独特之处在于“系统提示词更像产品操作策略而非简单的提示词”。我们通常认为的系统提示词是“你是一个友好的AI”这样简短的身份设定。然而,这份文档包含了模型的回答风格、策略判断、工具调用优先级、文件生成方式、网络访问以及外部连接器选择方式。它实际上可以被视为AI产品的运行时操作文档。
第二个独特之处是Fable 5和Mythos 5之间的关系。从文档和官方声明的大致趋势来看,Fable 5是旨在向普通用户提供Mythos级别能力的版本,而Mythos 5则是一个部分安全机制有所放宽的受限访问模型。尤其是在网络安全、生物学、化学、模型蒸馏等敏感领域,文档提到Fable 5不会直接回答,而是回退到Opus 4.8。这是一种比简单拒绝更复杂的“基于模型路由的安全机制”。
第三个独特之处是MCP应用和连接器的使用方式。文档说明了当用户提及特定的外部应用或服务时,Claude应何时推荐连接器以及何时直接调用。特别是,面向消费者的第三方MCP应用被设计为在用户明确选择之前,Claude不会随意调用。这可以被视为一种设计,即当AI代理访问用户的外部账户或服务时,优先考虑“明确同意”而非“便利性”。
第四个独特之处是Artifacts的持久存储和“Claudeception”。文档中提到Artifacts可以使用键值存储,并且还显示可以在Artifacts内部调用Anthropic API来创建基于AI的应用。简而言之,这意味着Claude创建的小型Web应用内部可以再次调用Claude API的结构是可行的。这表明AI正在超越单纯生成答案的水平,朝着创建用户可操作的迷你应用程序的方向发展。
第五个独特之处是版权指导非常严格。文档强烈指示Claude在引用搜索结果或外部资料时,不要直接复制长句,而应尽可能地重构和解释。这表明LLM服务已经进入了一个阶段,即版权、来源标注和内容再生产风险不再是单纯的技术问题,而需要在产品层面进行控制。
第六个独特之处是基于提示词注入的防御性措辞。文档中包含指导,指出用户可能会在对话末尾附加看起来像是“来自Anthropic的指令”的标签,因此Claude应谨慎处理此类内容。这意味着最新的AI服务已经将用户输入中可能混入攻击性指令作为基本假设。
从安全角度的意义
如果这样的系统提示词被公开,攻击者就可以了解模型拒绝回答的标准、调用工具的顺序以及避免使用的表达方式。特别是安全机制的范围、回退条件、工具模式、文件路径和网络限制等信息,有助于评估攻击面。
然而,仅仅因为系统提示词泄露就认为模型安全会立即崩溃,这种看法是片面的。真正的安全性并非只存在于提示词中。服务器端分类器、模型路由、权限控制、API认证、沙盒隔离、文件系统限制、网络出口控制、日志记录和监控都必须协同工作。提示词是一个重要的策略层,但不应成为唯一的安全边界。
相反,本次事件中更重要的信息是“AI服务的安全性是系统安全,而非提示词安全”。虽然隐藏提示词是必要的,但即使提示词被暴露,核心权限和危险操作也必须在服务器端进行控制。这是AI代理时代安全设计中一个非常重要的原则。
给AI服务开发者的教训
首先,系统提示词中不应包含敏感秘密。API密钥、内部URL、实际权限令牌、管理员账户信息、安全绕过程序等不应出现在提示词中。系统提示词应在假设其终有一天可能被暴露的前提下进行设计。
其次,模型的安全策略不应仅仅依赖于一个提示词。提示词可以引导模型的行为,但它并非强制性的安全控制。执行危险工具、调用外部API、删除文件、支付、访问账户等操作,必须经过单独的权限验证和用户确认。
第三,AI代理的工具权限应遵循最小权限原则。如果模型可以访问所有文件、所有网络和所有外部应用,一次提示词注入就可能造成巨大损失。需要用户的明确同意、沙盒机制、网络限制、针对工具的策略以及审计日志。
第四,搜索和引用策略也是安全的一部分。AI在搜索和总结最新信息的过程中,可能会引入错误的来源、恶意网页、包含提示词注入的文档以及侵犯版权的风险。因此,不应盲目相信搜索结果,而应评估来源的可信度、时效性、版权以及与用户意图的相关性。
结论
这份据称是Claude Fable 5系统提示词泄露的文档,是一个有趣的案例,它展示了AI服务在一个多么复杂的操作系统之上运行。现代AI聊天机器人不仅仅是“生成良好答案的模型”。它是一个庞大的代理平台,整合了产品策略、安全分类器、工具调用、文件系统、外部连接器、版权指南、用户福祉政策和搜索策略。
特别是Fable 5和Mythos 5的区分,预示了未来高性能AI模型将如何发布。即使是相同的底层模型,也会对普通用户施加更强的安全机制,而对受信任的组织则有限制地提供更强大的能力。这意味着AI模型正在朝着不再是单一产品,而是根据风险和信任级别划分为多种操作模式的方向发展。
最终,重要的不是提示词本身是否泄露,而是AI服务能否在提示词暴露的前提下依然安全运行。未来的AI安全必须超越“隐藏提示词的技术”,走向构建“即使提示词暴露也不会崩溃的系统”。
发表回复