Attention是一种计算Query和Key之间相关性分数,然后根据这些比例混合Value的操作。创建Q、K、V的线性层不仅可以包含权重,还可以包含bias,即独立于输入添加的可学习向量。
给Q添加bias和给所有K添加相同的bias看起来相似,但在基本的点积Attention中,它们对softmax的影响是不同的。共同的K bias会将一个Query的所有分数平移相同的量,而Q bias可以根据Key添加不同的值。 softmax会消除前者的共同平移,但会反映后者的相对差异。
继Q·K·V和KV Cache解释之后,本文将通过公式和小数字来验证这一差异。这不是运行实际LLM或PyTorch模型的结果,而是针对没有位置转换的基本Scaled Dot-Product Attention。
这是AI生成的概念图。不代表实际屏幕或测量结果。
1. 首先区分bias是加到什么上的
当token的当前表示为x时,用于解释的Q和K如下:
qᵢ = xᵢWQ + bQ
kⱼ = xⱼWK + bKbQ和bK分别加到投影结果向量上。条件是,在同一个Head中,通过相同K线性层的token会接收到相同的bK。PyTorch的Linear也被描述为一个对输入应用权重转换并添加bias的层。根据矩阵存储方向,文档中的转置表示可能不同,但向向量添加共同bias这一点是相同的。 PyTorch Linear
这与计算Q和K的点积之后添加到分数矩阵的attention bias是不同的。掩码或相对位置分数可以稍后添加到分数矩阵中,不能仅仅因为名称中包含“bias”就将其归为同一项。
基本计算如下:
sᵢⱼ = qᵢ · kⱼ / √dₖ
pᵢⱼ = exp(sᵢⱼ) / Σⱼ exp(sᵢⱼ)
출력ᵢ = Σⱼ pᵢⱼ vⱼdₖ是Key向量的维度。softmax对单个Query的分数行进行归一化。因此,“常数”一词并非指整个矩阵中的相同数字,而是指在固定Query的一行中,不随Key变化的数字。 Attention Is All You Need, 3.2.1
2. 给所有K添加相同的向量会保持分数差异
我们将添加bias之前的Key记为kⱼ⁰。如果Query qᵢ固定,则以下等式成立:
qᵢ · (kⱼ⁰ + bK) / √dₖ
= qᵢ · kⱼ⁰ / √dₖ + qᵢ · bK / √dₖ后面的qᵢ · bK / √dₖ不包含Key位置j。因此,同一行中的所有分数都加上相同的cᵢ。两个Key之间的差异保持不变。
(s₁ + c) - (s₂ + c) = s₁ - s₂在softmax中,相同的项也会被抵消。
exp(sⱼ + c) / Σₜ exp(sₜ + c)
= exp(c)exp(sⱼ) / [exp(c)Σₜ exp(sₜ)]
= exp(sⱼ) / Σₜ exp(sₜ)由此得出的结论是,在给定的基本计算中,即使只改变共同的K bias,softmax权重也保持不变。这并不意味着分数本身相同。如果Query改变,cᵢ也可能改变,但作为每行中共同平移的性质保持不变。
3. Q bias可以为每个Key创建不同的分数变化
如果我们将添加bias之前的Query记为qᵢ⁰,则如下所示:
(qᵢ⁰ + bQ) · kⱼ⁰ / √dₖ
= qᵢ⁰ · kⱼ⁰ / √dₖ + bQ · kⱼ⁰ / √dₖ后面的项会根据kⱼ⁰而变化。即使给Q添加了相同的向量,当它与不同的Key进行点积时,每个分数的改变不一定相同。这就是与共同K bias的区别。
如果Q和K都包含bias,点积可以分为四项:
(qᵢ⁰ + bQ) · (kⱼ⁰ + bK)
= qᵢ⁰·kⱼ⁰ + bQ·kⱼ⁰ + qᵢ⁰·bK + bQ·bKqᵢ⁰·bK和bQ·bK在同一行中不随Key变化。可能影响相对分数的附加项是bQ·kⱼ⁰。除以尺度√dₖ也不会改变这种区分。
然而,Q bias并非总是改变权重。如果bQ为0,或者它与所有允许的Key的点积都相同,则附加项也成为共同平移。准确的表述是“Q bias可以改变Key之间的相对分数”。
相对分数的变化通过两个Key的差异来解读
由于Q bias导致的第一和第二Key之间产生的额外分数差异是bQ · (k₁⁰ − k₂⁰) / √dₖ。如果此值为0,则这两个Key的相对分数保持不变;如果非0,则它们的相对权重可能会改变。与其说“Q bias已添加”,不如将其与要比较的Key的差异进行点积,这样更准确。
从基本的softmax比例也可以得出相同的结论。如果两个权重都是从有限分数计算得出的,那么p₁ / p₂ = exp(s₁ − s₂)。给所有分数添加相同的数字会保持差异,而为每个Key添加不同的值则会改变差异。后面的数字表直接验证了这种关系。
4. 直接用2D向量进行验证
现在我们使用小的合成数值。
q  = (1, 0)
k₁ = (1, 0), k₂ = (0, 1), k₃ = (-1, 0)
bQ = (0, 1)
bK = (3, -2)
dₖ = 2
添加Q bias后,Query变为(1, 1)。第一和第二Key的分数变得相同,第三Key保持较低分数。共同的K bias在与Query (1, 0)进行点积时,会给所有分数添加3/√2,约2.121320。
以下是使用Python标准库计算的实际结果,四舍五入到小数点后六位。
| 条件 | softmax前分数 (s₁, s₂, s₃) |
softmax权重 (p₁, p₂, p₃) |
|---|---|---|
| 无bias | (0.707107, 0, -0.707107) |
(0.575975, 0.283995, 0.140029) |
| 仅添加Q bias | (0.707107, 0.707107, -0.707107) |
(0.445808, 0.445808, 0.108383) |
| 仅添加共同K bias | (2.828427, 2.121320, 1.414214) |
(0.575975, 0.283995, 0.140029) |
| Q·K bias都添加 | (1.414214, 1.414214, 0) |
(0.445808, 0.445808, 0.108383) |
第一行和第三行的分数不同,但权重相同。第二行和第四行也具有相同的关系。仅仅存在共同的K bias并没有改变哪个Value获得更多权重。在这种条件下,混合固定V的输出也是用相同的权重计算的。
数值计算使用了减去最大分数的softmax。这也是利用相同的共同平移不变性来避免大指数值的方法。
def softmax(xs):
    peak = max(xs)
    exps = [math.exp(x - peak) for x in xs]
return [x / sum(exps) for x in exps]运行附件中的verify_attention_bias.py会将输入、分数和权重保存到results.json中。
python3 verify_attention_bias.py --output results.json在Python 3.9.6中,所有8项验证均通过。我们确认了基本分数、K的共同平移、softmax的保持、Q的相对分数变化以及两者相加的结果。它还包括其他Query行、Q bias无效的例外情况,以及token之间不同的K平移超出共同平移条件的反例。允许的比较误差,相对误差和绝对误差均为1e-12,上述合成数值中基本权重和K bias权重的最大差异实际上为0.0。
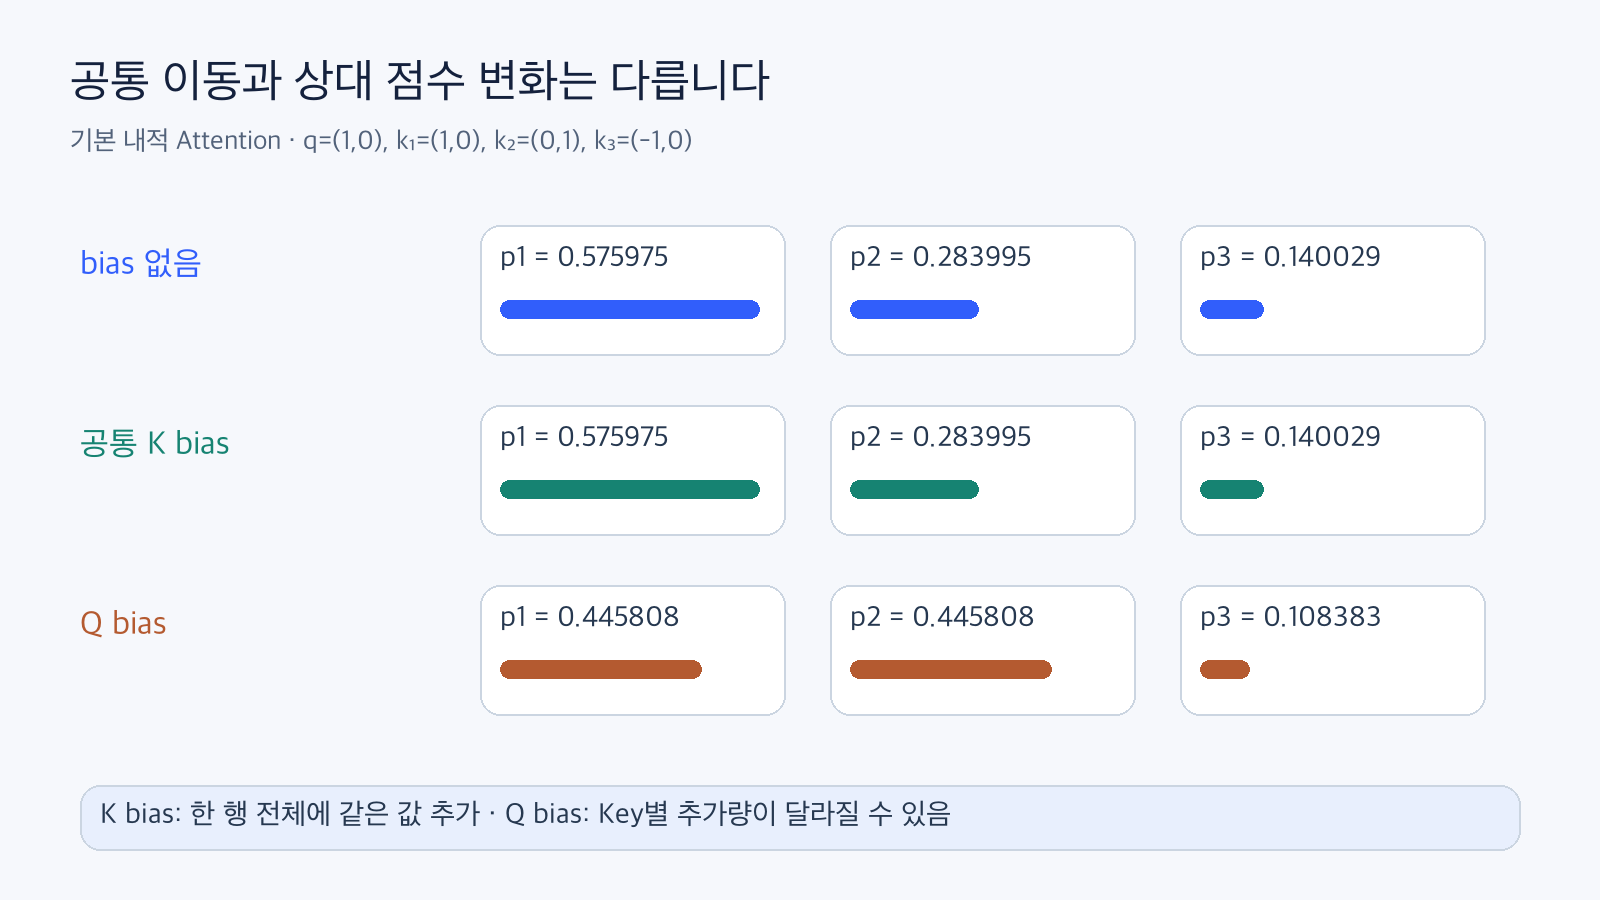
图:正文中合成数值的softmax权重比较。基于官方文档重构,并非实际模型的性能测量。 官方依据1 · 官方依据2
5. 遵守此结论的适用边界
本次验证是在单个Head中,对相同维度的Query和Key进行点积,然后将相同的bK添加到所有Key之后,计算行级softmax。未测量dropout、量化、GPU内核或模型训练结果。实数的数学不变性与浮点实现中的误差也必须区分开来。
特别是,此结论不直接扩展到RoPE(旋转位置嵌入),即根据位置旋转Q·K向量。如果配置是在添加共同bias后,在每个位置进行不同的旋转,则需要重新计算旋转后的附加项是否仍然对所有Key共同。RoPE论文解释了如何通过旋转矩阵反映位置。本次代码不包含该操作,也不对RoPE模型进行判断。 RoFormer论文
Key特定的附加向量、Q·K归一化等其他转换,以及分数阶段的相对位置项,也需要检查其应用点和公式。即使在PyTorch的Attention示例中,QK点积、添加到分数的项、softmax、dropout和与V的乘法也是不同的阶段。 PyTorch Scaled Dot-Product Attention
此计算不应被解释为“所有Transformer都可以移除K bias”的模型更改建议。所确认的结论是有限公式的性质。与其关注向量中添加了什么,不如观察最终分数行中Key之间的差异是否改变,这样可以区分Q和K bias的效果。
发表回复