大家好!今天我想和大家聊一个可能每个开发者都曾思考过的话题:日志与个人信息。
您是否为了服务故障分析或用户行为追踪,而将user_id等信息直接存储在OpenTelemetry Span中?🕵️♂️
如果是这样,您现在必须立即停止!🚨 这是一种非常危险的做法,极有可能违反GDPR、CCPA等全球性的个人信息保护法规。如果用户的敏感信息泄露,不仅会损害企业信誉,还可能引发法律问题。
然而,完全不追踪用户相关信息也是不现实的。有时,我们需要查找只针对特定用户出现的bug,或者分析用户专属体验。
因此,我们为您准备了这份指南。我们将从A到Z告诉您如何在OpenTelemetry环境中安全、智能地处理user_id等敏感信息!
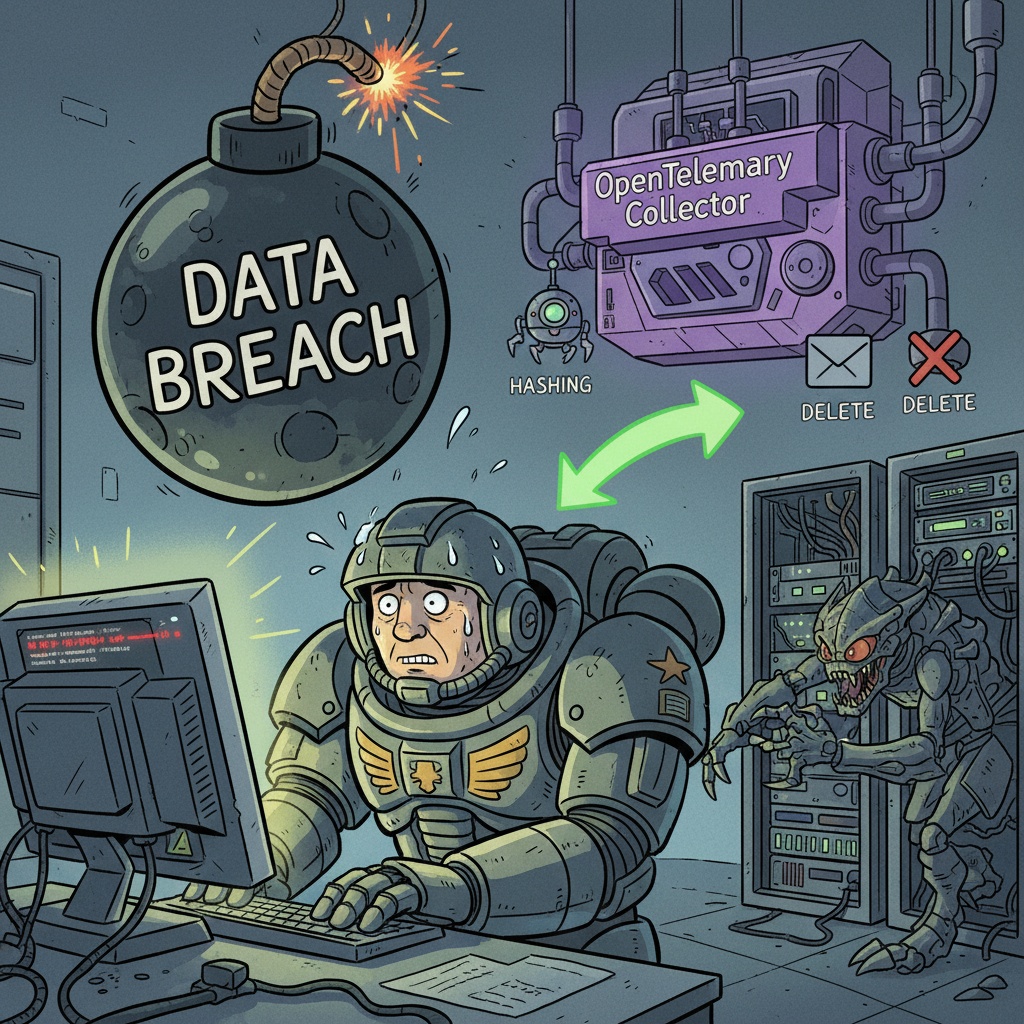
首先,了解全局概览 🗺️
在探讨具体的解决方案之前,理解整体流程至关重要。我们面临两个选择:
- 在应用程序中直接处理: 这种方式是在每个服务(应用程序)的代码层面,对敏感信息进行加密或转换后,再记录到Span中。
- 集中统一处理: 应用程序将敏感信息原样发送,数据收集器(OpenTelemetry Collector)根据策略进行统一处理。
哪种方式更好呢?直接告诉您答案:从长远来看,集中处理方式效率更高,也更安全。 接下来,我们将逐一探讨具体方法,并解释其原因。
解决方案1:最简单快捷的方案,哈希 (Hashing) 🛡️
首先想到且可以立即应用的方法是哈希 (Hashing)。即将user_id通过SHA-256等单向哈希函数进行转换后存储。
👍 优点:
- 安全性: 仅凭哈希值无法反向推导出原始user_id,因此是安全的。
- 可追溯性: 相同的user_id总是生成相同的哈希值。因此,搜索和追踪与特定用户相关的所有Span都没有问题。
👎 缺点:
- 需要在所有应用程序代码中添加哈希逻辑。
- 如果哈希策略后续发生变化(例如:SHA-256 -> SHA-512),则需要修改并重新部署所有服务的代码,这会带来不便。
💻 应用方法 (Python示例):
在应用程序代码中设置Span属性(attribute)之前,直接对user_id进行哈希处理。
import hashlib
from opentelemetry import trace

tracer = trace.get_tracer(__name__)

def process_user_request(user_id: str, item_id: str):
    with tracer.start_as_current_span("process_request") as span:
        # ❌ 绝不能这样使用!
        # span.set_attribute("user.id", user_id)

        # ✅ 对user_id进行哈希处理以安全存储。
        hashed_user_id = hashlib.sha256(user_id.encode()).hexdigest()

        # 最好在属性名后添加.hashed以明确表示这是一个哈希值。
        span.set_attribute("user.id.hashed", hashed_user_id)

        # 非敏感信息可以直接存储。
        span.set_attribute("item.id", item_id)

        # ... 业务逻辑处理 ...
解决方案2:终极解决方案(强烈推荐),OpenTelemetry Collector 👑
更优雅、更系统化的方法是利用OpenTelemetry Collector。这种架构在MSA(微服务架构)环境中尤其出色。
🤔 它是如何工作的?
- 应用程序将user_id以明文形式发送给Collector。(无需修改代码!)
- Collector集中接收这些数据后,在发送到最终目的地(Jaeger、Prometheus等)之前,根据预定义的规则对数据进行加工。
- 在此过程中,它可以找到user.id属性并进行哈希处理,或者直接删除像user.email这样更敏感的信息。
👍 优点:
- 代码整洁性: 应用程序代码中不混入敏感信息处理逻辑,开发人员可以专注于业务逻辑。
- 集中管理: 所有服务的敏感信息处理策略可以通过一个Collector配置文件进行管理,非常容易保持一致性。
- 灵活性: 即使策略发生变化,也无需重新部署应用程序,只需修改Collector配置即可。
💻 应用方法 (Collector配置示例):
在OpenTelemetry Collector的config.yaml文件中添加attributes处理器,以配置其对特定属性进行哈希或删除。
# config.yaml

receivers:
  otlp:
    protocols:
      grpc:

processors:
  batch:
  # 使用attributes处理器处理属性。
  attributes:
    actions:
      # 查找键为"user.id"的属性并使用SHA256进行哈希处理。
      - key: user.id
        action: hash
      # 完全删除像"user.email"这样更敏感的信息。
      - key: user.email
        action: delete

exporters:
  otlp:
    endpoint: "otel-backend:4317"

service:
  pipelines:
    traces:
      receivers: [otlp]
      # 在receivers和exporters之间插入处理器。
      processors: [batch, attributes]
      exporters: [otlp]
现在,应用程序可以放心地编写如下代码:
# 在应用程序中,直接放入原始值。
span.set_attribute("user.id", "some_user_123")
span.set_attribute("user.email", "sensitive@email.com")
即使执行上述代码,经过Collector处理后,user.id也会变为哈希值,user.email会被删除,然后存储到最终的后端系统中。是不是非常简洁?✨
还有其他方法吗? 🤔
当然,也存在其他方法。
- 假名化 (Pseudonymization) / 令牌化 (Tokenization): 这种方法将user_id替换为完全没有意义的其他值(令牌)。它与哈希类似,但不同之处在于,可以通过单独的安全系统(在严格授权下)再次查询原始ID。当需要更复杂的系统和更高水平的合规性时使用。
- 排除 (Exclusion): 这是最简单也最确定的方法。如果user_id在调试或分析中并非必需,那么从一开始就不将其包含在Span中是最佳选择。可以考虑使用非敏感的唯一标识符,例如业务事务ID或请求ID。
❌ 绝不能!为什么不能直接存储原始值
您可能会想:“我们公司规模小,没关系”,“这只是内部系统查看,有什么大不了的”。但这种麻痹大意的想法可能导致重大事故。
- 安全事故: 如果监控系统的访问权限被窃取,或者日志数据库泄露,会发生什么?客户的个人信息将原样暴露,这将是可怕的局面。
- 法律责任: GDPR等法规非常严格。违反规定可能会被处以难以想象的罚款,这对公司来说可能是致命的打击。
- 信任下降: 数据泄露事故会瞬间让用户失去信任。
处理敏感信息不是选择,而是必须。
核心总结与最终建议 🚀
好了,现在我们来总结一下吧!
- 🥇 最佳实践 (Best Practice): 引入OpenTelemetry Collector。使用attributes处理器在中央对敏感信息进行哈希 (hash)或删除 (delete),这是在可扩展性和可维护性方面最优秀的架构。
- 🥈 次优方案 (Alternative): 如果难以引入Collector,则在应用程序代码中直接对敏感信息进行哈希处理并将其设置为属性。此时,最好在属性名称后添加.hashed,例如user.id.hashed,以明确表示这是哈希值,避免其他开发人员混淆。
- ⛔️ 绝对要避免的: 在任何情况下都不要将原始user_id原样存储在Span属性中。这已是一个无需讨论的问题。
今天就开始迈出第一步,安全地保护您的服务和客户信息吧!
发表回复