即使AI应用程序最初只调用一个OpenAI API,一旦进入运营阶段,情况就会发生变化。每个部门可能需要同时使用Anthropic、Gemini、AWS Bedrock、Azure OpenAI和内部GPU模型,在提供商故障时需要切换到替代模型,并且还需要管理每个用户的成本和数据导出策略。
如果每个应用程序都直接实现这些功能,认证密钥和重试代码将分散在各个服务中,并且每次更换模型时都需要重新编写请求格式和错误处理。AI网关是位于应用程序和多个模型提供商之间的中间层,它将模型调用汇聚到一个统一的策略和观测点。
本文将探讨AI网关与普通API网关有何不同,内部实际传输哪些协议和数据,以及在LiteLLM、Envoy AI Gateway、Kong、Apache APISIX、Higress和Portkey中应选择哪一个。最后,我们还将明确回答“谁是AI网关的事实标准?”这个问题。
先说结论:没有单一产品是事实标准
截至2026年8月,AI网关市场没有一个单一的官方标准或产品占据主导地位。相反,通过分层,答案会变得清晰。
| 问题 | 目前最接近的答案 | 注意事项 |
| — | — | — |
| 应用程序使用哪种调用格式 | OpenAI兼容HTTP/JSON API | 不是IETF或CNCF标准,而是广泛采用的事实接口惯例 |
| 通用多提供商OSS网关的代表是 | LiteLLM Proxy | 功能范围和生态系统广泛,但需确认OSS与商业功能的界限 |
| Kubernetes的自托管推理路由标准是 | Gateway API Inference Extension | 侧重于优化集群内部GPU推理,而非集成外部SaaS模型 |
| 基于Kubernetes·Envoy的AI网关实现是 | Envoy AI Gateway | 一个快速成熟的项目,但并非通用市场的唯一赢家 |
| 现有企业API管理的扩展选项是 | Kong, Apache APISIX, Higress | 取决于组织已使用的网关和所需的AI插件 |
因此,一句话总结如下:
接口的事实标准是OpenAI兼容API,而最接近通用开源实现事实标准的项目是LiteLLM。然而,在Kubernetes内部推理路由中,Gateway API Inference Extension和Envoy系列正在形成独立的标准轴。
GitHub Star并不能证明安装数量或质量,但可以作为衡量生态系统关注度的辅助指标。LiteLLM官方仓库目前宣称其网关支持以OpenAI或原生格式调用100多个LLM API,拥有超过5万颗星和活跃的发布。由于其通用性,它成为新AI平台在构建多模型入口点时首批考虑的OSS之一。然而,这一评估是基于采纳和兼容性的实际判断,而非“官方标准”的含义。
AI网关究竟做什么?
普通API网关也执行TLS终止、认证、速率限制、路由和日志记录。AI网关在此基础上增加了理解模型调用语义的功能。
- 解析
model、messages、input、tools、stream等LLM请求字段 - 将OpenAI格式转换为Anthropic Messages、Gemini、Bedrock等提供商特定格式
- 基于模型名称、成本、延迟、故障状态和数据等级进行路由
- 按令牌使用量、模型单价和用户·项目汇总预算
- 处理长流式连接和提供商特定的错误·重试
- 关联Prompt·Response的个人信息、违禁内容和Prompt Injection检查
- 相同·相似Prompt缓存和语义缓存
- 根据Tool Call、Embedding、图像·语音等模型功能应用策略
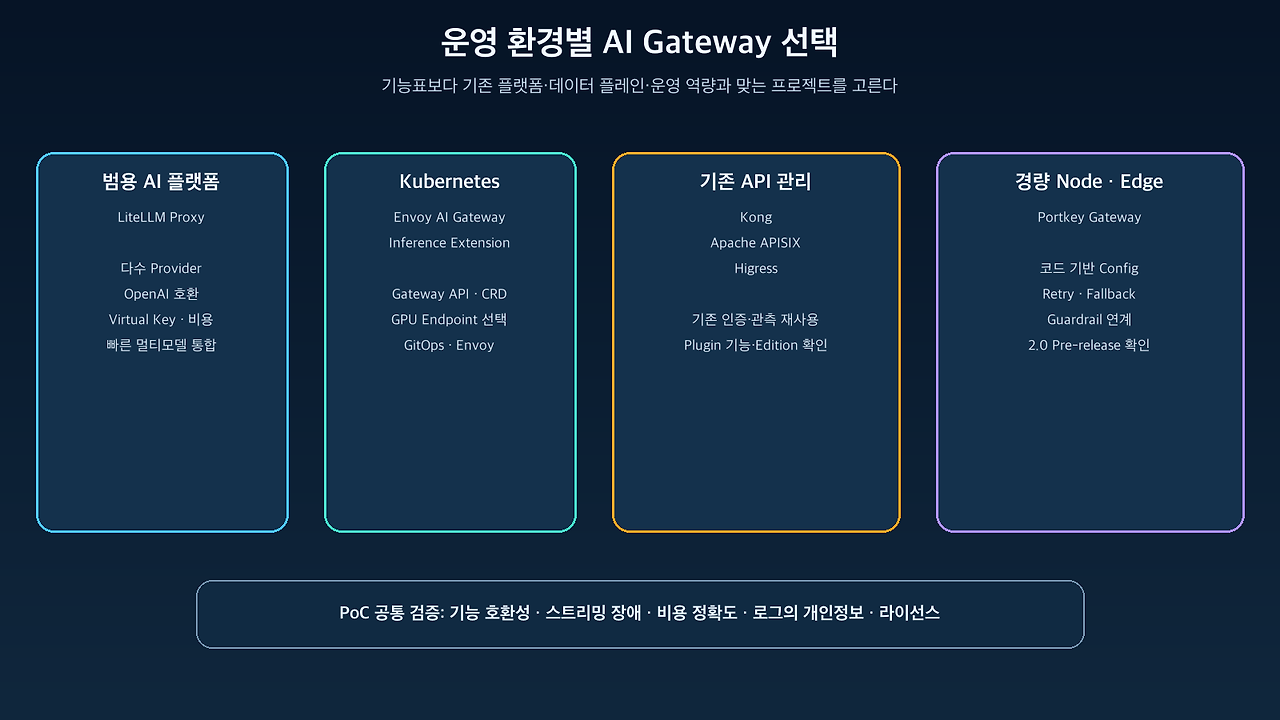
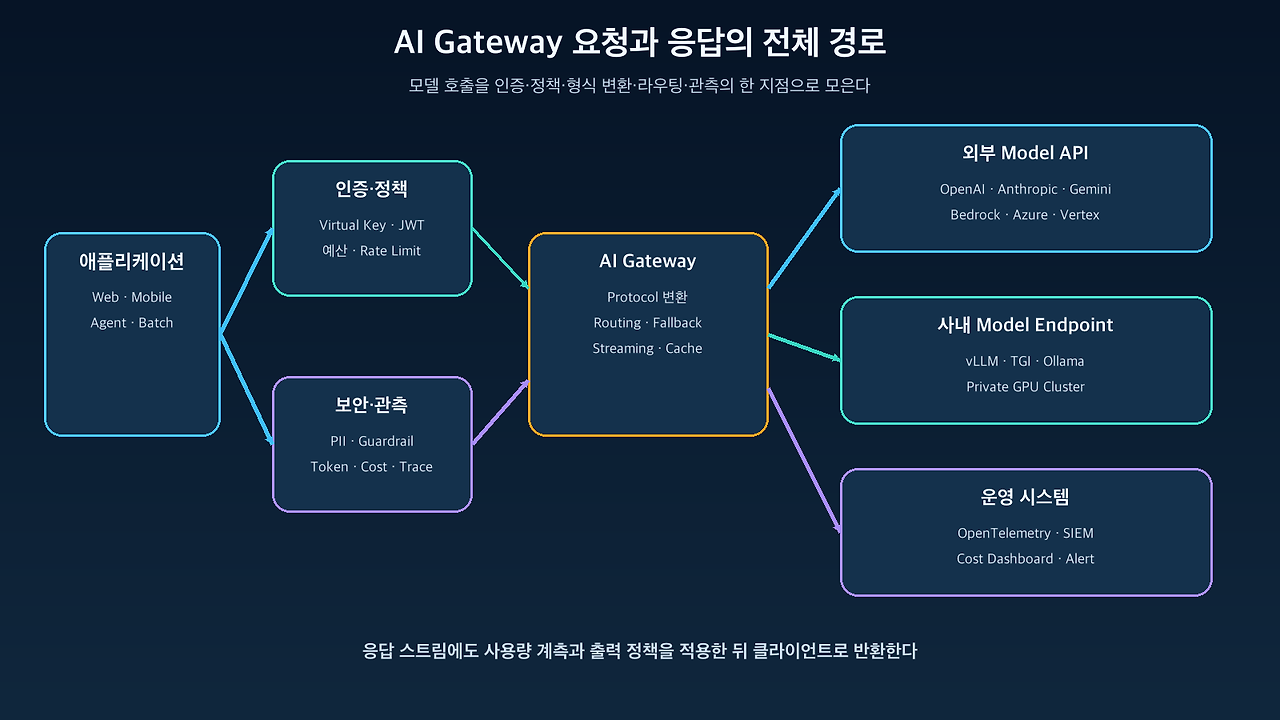
图:AI网关的典型请求·响应路径 · 基于LiteLLM、Kong AI Gateway、Envoy AI Gateway官方文档重构
当请求进入时,网关首先验证用户的虚拟密钥或JWT,并检查租户、预算和模型允许列表。然后,它将通用请求转换为目标提供商的格式和认证方式,并转发到适当的模型或部署。在响应中,它记录令牌使用量和延迟,并在必要时应用输出护栏,然后将流返回给客户端。
核心并非“多加一个代理”。而是将分散在应用程序中的模型特定访问代码和操作策略提升到中央的模型访问层。
使用HTTP吗?内部数据格式是什么?
大多数AI网关的外部接口使用HTTPS上的REST风格API,并在Body中放置JSON。流式输出通常使用Server-Sent Events,即SSE。OpenAI Responses API在stream=true时也会返回SSE事件。
典型的请求示例如下:
POST /v1/chat/completions HTTP/1.1
Authorization: Bearer virtual-key
Content-Type: application/json

{
  "model": "customer-support-model",
  "messages": [
    {"role": "user", "content": "환불 정책을 알려줘"}
  ],
  "stream": true
}这里的customer-support-model可能不是实际提供商的模型名称。它可以作为网关内部的逻辑模型名称,并连接到多个部署,如下所示:
customer-support-model
├─ 70% → Azure OpenAI 배포 A
├─ 20% → AWS Bedrock 모델 B
└─ 장애 시 → 사내 vLLM 모델 C
当网关向提供商发出请求时,即使同样是HTTP/JSON,URL、Header和Body Schema也会有所不同。AWS Bedrock可能需要SigV4认证,Anthropic使用其Messages API的字段和Header,而Gemini使用其自己的generateContent结构。网关负责翻译这些差异。
OpenAI兼容是标准规范吗?
不是。尽管POST /v1/chat/completions、messages、tools、stream等结构已广泛实现,成为事实上的通用语言,但它们并非由IETF RFC、W3C或CNCF管理的独立标准。它们是其他项目对OpenAI产品API契约的兼容实现。
此外,即使标有“OpenAI compatible”,兼容范围也各不相同。
- 可能只支持Chat Completions,不支持Responses API
- Tool Call的并行执行或Structured Output可能不同
- 图像·语音·Batch·Embedding Endpoint的支持范围不同
- SSE Event名称和终止方式可能不同
- Prompt Cache、Reasoning Token和Usage字段可能缺失
- 提供商特有功能可能无法用通用Schema表达
因此,兼容性应通过Endpoint × 模型 × 功能 × 流式传输 × 错误处理的组合进行测试,而不仅仅是一个复选框。
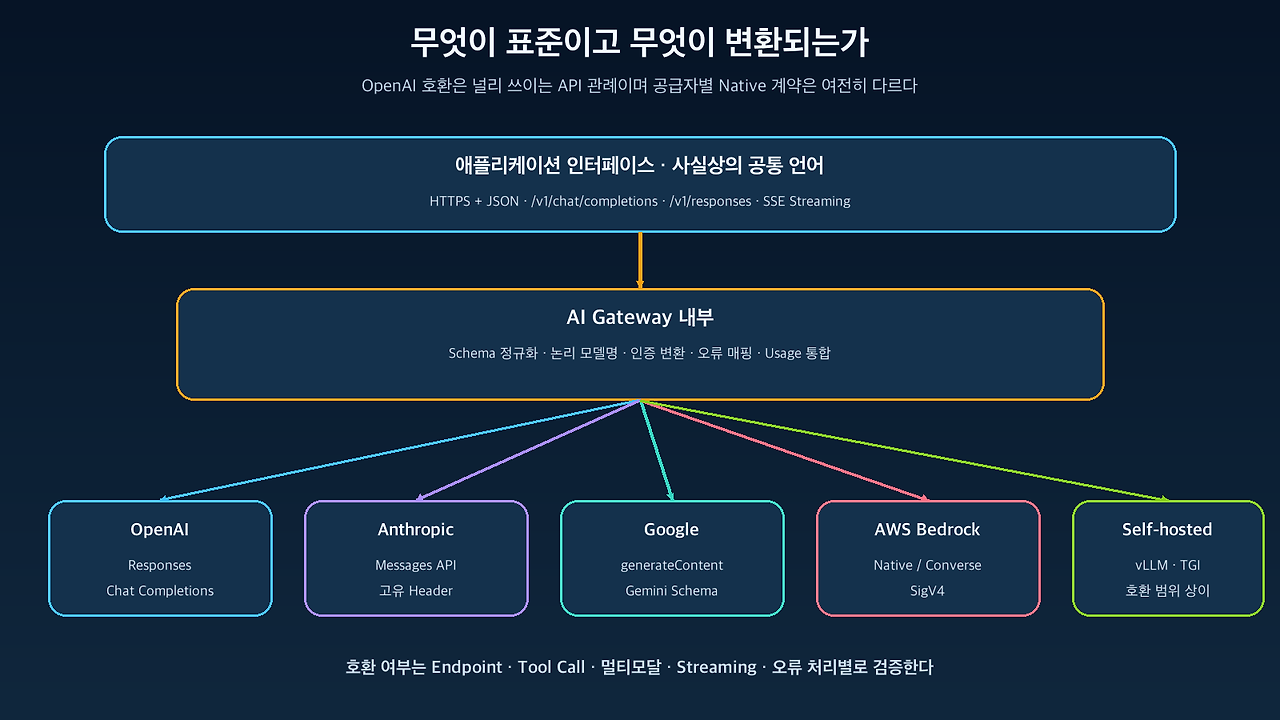
图:AI网关的协议层和事实接口 · 基于OpenAI API、LiteLLM、Higress AI Proxy文档重构
何时需要AI网关
对于只调用一个模型的小型服务,网关反而可能增加运营负担。当出现以下多个条件时,引入AI网关的价值会大大增加。
模型和提供商不止一个
如果由于价格、性能、数据位置和故障风险需要切换或并行使用模型,那么统一的Endpoint和逻辑模型名称将非常有用。您可以在不修改应用程序的情况下,仅更改网关的路由策略。
需要组织统一认证和成本控制
不再向所有团队分发提供商API密钥,而是由网关颁发短生命周期令牌或虚拟密钥。可以集中管理用户·部门·项目级别的模型允许列表、月度预算以及TPM·RPM限制。
故障响应和重试至关重要
LLM调用比普通API耗时更长,并且经常发生速率限制或临时容量不足。网关可以一致地应用超时、指数退避、熔断器和回退。但是,如果已开始响应的流式请求被切换到另一个模型,可能会出现重复语句或计费问题,因此必须明确重试的可能点。
需要安全和审计
需要追踪谁向哪个模型发送了何种数据等级的数据,并确保不向外部模型发送包含个人信息的Prompt。网关是连接DLP·Guardrail·审计日志的理想位置。
但是,如果无条件地在网关中存储原始Prompt和Response,那么该网关将成为最大的个人信息存储库。默认不存储正文,必要时分离脱敏、加密、保留期限和查阅权限会更安全。
主流开源AI网关对比
| 项目 | 最适合的环境 | 优势 | 需确认事项 |
| — | — | — | — |
| LiteLLM Proxy | 快速构建通用多模型网关的AI平台团队 | 100+提供商,OpenAI兼容Endpoint,虚拟密钥,成本·预算,路由·回退,广泛集成 | Python中心化运营,频繁发布升级验证,区分OSS与商业功能 |
| Envoy AI Gateway | 将Kubernetes·Gateway API·Envoy作为标准数据平面使用的组织 | 基于Envoy Gateway,CRD,提供商转换,中央·团队网关分层 | 相对较新的项目,更接近声明式基础设施而非操作UI |
| Kong AI Gateway | 将现有Kong API管理体系扩展到AI调用的企业 | 结合现有认证·插件·分析与AI代理,提供商规范化 | 语义路由·缓存等高级功能的许可证和版本确认 |
| Apache APISIX | 希望在单一平台管理高性能API网关和AI流量的组织 | Apache 2.0,LLM代理·负载均衡·重试·令牌速率限制,MCP Bridge | 更偏向插件组合而非AI专用管理体验 |
| Higress | Envoy·Istio·Wasm,同时管理中国及全球模型和MCP的环境 | 基于OpenAI契约的AI代理,多模型·缓存·令牌限制,MCP托管 | 开源版与阿里云商业版的差异,运营生态系统适用性确认 |
| Portkey Gateway | 需要轻量级Edge·Node环境和代码驱动路由·护栏配置的团队 | MIT,快速代理,重试·回退·负载均衡·护栏 | 2.0为预发布版本,需区分Hosted·Enterprise功能 |
LiteLLM Proxy — 通用OSS的首选
LiteLLM同时提供Python SDK和中央代理服务器。应用程序只需将OpenAI SDK的base_url更改为LiteLLM,LiteLLM就会转换提供商特定的请求·响应和错误。
其优势在于支持范围。它在一个项目中处理Chat、Responses、Embedding、图像、语音、Batch等多种Endpoint和多个提供商。虚拟密钥、用户·团队成本、预算、负载均衡、回退和可观测性也更符合AI平台团队的需求。
因此,如果您的目标是“首先将多个外部模型和内部模型捆绑到一个API中”,那么首先进行LiteLLM的PoC是合理的。但是,由于功能增长迅速,固定稳定镜像、审查变更日志以及进行负载·流式传输·数据库故障测试是必不可少的。
Envoy AI Gateway — 更贴近Kubernetes数据平面的选择
Envoy AI Gateway在Envoy Gateway之上管理生成式AI服务的访问。它通过Kubernetes Gateway API和CRD声明Provider、Route和Backend,并在Envoy数据平面中执行请求转换、认证和流量策略。
如果平台团队已经运营Envoy、Gateway API、GitOps和OpenTelemetry,那么引入Envoy AI Gateway会比引入单独的Python网关更自然。它也很好地适用于两层架构,其中中央网关处理认证和全局速率限制,而团队或模型层网关负责详细路由。
同时,Kubernetes的Gateway API Inference Extension解决了一个略有不同的问题。它侧重于在vLLM等自托管模型服务器副本中,考虑KV Cache、队列、LoRA和加速器状态,选择最优的Endpoint,而不是将外部SaaS提供商翻译成单一API。官方文档也说明,像LiteLLM这样的上层AI网关可以与Kubernetes推理网关结合使用。
Kong AI Gateway — 重用现有API管理资产时
Kong通过AI Proxy插件将OpenAI格式的请求转换为多个提供商,并与Kong现有的认证·速率限制·日志记录集成。如果Kong Konnect或Kong Gateway已是企业标准,那么能够直接利用现有运营团队、策略和观测体系是一个巨大的优势。
然而,笼统地说“Kong AI Gateway的所有功能都是开源的”是不准确的。在引入之前,需要区分可作为AI代理使用的功能和需要企业许可证的语义缓存·高级治理功能。
Apache APISIX — 为通用API网关添加AI功能时
Apache APISIX是一个提供动态路由、认证、熔断器和可观测性的Apache 2.0 API网关。通过ai-proxy、ai-proxy-multi、令牌速率限制等插件,可以配置LLM请求转换、多个模型之间的负载均衡和回退。
它适用于希望在单一高性能网关上管理现有HTTP·gRPC·微服务流量和AI API的组织。它还提供MCP Bridge等功能,可以将现有的stdio MCP Server作为HTTP SSE服务暴露,从而可以考虑模型API和工具API的共同入口点。
Higress — 当Envoy·Istio·Wasm集成AI、API和MCP时
Higress是一个基于Istio和Envoy,并通过Go·Rust·JavaScript Wasm插件扩展的AI原生API网关。其AI代理基于OpenAI API契约,在一个项目中处理多模型代理、令牌速率限制、缓存、WAF、认证和MCP服务器托管。
由于它在阿里巴巴内部和云环境中发展而来,对于使用该生态系统和多个中国模型的组织来说具有吸引力。相反,对于国内组织,建议在PoC中确认文档、支持、运营经验以及开源版和商业版之间的功能界限。
Portkey Gateway — 轻量级网关和基于配置的路由
Portkey Gateway是一个基于TypeScript的轻量级MIT项目。它允许通过JSON配置定义重试、回退、加权负载均衡和护栏,并可由OpenAI兼容客户端调用。当需要轻量级、Node·Edge友好的代理时,它是一个值得比较的选项。
目前,官方仓库宣布2.0作为预发布版本,其中企业网关核心已合并到OSS中。由于功能表中还有带星号的Hosted·Enterprise专用功能,因此需要区分实际部署的分支和许可·运营功能进行判断。
如何选择项目
图:按运营环境划分的AI网关选择指南 · 基于各项目官方文档重构
选择标准应基于组织的现有运营方式,而非功能数量。
如果快速多模型集成是首要任务,选择LiteLLM
如果您是基于Python的AI平台团队,OpenAI SDK兼容性很重要,并且希望快速捆绑外部提供商和vLLM·Ollama等内部模型,那么首先验证LiteLLM是合理的。
如果Kubernetes和声明式网络策略是首要任务,选择Envoy
如果Gateway API、GitOps、Envoy和OpenTelemetry已是标准,请考虑Envoy AI Gateway。如果优化自托管GPU模型服务是核心,则还需要查看Gateway API Inference Extension和llm-d Router等Endpoint Picker层。
如果已有API网关,首先考虑扩展可能性
如果您已经稳定运营Kong、APISIX或Higress,请在添加新的网关之前,检查现有产品的AI插件是否满足您的要求。创建两套认证·审计·故障响应体系的成本可能比想象中要高。
如果需要非常轻量级的Edge代理,选择Portkey
如果您需要在Node环境中快速启动,并且代码驱动的配置、重试·回退和基本护栏很重要,那么Portkey可能适合。但是,您需要确认是否能接受预发布版本和商业功能之间的界限。
PoC中必须验证的检查清单
仅凭产品介绍中的支持列表进行选择,可能会在运营阶段暴露出问题。至少需要通过实际流量测试以下项目:
- 功能兼容性:Chat、Responses、Tool Call、Structured Output、Embedding、图像和流式传输是否在目标模型中实际运行?
- 故障语义:在429、5xx、超时、流中断时,哪些请求会被重试,是否存在重复计费和重复输出?
- 认证和权限:提供商密钥是否未暴露给应用程序,并强制执行用户·项目·模型级别的权限?
- 成本准确性:是否正确计算了缓存令牌、推理令牌、图像·语音成本以及提供商折扣?
- 数据保护:Prompt·Response·Header是否不会以原始形式保留在日志、跟踪、错误和管理员界面中?
- 性能:短请求的额外延迟、长SSE连接数、背压以及网关故障时的影响是否在可接受范围内?
- 运营恢复:即使配置数据库或控制平面停止,现有数据平面是否能安全运行?
- 升级:API Schema、数据库迁移、插件和模型提供商的更改是否可以通过金丝雀发布进行验证?
- 许可证:OSS核心、商业插件、托管服务的界限和支持条件是否已文档化?
特别是“支持回退”的描述是不够的。回退到同一系列模型的不同区域与回退到完全不同的模型,其回答质量、Tool Schema和安全策略都会有所不同。需要使用针对业务的Golden Dataset来比较正常响应率和语义变化。
推荐参考架构
当规模扩大时,最好将功能分层,而不是将所有功能集中到一个网关中。
애플리케이션
→ WAF / 일반 API Gateway
→ AI Gateway
   ├─ 사용자·테넌트 인증
   ├─ 모델 허용 목록·예산·Rate Limit
   ├─ PII / Guardrail 연계
   ├─ 논리 모델 Routing·Fallback
   └─ 토큰·비용·품질 관측
→ 외부 Model API
또는
→ Kubernetes Inference Gateway
→ vLLM / TGI / 사내 Model Server
普通API网关负责互联网边界和组织通用API策略,AI网关负责理解模型语义的策略。在自托管GPU集群内部,推理网关会根据队列和KV Cache状态选择副本。
这种结构也便于产品更换。上层AI网关可以保持OpenAI兼容的Endpoint,而下层推理网关或提供商可以逐步更换。
总结
AI网关不仅仅是一个简单的反向代理。它是AI平台的入口点,将多个模型提供商的HTTP/JSON API转换为通用接口,并集中管理认证密钥、成本、路由、故障响应、观测和安全策略。
目前市场上没有ISO或IETF定义的“AI网关标准产品”。相反,OpenAI兼容API已成为应用程序层的事实通用语言,而LiteLLM最接近通用多提供商OSS的代表性选择。在Kubernetes自托管推理中,Gateway API Inference Extension和Envoy系列正在形成独立的标准化轴。
因此,答案取决于运营环境,而非单一的标志。
如果想快速捆绑多个模型,选择LiteLLM;如果想标准化Kubernetes网络和GPU推理,选择Envoy·Gateway API系列;如果已有API网关,首先考虑扩展Kong·APISIX·Higress是现实的起点。
发表回复