AI DLPは、AIサービスが機密データを不適切な場所に送信しないように制御するシステムです。DLPはData Loss Prevention、つまりデータ損失防止を意味します。チャットボットに貼り付けられた顧客情報、検索で取得された内部文書、AIが作成した回答はすべて保護対象となり得ます。
このようなサービスを構築する際によく登場するツールがPresidioとNVIDIA NeMo Guardrailsです。Presidioは機密情報を検索してマスキングする役割を、NeMo Guardrailsは検査とポリシーを会話・処理フローに接続する役割を担います。これら2つのツールをアプリケーションの実際のブロック機能と組み合わせた構成は、AI DLPパイプラインとして説明できます。
この記事では、これら2つのツールの役割を分けて検討し、顧客相談内容を要約するAIサービスを例に、データがどこで検査され、どこで停止すべきかを整理します。説明の範囲は主にテキストを処理するLLMアプリケーションです。
AI DLPの中心にはデータと目的地がある
DLPの基本的な質問は簡単です。「このデータをこの人がこの目的地に送信してもよいか?」同じ文書であっても、社内承認されたストレージに保管する場合と、外部サービスにアップロードする場合とではポリシーが異なる可能性があります。
企業向けDLPは、この質問をメール、ファイル共有、端末、クラウドアプリなど、さまざまな経路に適用します。例えば、Microsoft Purview DLPは、機密情報とユーザー活動をポリシー条件として評価し、条件に応じて共有を制限したり、警告・監査記録を残したりする機能を提供します。保護範囲と適用方法は、製品と展開構成によって異なります。MicrosoftのDLP概要
LLM、つまり大規模言語モデルを使用するサービスでは、データ移動経路がさらに増えます。ユーザー入力をモデルプロバイダーに送信し、社内文書を検索してモデルの参考資料として組み込み、ツールを呼び出して業務システムのデータを取得します。生成された回答はユーザーに伝達され、運用ログにも残る可能性があります。
ここでは、この経路に機密情報識別、目的地別ポリシー、マスキングまたはブロック、検証記録を接続した構成をAI DLPと呼びます。「AI DLP」は文脈によってAIを活用したDLPという意味でも使われるため、文書や講義では保護対象がLLMの入力・検索・出力経路であることを併記すると範囲が明確になります。
| 構成要素 | 主な役割 | 連携する機能 |
| — | — | — |
| Presidio | 個人情報など設定された機密情報タイプの検出と変換 | 保護する情報の定義、言語別認識器、後続ポリシー |
| NeMo Guardrails | 入力・検索・会話・ツール・出力の検査とフロー制御 | 検査モデル・アクション、業務ポリシー、アプリケーション連携 |
| アプリケーション・ゲートウェイ | 実際の要求伝達・応答返却・ツール実行の許可と中断 | 認証・権限、送信先、エラー処理、監査記録 |
| 企業向けDLP | 複数の業務チャネルにわたるデータ移動制御 | 製品がサポートするチャネルの接続と組織ポリシー |
この表は、各構成要素の主な責任をまとめたものです。機能には重複する部分があります。NeMo内でPresidioを呼び出すこともできますし、ゲートウェイが独自の検査機能を提供することもあります。重要なのは、ツールの数よりも、データが実際に通過する経路に制御が接続されているかどうかです。
Presidio: 機密部分を見つけて必要な方法で変換する
Presidioのテキスト処理構造は2段階で理解すると簡単です。Analyzerは「どこにどのような機密情報があるか」を検出し、Anonymizerは「検出した部分をどのように変更するか」を処理します。
Analyzerは認識器という検出単位を使用します。認識器は正規表現、ルール、文脈、固有表現認識モデルなどを活用できます。固有表現認識は、文中の人名や場所のような特定の種類の表現を見つける作業です。検出結果には、情報タイプ、開始・終了位置、スコアなどが含まれます。Presidio Analyzerドキュメント
Anonymizerは、この位置情報を受け取り、文字列を削除したり、別の値に置換したり、一部の文字をマスキングしたり、暗号化したりするなどの処理を実行します。例えば、相談内容を外部モデルで要約する際に、顧客の連絡先が要約に不要な場合、その部分だけを削除した文章を送信できます。Presidio Anonymizerドキュメント
以下は処理概念を示す例です。中括弧内の値は実際の個人情報の代わりに使用した説明用の表記であり、Presidioを実行して得られた検出結果ではありません。
처리 전
고객 {고객 이름}의 연락처는 {고객 이메일}이다.
배송 지연에 대한 문의를 한 문장으로 요약해 줘.

필요한 항목을 탐지·치환한 뒤
고객 [PERSON]의 연락처는 [EMAIL_ADDRESS]이다.
배송 지연에 대한 문의를 한 문장으로 요약해 줘.
要約に必要な「配送遅延問い合わせ」は残し、名前と連絡先の露出を減らす構成です。逆に、本人確認や連絡先修正が目的であれば、必要なデータと許容される処理環境が異なります。マスキング範囲は業務目的と受信者の権限に合わせて定めます。
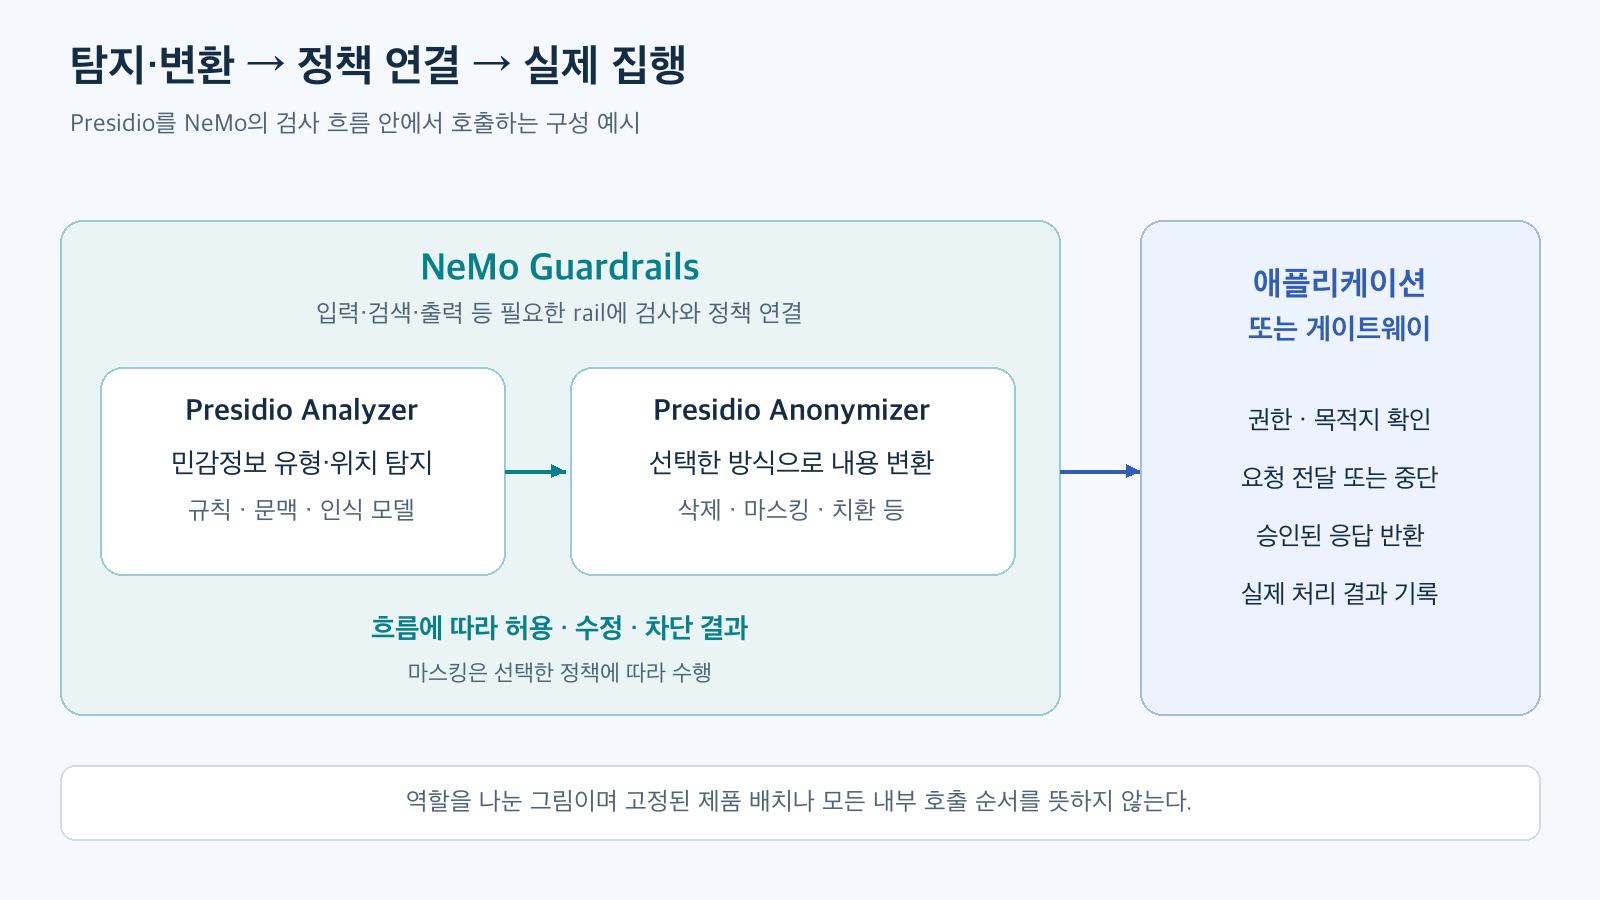
図1. 検出・変換、ポリシー接続、実際の実行の役割関係。Presidio Analyzer、Anonymizer、NeMoのGuardrail Types公式ドキュメントに基づいて再構成しました。アプリケーション実行領域は、この記事の設計例です。
ここで「匿名化」という名前は、処理方式と合わせて読む必要があります。PresidioのAnonymizerには、暗号化のように元に戻せる演算もあります。名前を隠しても、他の情報と組み合わせることで個人を特定できる可能性が残ります。したがって、処理結果を説明する際には、「連絡先をマスキングした」「識別子を置換した」のように、実際に行った動作を記述する方が正確です。
韓国語と社内情報はどのように扱うか?
2026年9月15日に確認した公式サポートリストには、韓国の住民登録番号であるKR_RRN、運転免許番号であるKR_DRIVER_LICENSEなど、韓国関連のタイプが含まれています。実際のサービスでは、使用するパッケージバージョンに該当する認識器が含まれているか、設定でロードされ、検査対象として選択されているかを確認する必要があります。Presidioサポートタイプ
韓国語の名前と住所、文中の文脈は別の問題です。Presidioの多言語ドキュメントでは、基本構成が英語モデルと認識器を含み、追加言語のためにNLPエンジンと認識器・文脈単語を合わせるように説明しています。韓国関連の番号タイプのサポートと、韓国語文全体の検出品質を分けて検証する理由です。Presidio多言語サポート
個人情報以外にも保護すべき情報は多くあります。社内プロジェクトコード、非公開契約条件、設計文書は、個人情報検出だけでは十分に分類できない場合があります。このような情報には、業務別認識器、文書のセキュリティ等級、分類ルールなどを併せて適用できます。Presidioはユーザー定義認識器を追加できますが、保護すべき情報の意味とポリシーはサービスが具体的に定義する必要があります。
ちなみに、「Microsoft Presidio」として知られるプロジェクトは、現在Data Privacy Stackの独立したコミュニティプロジェクトに移行中であるという案内が掲載されています。この記事のPresidioリンクは、現在の公式ドキュメントを基準に接続しました。プロジェクト移行案内
NeMo Guardrails: 検査を必要な箇所に接続する
NeMo Guardrailsにおけるrailは、リクエスト処理中にポリシーを適用する検査・制御フローを意味します。検査ポイントは入力と出力だけでなく、検索された文書やツール呼び出し、複数回続く会話にも配置できます。
2つのツールを併用する構成も公式に提供されています。NeMoのPresidio連携には、入力、出力、検索された文書の断片から機密情報を検出またはマスキングするフローがあります。したがって、「NeMoを経由した後、別途Presidioサーバーを必ずもう一度経由する」という固定的な配置ではなく、NeMoの該当railがPresidio検査を呼び出す構造でも実装できます。NeMo PII Detection
このとき、検出とマスキングは異なるポリシー動作です。「機密情報があればリクエストを拒否する」と「機密情報を置換した後にリクエストを続行する」ではユーザー体験も異なります。どのようなタイプを検査するか、どの段階で適用するか、どのような動作を選択するかは構成に含める必要があります。NeMoのPresidio連携案内
例えば、「すべての顧客の情報を表示して」というリクエストを制限するポリシーを作成できます。これには、リクエストの意味を判断するルールやモデル、その結果に基づいて処理を停止するアクションが必要です。NeMoをインストールしたという事実だけで、社内業務ポリシーや顧客データアクセス権限が自動的に定義されるわけではありません。
一つのリクエストを追跡するとAI DLPの範囲が見えてくる
顧客相談を要約するサービスを仮定してみましょう。ユーザーは相談内容を入力し、サービスは必要な業務文書を検索した後、LLMに要約を要求します。RAGはRetrieval-Augmented Generationの略で、検索した資料をモデルの参考文脈に入れて回答を生成する方式です。
次の図は、このサービスのための設計例です。NeMoの実際の内部呼び出し順序をそのまま描写した図ではなく、データが次の目的地に移動する前に満たすべき条件を中心に描かれています。
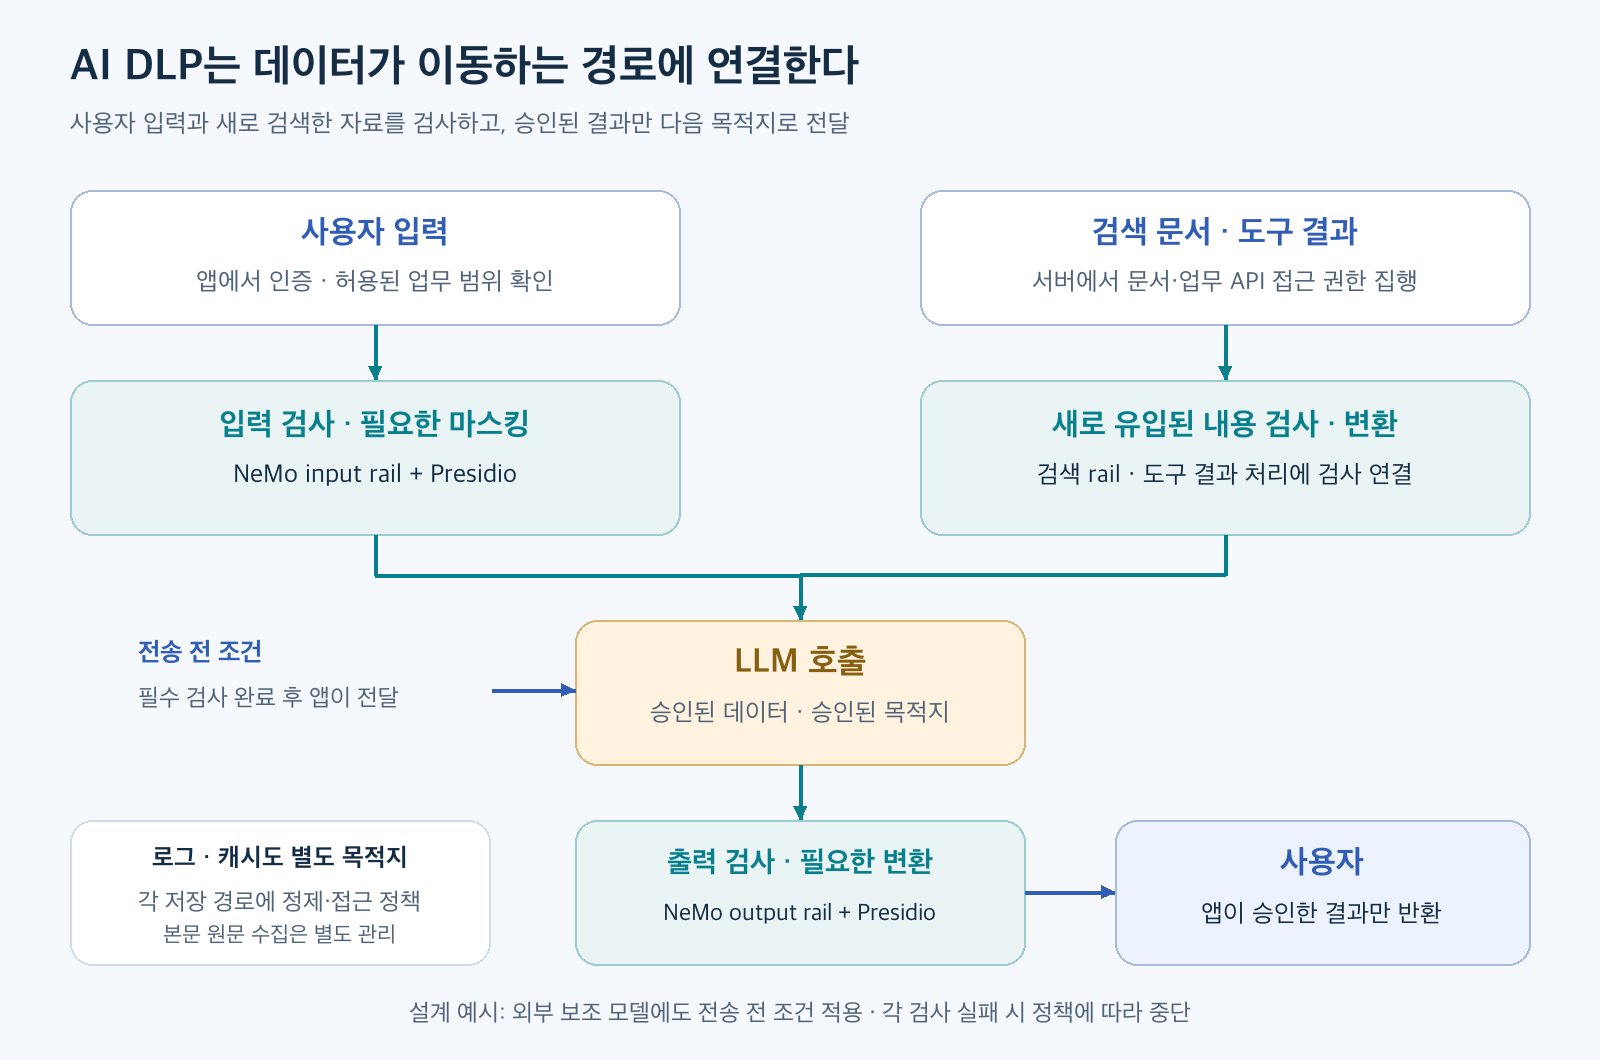
図2. LLMサービスのデータ移動と検査位置。NeMo PII Detection、Guardrail Types、Microsoft DLP概要公式ドキュメントに基づいて再構成した設計例です。権限検査と送信・応答実行はアプリケーションの責任として示されています。
第一に、アプリケーションがユーザーの身元と許可された業務範囲を確認します。どのような文書を検索できるか、どのような顧客の記録を閲覧できるか、どのようなツールを実行できるかをサーバーで制限します。この範囲が定められて初めて、その後のデータ検査が意味のあるポリシーにつながります。
第二に、ユーザー入力を次の受信者に送信する前に必要な検査を完了します。外部モデルに元の個人情報を送信しないことが目標であれば、その境界を越える前に検出・マスキングが完了している必要があります。ここでいう外部モデルには、回答を作成する主モデルだけでなく、リクエストを分類する補助モデルも含まれます。
この順序は設計上の条件です。例えば、入力ポリシーを判断する外部LLMに元のテキストを先に送信し、後でPresidioでマスキングすると、その補助モデルにはすでに元のテキストが伝達されてしまいます。したがって、個人情報を処理できる承認された環境内で先に検査するか、承認された検査サービスとデータ処理経路を使用するように構成します。
検査と生成を並行して実行する設定も同じ基準で判断します。NeMoには入力検査中に生成を開始する方式があるため、送信前に検査完了が必須の経路では、実際の構成と呼び出し順序を確認します。マスキングした内容を検査する必要がある後続のrailは、マスキング後に順次実行します。NeMoランタイムセキュリティFAQ
第三に、検索とツールを通じて新たに入ってきたデータも検査します。ユーザー入力に個人情報がなくても、検索された相談記録には連絡先が含まれている可能性があります。権限が許可した文書のみを検索対象に制限し、モデルに組み込む前には目的地ポリシーに合わせて必要な項目をマスキングします。ツール結果がモデルの文脈に入る場合も同じ観点で扱います。
第四に、生成された回答を検査した後、実際の応答を返します。アプリケーションはrailの結果を受け取り、承認された回答を送信するか、修正された回答を送信するか、リクエストを終了します。ライブラリが「ブロック」を返しても、別のコード経路が元の応答をそのまま送信すれば、その経路には制御が適用されません。
このように、入力と出力のPresidio検査、NeMoのポリシーフロー、アプリケーションの実行を接続することで、データ保護動作をエンドツーエンドで説明できます。セキュリティアーキテクチャ文書でも、各段階の名前の横に「何を検査し、失敗したら何を停止するか」を記述すると、実装範囲が明確になります。
マスキングとアクセス権限は異なる質問に答える
機密情報検出は「この内容に保護すべき情報があるか」を判断します。アクセス権限検査は「このユーザーがこの情報にアクセスできるか」を判断します。両方の判断が共に必要です。
例えば、相談担当者が担当顧客1名の記録を要約する権限を持っているとしましょう。外部モデルに渡す連絡先はマスキングできますが、その事実が他の部署の顧客の記録まで検索する権限を与えるわけではありません。逆に、アクセス権限がある従業員のリクエストであっても、データを伝達する外部サービスが承認された目的地であるかを確認する必要があります。
したがって、この設計では、文書検索と業務APIの権限をサーバーで実行し、ガードレールを通じてリクエスト・結果の適切性を追加で検査します。データ所有者、ユーザーロール、文書等級、送信先などの業務情報がポリシー判断に接続される必要があります。この部分は、2つのライブラリの機能説明から拡張したアプリケーション設計原則です。
運用では検査順序と記録経路まで確認する
AI DLPの効果を確認する際には、検出結果と実際の伝達結果を合わせて見ます。次の3点は特に設計段階で決定しておくのが良いでしょう。
ストリーミング: 検査された範囲のみを出力する
ストリーミングは、モデルが作成する回答を少しずつユーザーに送信する方式です。すでに送信された内容は、後からの出力ブロックで回収することはできません。機密情報漏洩を防ぐことが目標であれば、回答全体をまとめて検査するか、検査された範囲のみを送信するようにバッファと出力ポリシーを構成します。
NeMoはストリーミングと出力rail設定を提供します。公式FAQでは、露出前に検査が必要な場合、stream_first: Falseで区間を先に検査するように案内しています。適用時には、検査単位、バッファ処理、中断動作を実際の統合環境で確認します。全体応答検査と区間別検査は、遅延時間と文脈確保の側面で異なる特性があります。NeMoストリーミング設定、ランタイムセキュリティFAQ
エラー: 検査失敗をどのような結果として処理するかを決定する
検出器やポリシーサービスがタイムアウトを引き起こす可能性があります。このとき、リクエストを中断するか、機能を制限するか、他の承認された処理経路に送るかを決定します。例えば、元の個人情報の外部送信を禁止した経路であれば、必須検査を完了できなかったリクエストは外部に伝達しないように設計できます。
これは、すべてのサービスに同じ中断ルールを適用するという意味ではありません。保護すべきデータと業務への影響に応じてポリシーを分ける一方で、「検査が実行されなかった状態」と「検査を通過した状態」を記録で区別することが重要です。
ログ: 保護結果を監視しつつ、元のテキストの保存を減らす
ユーザーに返却した回答をマスキングしても、入力元のテキストが追跡システムに先に保存される可能性があります。NeMo公式ドキュメントも、PII railがすべてのアプリケーションログと外部監視システムを自動的に浄化するわけではないと説明しています。ログ、キャッシュ、エラー報告、再試行記録もデータの別の目的地と見なし、保存前の処理とアクセス・保存ポリシーを適用します。NeMoランタイムセキュリティFAQ
運用指標は、元のテキスト全体がなくてもかなりの部分を収集できます。どのようなポリシーバージョンが適用されたか、どのような情報タイプが検出されたか、どのような動作が実行されたか、処理にどれくらいの時間がかかったかをリクエスト識別子と関連付ける方式です。元のテキストの確認が必要な限定された調査経路は、別途権限と保存期間を定めます。この節の項目は、前述のデータ移動範囲を運用経路まで拡張した設計例です。
導入効果は検出品質と業務結果で評価する
Presidio公式ドキュメントは、自動検出がすべての機密情報を見つけることを保証するものではなく、ユースケースに合わせた評価が必要であると説明しています。評価では、正常なデータが誤ってブロックされるケースと、機密情報を見逃すケースを合わせて測定します。Presidioプロジェクト案内、PII検出評価ドキュメント
まず、合成データなど制御された評価資料で精度と再現率を確認できます。精度は、機密情報として検出されたものの中で実際に機密情報であったものの割合であり、再現率は、実際の機密情報の中で検出されたものの割合です。名前、連絡先、識別番号のようにタイプ別に分け、韓国語・英語が混在する資料も区別すると、改善すべき箇所が明らかになります。
次に、アプリケーション全体の結果を確認します。以下の項目は、この記事の相談要約サービスのための評価例です。
- 伝達結果: 外部モデルに伝達された値とユーザーに返却された値が、該当ポリシーに適合しているか?
- 業務品質: マスキング後も配送遅延の原因と顧客要求を正しく要約しているか?
- 正常処理: 機密情報を含まない相談まで不必要に拒否していないか?
- 失敗処理: 必須検査に失敗した場合、定められた中断・制限動作が実行されるか?
- 運用コスト: 検査追加によって発生する遅延とコストがサービス目標内に収まっているか?
特にマスキング後には、情報関係が変わる可能性があります。異なる2人の人物をすべて同じ表記に置換すると、「誰が誰に要求したのか」が曖昧になります。区別が必要な業務であれば、異なる代替識別子を使用する設計を検討し、元の値と代替値の対応表を保管する場合は、その表も保護対象として管理します。
まとめ: 2つのツールをAI DLPの構成要素として説明できる
PresidioとNeMo Guardrailsを使用してLLMサービスの機密情報を保護するプロセスは、AI DLPの実装というテーマで説明できます。各ツールの役割と保護範囲を併記することで、技術的な意味も明確になります。
- Presidio: 機密情報を検出してマスキング・置換するデータ保護エンジン。
- NeMo Guardrails: AI DLPポリシーを含む検査と処理フローを構成するガードレールエンジン。
- アプリケーション・ゲートウェイ: 権限と目的地ポリシーに基づいて、データ伝達と作業実行を実際に許可または中断する実行レイヤー。
この構成を紹介する講義や設計文書には、「LLM環境におけるAI DLPの実装: PresidioとNeMo Guardrails」という名前を使用できます。その中に、入力・検索・ツール結果・出力・ログの処理範囲と検証基準を共に含めることで、読者はツールの機能とシステムが提供する保護を関連付けて理解できます。
AI DLPの実質的な保護範囲は、どのようなツールがインストールされているかに加えて、どのようなデータがどの目的地に移動し、その前にどのような検査と実行を経るかによって決定されます。
コメントを残す