最近、多くの企業が重要なデータを社内データセンター(オンプレミス)に置き、新規サービスはクラウドで開発する「ハイブリッド」戦略を採用しています。🏢☁️
安定性と柔軟性、両方を手に入れる良い方法です!しかし、開発者と運用者には言えない苦悩が生まれます。それは、「障害が発生したときに原因が特定できない」という点です。
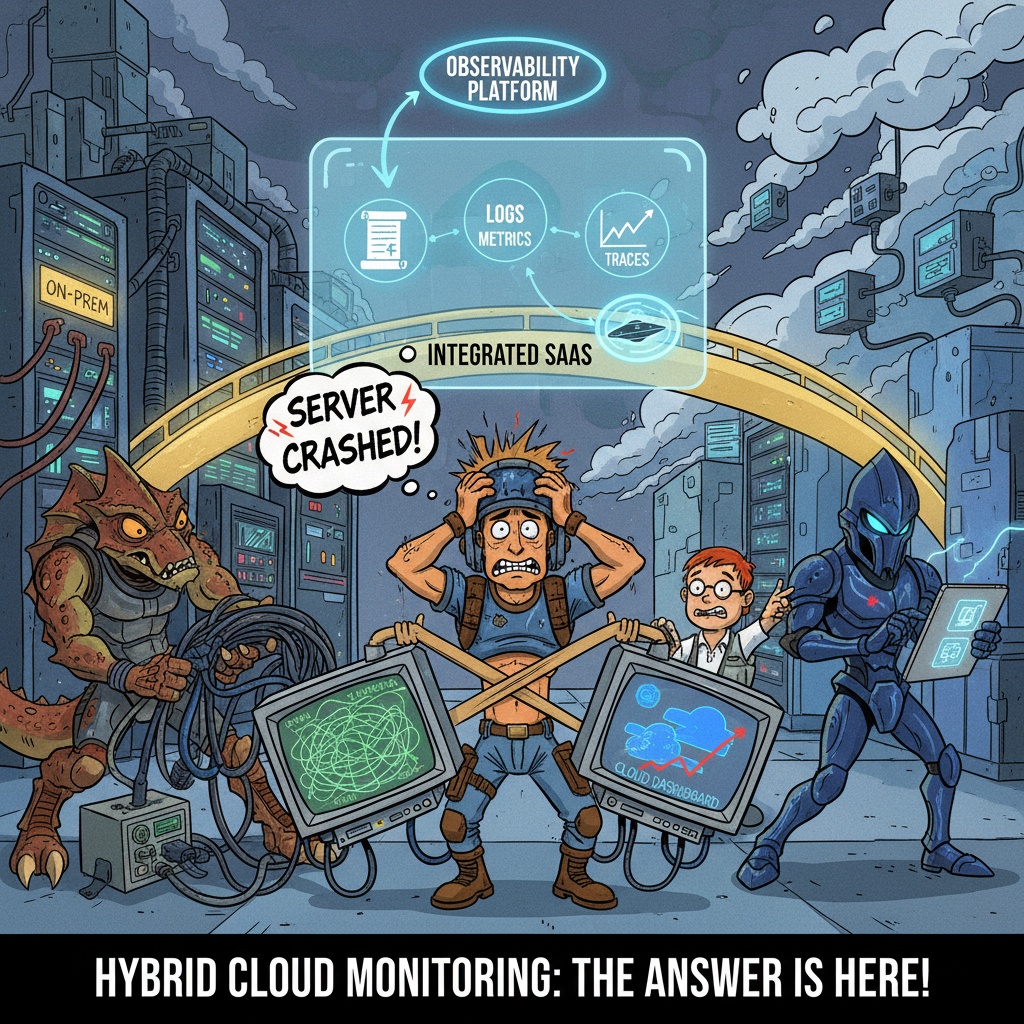
オンプレミスサーバーのログを別々に見て、クラウドのダッシュボードを別々に見て… 😵 まるで2つの異なるテレビチャンネルを同時に見て、全体像を把握しようとするようなものです。システム全体がどのように動いているのか一目で分からず、もどかしく感じていたことでしょう。
本日は、この問題を解決し、システムを透明に把握できる「オブザーバビリティ(Observability)」確保戦略についてご紹介します。
🤔 私たちが陥りがちな落とし穴
問題を解決するために様々なツールを検討しますが、誤った選択はかえって状況を悪化させる可能性があります。代表的な3つの落とし穴をまず見てみましょう。
1️⃣ 落とし穴:「ログだけ集めればいいだろう?」 (単一目的のロギングサービス)
最も基本的なアプローチです。システムが出力するすべてのログ(Log)を一箇所に集めるのです。📜
もちろんログは重要です。「どのようなエラーが発生したか」といった特定のイベントの記録を教えてくれます。しかし、これだけでは不十分です。
- 限界点: ログはシステムの
状態(Health)
や性能を直接的に示すことはできません。例えば、「CPU使用率が90%に迫っている」(メトリック)とか、「ユーザーリクエストがDBで5秒も遅延している」(トレース)といった情報は分かりません。
⚽️ 例え:サッカーの試合で最終スコア(ログ)だけを知っているようなものです。誰がゴールを決めたのか、ポゼッション率はどうだったのか(メトリック)、ゴールが決まるまでにどのようなパスが交わされたのか(トレース)は分からないのと同じです。
2️⃣ 落とし穴:「最新技術だから!」 (クラウドネイティブ専用プラットフォーム)
Kubernetes、サーバーレスなど、クラウドネイティブ環境向けの素晴らしい監視ツールは本当にたくさんあります。🚀 しかし、私たちには「オンプレミス」という重要な環境が残っています。
- 限界点: これらのツールはクラウド環境のデータは驚くほど収集しますが、社内データセンターにあるレガシーサーバーは全くサポートしないケースが多いです。結局、オンプレミスは依然として原因不明の「ブラックボックス」として残ってしまいます。⬛
🏡 例え:最新のスマートホームセキュリティシステムを導入したのに、新しく増築した別館にだけカメラを設置し、肝心な本館はそのままにしているようなものです。半端なセキュリティと言えるでしょう。
3️⃣ 落とし穴:「自分たちで作ろう!」 (手動拡張が必要なオープンソース)
「オープンソースで自社構築すれば、コストも抑えられ、自分たちの好みに合わせて作れる!」🔧 とても魅力的な言葉ですが、ここには見えないコストが隠されています。
- 限界点: オープンソースツールを安定的に運用するには、専任の担当者が必要です。サービスが大きくなると手動で拡張する必要があり、セキュリティパッチ、バージョン管理、障害対応など、運用負担が指数関数的に増大します。特にセキュリティや規制遵守が重要なシステムの場合、自社構築したシステムの安定性を保証することは困難です。
🏭 例え:自宅に必要な電気を使うために、自分で小規模な発電所を建てるようなものです。可能ではありますが、安定性、メンテナンス、コストの面から見ると、専門の電力会社のサービス(SaaS)を利用する方がはるかに効率的です。
✨ 答え:すべてを一つに!統合SaaSオブザーバビリティプラットフォーム
では、答えは何でしょうか?それは、オンプレミスとクラウド環境の両方から普遍的にテレメトリーデータを収集できるSaaSベースのオブザーバビリティプラットフォームを利用することです。
少し難しい言葉ですよね?3つのキーワードに分けて見ていきましょう。
- SaaS (Software as a Service) ✅
- プラットフォームのインストール、拡張、メンテナンスについて心配する必要はありません。専門企業がすべて対応してくれます。私たちはただシステムデータを送信し、分析に集中するだけで済みます。運用リソースが画期的に削減されます。
- オブザーバビリティ(Observability)プラットフォーム ✅
- 単にログ、メトリック、トレースを別々に表示するだけではありません。これら3つのデータを有機的に連携させます。例えば、「CPU使用率が急増した(メトリック)時点でどのようなエラー(ログ)が発生し、このエラーがどのユーザーのリクエスト(トレース)から始まったのか」を一度に把握できるようになります。
- 普遍的なデータキャプチャ ✅
- これが核心です。プラットフォームが提供するエージェント(Agent)や標準プロトコル(例:OpenTelemetry)を通じて、どこからでもデータを収集できます。古い物理サーバー、仮想マシン(VM)、コンテナ、サーバーレス関数まで、環境に左右されずにすべてのデータを一箇所に集めることができます。
これはどのように可能なのでしょうか? (簡単な例)
通常、このようなプラットフォームは、データを収集する軽量エージェントをインストールする方式で動作します。例えば、最近標準として定着したOpenTelemetry Collectorの設定ファイルを一度見てみましょう。
この設定ファイル一つで、オンプレミスサーバーのログファイルとクラウドアプリのデータをすべて収集し、一つのSaaSプラットフォームに送信することができます。
コード例: otel-collector-config.yaml
# OpenTelemetry Collector 設定例
receivers:
  # クラウドネイティブアプリからのデータを受信 (標準プロトコル)
  otlp:
    protocols:
      grpc:
      http:

  # オンプレミスサーバーのログファイルを読み込む
  filelog:
    include: [ /var/log/my_onprem_app.log ]
    start_at: beginning

processors:
  batch:

exporters:
  # 収集したすべてのデータを「MySaaSPlatform」に送信
  otlphttp:
    endpoint: "https://api.my-saas-platform.com/v1/metrics"
    headers:
      "api-key": "YOUR_API_KEY" # SaaSプラットフォーム認証キー

service:
  pipelines:
    # メトリック/トレースパイプライン
    traces:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlphttp]
    # ログパイプライン
    logs:
      receivers: [filelog]
      processors: [batch]
      exporters: [otlphttp]
収集されるRawデータの例
このように収集されたデータは、それぞれがコンテキストを持つことになります。
// 例1: オンプレミスサーバーから収集されたログ
{
  "timestamp": "2025-11-06T08:29:00Z",
  "level": "ERROR",
  "message": "Legacy DB connection timeout",
  "attributes": {
    "service.name": "auth-service-onprem",
    "host.name": "idc-server-01"
  }
}

// 例2: クラウドコンテナから収集されたメトリック (Prometheus形式)
http_requests_total{service="payment-service-cloud", pod_name="payment-xyz-123", code="503"} 5

// 例3: クラウド-オンプレミスを横断するトレースデータ (Span)
{
  "traceId": "a1b2c3d4",
  "spanId": "span-002",
  "parentSpanId": "span-001",
  "name": "SELECT user FROM legacy_db",
  "service": "auth-service-onprem",
  "duration_ms": 2500
}
このように収集されたデータは、SaaSプラットフォームのダッシュボードで一つに統合されて表示されます。開発者はもはや複数のシステムをさまよう必要なく、一箇所でシステム全体の流れと状態を把握できるようになるのです。🚀
結論
ハイブリッド環境の複雑性は今後さらに増大するでしょう。このような環境でシステムの安定性とビジネスの継続性を守るためには、「システム全体を一目で把握できる能力」、すなわち統合されたオブザーバビリティの確保が不可欠です。
断片的なツールや特定の環境にのみ依存するソリューションでは、複雑な問題の根本原因を見つけることは困難です。今、あなたのシステムはどれくらい透明に見えていますか?🤔
コメントを残す