OWASP Top 10 for LLMセキュリティ演習環境を構築する際、700万〜1,000万ウォン台のNVIDIAワークステーションの購入を真剣に検討しました。結論は意外にも単純でした。月間のGPU使用時間が少なく、技術変化が速いのであれば、コードはローカルで作成し、実際のGPU検証のみをAWSで実行する方がより合理的でした。
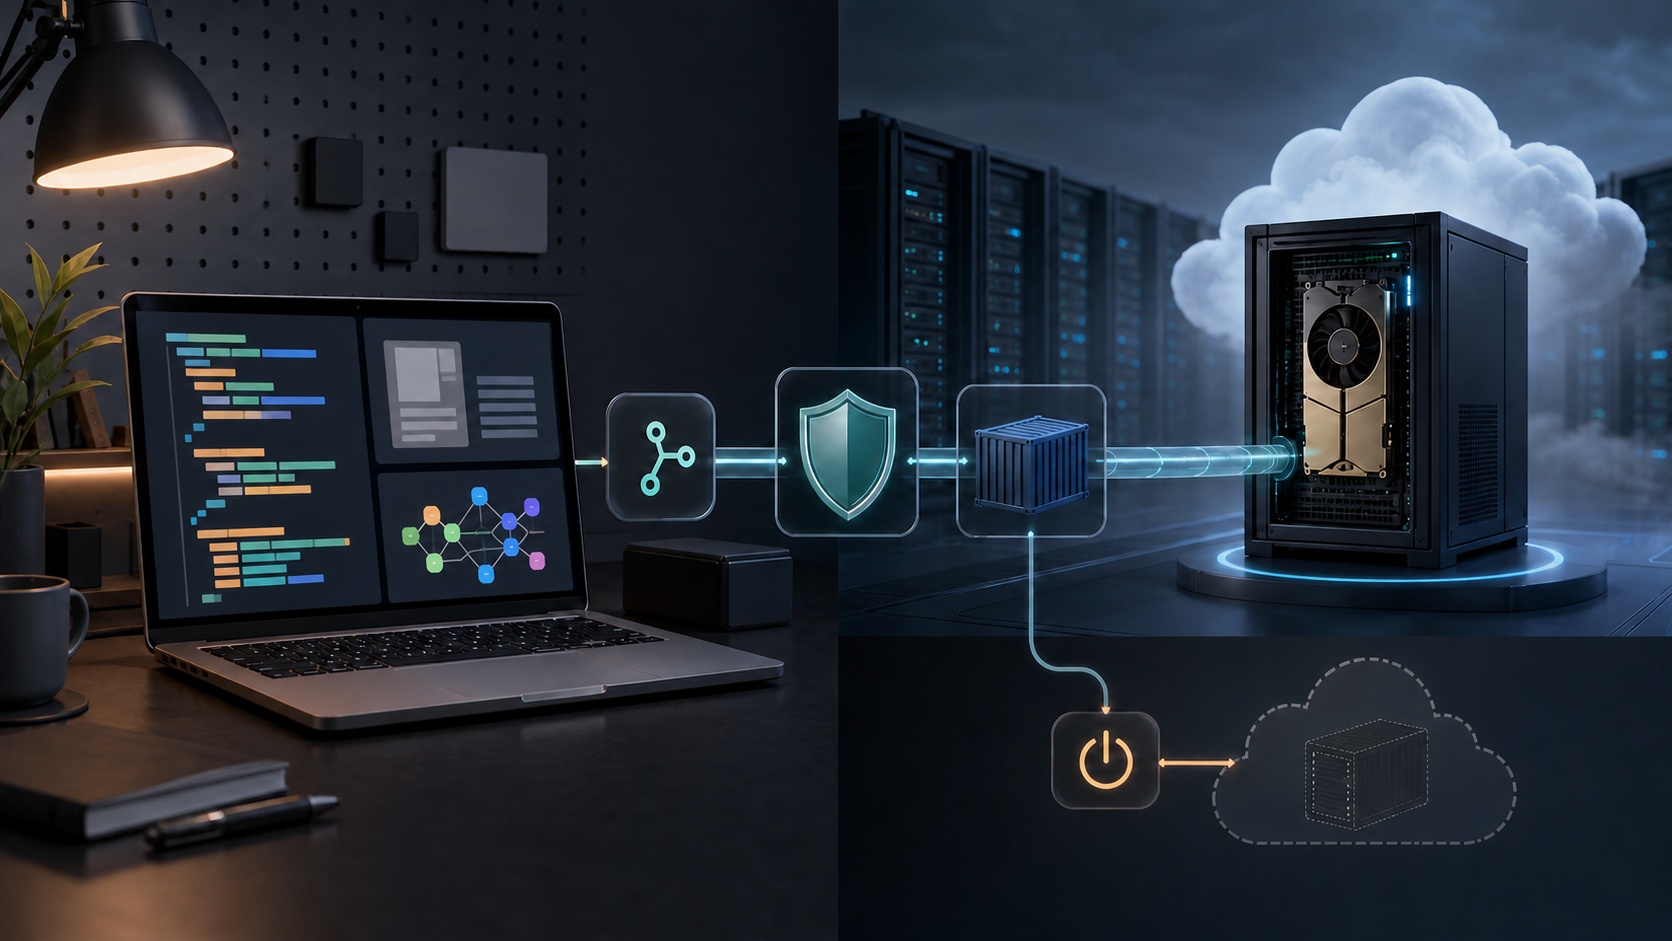
現在使用しているLLMセキュリティ演習環境
演習環境はTerraform、Auto Scaling Group(ASG)、Podman Composeでデプロイします。AWS us-east-1のg6.xlargeはNVIDIA L4 24GB、4 vCPU、16GiBメモリを提供します。GPUが必要な時だけASGのdesired capacityを1に上げ、終了したら0に下げます。
ローカルではMarkdown作成、コード修正、Git作業、静的テストを行います。AWSではOllamaモデルの実行とGuardrail、LLMGoat、Presidio、NeMoを組み合わせ、Log・Trace・Metricの収集およびGrafana画面まで検証します。実際の開発時間のほとんどはGPUを必要としません。さらに、TerraformとASGを含む実際のAWSデプロイ演習は、ローカルGPU一台だけでは完全に代替できません。
AWSの時間あたりの費用はいくらか
この記事では、g6.xlarge Linux On-Demandを1時間あたり0.8048ドル、為替レートを1ドルあたり1,400ウォンと仮定します。付加価値税とパブリックIPv4費用まで保守的に反映し、実行費用を1時間あたり約1,250ウォンとしました。インスタンスを停止しても維持されるgp3 100GBは、EBS料金を参考に月額12,000ウォンと計算しました。
AWS月額費用 = 1,250ウォン × 月間GPU実行時間 + 12,000ウォン
価格、為替レート、税金、リージョン、ネットワーク構成は時期によって異なります。実際のデプロイ前には、AWS On-Demand価格とCost Explorerで再度確認する必要があります。
ローカルサーバーの隠れた費用
ローカル機器は700万ウォンまたは1,000万ウォン、平均消費電力は650W、電気料金は1kWhあたり200ウォンと仮定しました。電気代は1時間あたり約130ウォンです。しかし、購入費用を払えば終わりではありません。減価償却、故障と修理、騒音、発熱、冷房、設置スペース、ドライバーとCUDAのメンテナンスが伴います。
RTX 4090は24GBでL4と同じVRAM容量ですが、消費者向けGPUとデータセンター向けGPUでは安定性・電力・ドライバー・運用特性が異なります。どちらが常に速いと断定することはできません。RTX 5090は32GB VRAMと575W TGPを提供しますが、電源と冷却を含むシステム全体の価格も大きくなります。
月間使用時間別の損益分岐点
| 月間GPU時間 | AWS月額費用 | ローカル電気代 | 700万ウォン機器 | 1,000万ウォン機器 |
| — | — | — | — | — |
| 50時間 | 7.5万ウォン | 0.7万ウォン | 約8.6年 | 約12.3年 |
| 100時間 | 13.7万ウォン | 1.3万ウォン | 約4.7年 | 約6.7年 |
| 176時間 | 23.2万ウォン | 2.3万ウォン | 約2.8年 | 約4.0年 |
| 200時間 | 26.2万ウォン | 2.6万ウォン | 約2.5年 | 約3.5年 |
| 300時間 | 38.7万ウォン | 3.9万ウォン | 約1.7年 | 約2.4年 |
| 400時間 | 51.2万ウォン | 5.2万ウォン | 約1.3年 | 約1.8年 |
月300時間は、平日22日基準で1日あたり約13.6時間です。個人開発者が毎日それほどGPUを実際に稼働させるのは容易ではありません。平日1日8時間すべてをGPU作業に費やしても、月176時間です。この場合、AWSは月額約23万ウォン、年間約276万ウォン、3年間で約828万ウォンとなります。
3年間の損益分岐点計算をそのまま信じがたい理由
3年後には、GPU世代、必要なVRAM、モデルサイズ、量子化技術、CUDA環境が大きく変わる可能性があります。今日購入した24GBの機器が3年後も望むモデルと演習を十分に処理できる保証はありません。クラウド料金には、単なるレンタル料だけでなく、ハードウェアの老朽化と交換リスクをクラウド事業者に転嫁する費用も含まれています。
もちろん、月に数百時間を安定して使用し、データ持ち出しが困難な場合やインターネットなしで実験する必要がある場合は、ローカル機器が有利になることがあります。逆に、AWSは使用量を放置すると費用が急速に増加し、GPU容量不足やネットワーク障害の影響を受ける可能性があります。
私が選択したハイブリッド運用方式
ローカルでは、ドキュメント、Git、コード、静的テストを完了します。GPUが必要な統合テストのみASGを1に上げて実行し、Ollama・NeMo・Presidioと観測スタックの検証が完了したらすぐに0に下げます。これに次の3点を追加すると、コスト管理が容易になります。
- テスト終了後にASGを自動的に0に下げる予約タスクと最大実行時間制限
- AWS Budgetsアラートと月額費用上限
- 開始・終了時刻を記録し、GPU使用時間とテストごとの費用を測定
現在の使用パターンであれば、1,000万ウォン以下のサーバーを事前に購入するよりも、この方式の方が柔軟です。ただし、次の公式に自身の価格と時間を入力して判断するのが最も正確です。
AWS 월 비용 = 시간당 AWS 비용 × 월 GPU 실행시간 + 고정 스토리지 비용

로컬 손익분기 개월 =
장비 구매가격 ÷
((AWS 시간당 비용 - 로컬 시간당 전기료) × 월 사용시간 + AWS 고정비)
この計算には、機器の残存価値、修理費、冷房費、金融費用、クラウドデータ転送費、および両環境の生産性の違いが完全に反映されていません。これらの数字は結論ではなく、自身の実際のGPU実行時間を確認するための出発点として捉えるべきです。
コメントを残す