LLMセキュリティをモデル単体の問題として捉えると、防御ポイントを見落としがちです。実際のサービスでは、ユーザー入力、システムプロンプト、学習データ、RAG、モデル出力、外部ツール、インフラが連携しています。脆弱性はこれらのコンポーネントが接する境界で発生し、互いに結合することで被害が拡大します。
OWASP GenAI Security Projectが公開したTop 10 for LLM Applications 2025は、このライフサイクル全体を10のリスクに整理しています。重要なのは、順位を覚えることではなく、どのようなデータがどこから入り、モデルの出力がどの権限につながるのかを追跡することです。
この記事では、10の項目を入力・学習・RAG・出力・ツール・リソースの境界に配置し、各境界にどのような制御を設けるべきかを説明します。表と図の経路は代表的な発生地点であり、そのリスクが特定の境界でのみ発生するという意味ではありません。
OWASP LLM Top 10 2025 全リスト
| ID | 項目 (英語) | 日本語名称 | 主な発生境界 |
| — | — | — | — |
| LLM01 | Prompt Injection | プロンプトインジェクション | User → System Prompt |
| LLM02 | Sensitive Information Disclosure | 機密情報漏洩 | System/Training → User |
| LLM03 | Supply Chain | サプライチェーン | Pretraining / モデルダウンロード |
| LLM04 | Data and Model Poisoning | データ・モデル汚染 | Training / RAG データ |
| LLM05 | Improper Output Handling | 不適切な出力処理 | LLM → Downstream |
| LLM06 | Excessive Agency | 過剰な権限 | LLM → Tools/APIs |
| LLM07 | System Prompt Leakage | システムプロンプト漏洩 | System Prompt → User |
| LLM08 | Vector and Embedding Weaknesses | ベクトル・埋め込みの弱点 | RAG / Vector DB |
| LLM09 | Misinformation | 誤情報 | Model → User |
| LLM10 | Unbounded Consumption | リソースの無制限消費 | User → Resources |
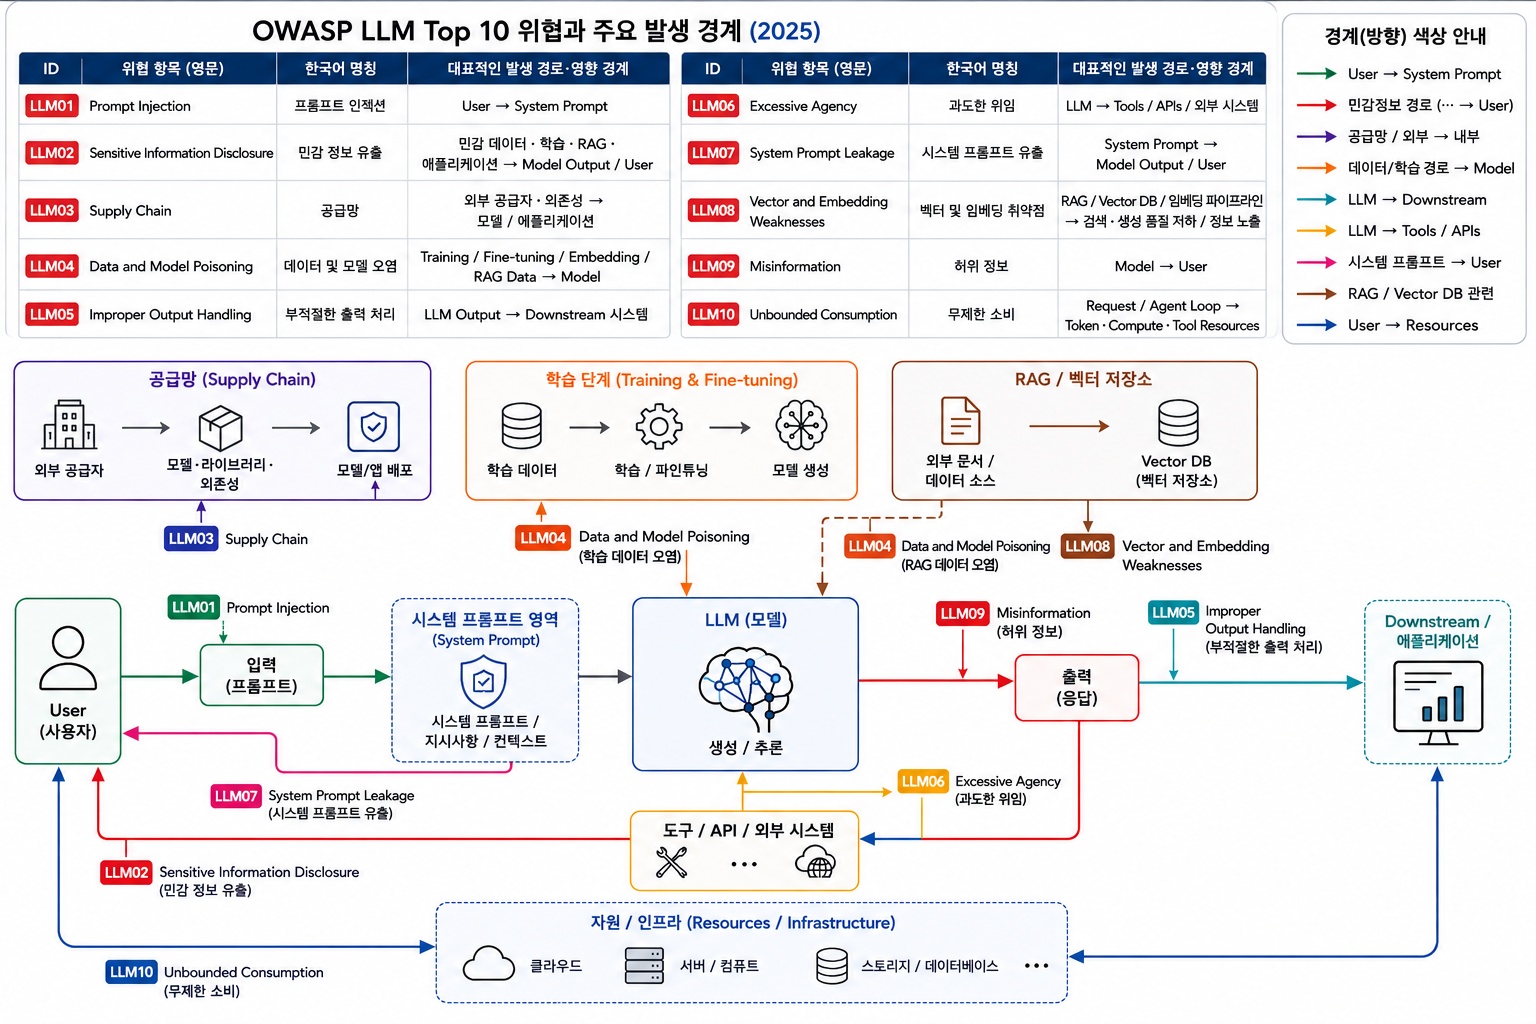
図: OWASP LLM Top 10 リスクと主な発生境界 · ユーザー提供のダイアグラムをOWASP Top 10 for LLM Applications 2025と対照して使用
この構造で注目すべき点は、モデルが中心にあるにもかかわらず、セキュリティ制御のほとんどがモデルの外にあるという事実です。モデルがどのような文章を生成しても、データアクセス権限、コマンド実行の可否、コスト制限、最終承認はアプリケーションとサブシステムが決定する必要があります。
1. 入力と指示の境界: LLM01, LLM07, LLM02
LLM01 プロンプトインジェクション — 入力が指示を変える
プロンプトインジェクションは、ユーザー入力や外部ドキュメントがモデルの意図された動作を変更するリスクです。ユーザーが直接「以前の指示を無視せよ」と書く直接攻撃だけでなく、ウェブページ・メール・PDF・画像の中に隠された指示をモデルが読み取る間接攻撃も含まれます。RAGやファインチューニングは回答の関連性を高めることができますが、このリスクを完全に排除することはできません。
したがって、入力フィルター一つを防御の全てと見なすべきではありません。信頼できないコンテンツをシステム指示と区別し、モデルが攻撃の影響を受けたとしても、機密データの照会や外部タスクの実行につながらないように、別途権限境界を設ける必要があります。
LLM07 システムプロンプト漏洩 — システムプロンプトは秘密の保管場所ではない
システムプロンプト漏洩の核心は、プロンプトの文言自体を永遠に隠すことにはありません。OWASPは、システムプロンプトを秘密やセキュリティ制御と見なすべきではないと説明しています。APIキー、接続文字列、内部アカウント、権限判定ルールをプロンプトに入れた場合、本当の問題は「プロンプトが漏洩した」ことではなく、秘密と権限を置くべきではない場所に置いたということです。
秘密はKMSやシークレットストアに置き、認証・認可や取引限度などの決定はコードとポリシーエンジンで強制する必要があります。システムプロンプトには、モデルの役割と応答形式を案内する情報のみを残す方が安全です。
LLM02 機密情報漏洩 — 回答に出る前にデータ経路を減らす
機密情報漏洩は、個人情報、金融・医療情報、営業秘密、資格情報、学習データ、またはアプリケーションコンテキストが応答を通じて明らかになるリスクです。「機密情報を話すな」というシステムプロンプトだけでは不十分です。プロンプトインジェクションやモデルエラーによって迂回される可能性があるためです。
入力段階では機密データをマスキングし、検索段階ではユーザー権限に合ったドキュメントのみを照会し、出力段階ではDLPとポリシーチェックを再度適用する必要があります。最も強力な制御は、モデルに最初から不要な機密情報を与えないことです。
2. サプライチェーンと学習の境界: LLM03, LLM04
LLM03 サプライチェーン — コード依存性よりも広いAIサプライチェーン
サプライチェーンリスクは、一般的なライブラリだけでなく、事前学習済みモデル、データセット、LoRAアダプター、モデルリポジトリ、デプロイプラットフォーム、ライセンスまで含みます。信頼できないモデルファイルには、バイアスやバックドアが隠されている可能性があり、シリアル化形式やロードコード自体が悪意のある動作を実行することもあります。
モデルとデータの出所、バージョン、ハッシュ、署名、ライセンスを記録し、検証する必要があります。SBOMに加えて、AI/MLコンポーネントとデータ出所を追跡するBOMを運用し、外部モデルは実際の使用シナリオに合わせた評価とレッドチーム検証を受けることが推奨されます。
LLM04 データ・モデル汚染 — 学習と知識ベースの整合性問題
データ・モデル汚染は、事前学習、ファインチューニング、埋め込みデータ、またはモデル自体が操作され、バイアス、バックドア、性能低下、または有害な出力を生み出すリスクです。通常は正常に見えるが、特定のフレーズや条件でのみ動作するトリガー型バックドアは、一般的な品質テストだけでは発見が困難です。
データの出所と変換履歴を保存し、変更承認・バージョン管理・異常検知・行動評価をパイプラインに組み込む必要があります。RAGドキュメントも運用中に継続的に変更されるため、学習データと同レベルで出所と整合性を管理する必要があります。
3. RAGとベクトルストアの境界: LLM08
ベクトル・埋め込みの弱点は、埋め込みの生成・保存・検索プロセスで発生する権限エラー、テナント間の情報漏洩、汚染されたドキュメントの検索、埋め込みの逆転、知識の衝突を扱います。RAGを導入したからといって、回答が自動的に安全になるわけではありません。汚染されたドキュメントがより正確に検索されたり、他のユーザーのドキュメントがコンテキストに挿入されたりすると、かえって攻撃経路が短くなります。
権限チェックは、検索後にモデルに任せるのではなく、検索クエリの段階で適用する必要があります。ユーザー・組織・ドキュメントの等級でパーティションを分け、権限フィルターが適用された結果のみをモデルに渡すべきです。ドキュメント収集パイプラインには、出所認証、隠しテキスト検査、悪意のあるコンテンツの隔離、変更監査を追加します。
4. 出力とサブシステムの境界: LLM05, LLM09
LLM05 不適切な出力処理 — モデル出力も非信頼入力である
不適切な出力処理は、モデルが生成した文字列を検証せずにブラウザ、シェル、SQL、ファイルパス、メールテンプレート、または他のAPIに渡す場合に発生します。モデル出力はユーザー入力の影響を受けるため、実質的に下流システムにとってはもう一つの非信頼入力です。
HTMLにはコンテキストに応じた出力エンコーディングとCSPを適用し、SQLにはパラメータ化されたクエリを使用し、シェルコマンドは許可された構造に制限する必要があります。ツール呼び出しは自由形式のテキストを実行せず、厳格なスキーマ検証とポリシーチェックを通過した構造化された引数のみを受け入れるべきです。
LLM09 誤情報 — もっともらしさと事実性は異なる
誤情報は、モデルが間違った、または根拠のない内容をもっともらしい文章で生成するリスクです。ハルシネーションだけでなく、偏った学習データ、古くなった情報や不完全な情報、ユーザーの過信も影響を増大させます。攻撃者がいなくても、法律・医療・財務・セキュリティ判断で誤った回答が自動処理されると被害が発生する可能性があります。
信頼できる資料に基づいたRAG、出所表示、主要フィールドの自動検証、高リスク結果の専門家レビューが必要です。「AIが生成した」という表示だけで終わらせず、どのような用途まで許容されるのか、検証責任は誰にあるのかをユーザーインターフェースで明確に伝えるべきです。
5. ツールとリソースの境界: LLM06, LLM10
LLM06 過剰な権限 — 機能・権限・自律性をそれぞれ減らす
過剰な権限は、モデルやエージェントが必要以上の機能、権限、または自律性を持ち、予期せぬタスクを実行するリスクです。メール要約機能に送信・削除権限まで与えたり、照会タスクにデータベース修正権限を使用したり、高リスクなタスクをユーザーの承認なしに実行する構成が代表的です。
ツールリストと機能を最小限に抑え、ユーザーごとのOAuthスコープと下流システムの実際の権限で制限する必要があります。送金、削除、外部送信、デプロイなど影響の大きいタスクは、実行直前に人間の明示的な承認を得るべきです。認可決定は、モデルの文章やシステムプロンプトではなく、下流システムがリクエストごとに再度検査する必要があります。
LLM10 リソースの無制限消費 — トークンコストもセキュリティ境界である
リソースの無制限消費は、過度な入力と繰り返しリクエスト、長いエージェントループ、コストのかかるツール呼び出しによって、サービス拒否、コスト枯渇、性能低下、またはモデル抽出が発生するリスクです。クラウド推論の従量課金制構造では、サーバーが停止しなくても請求額が急増する「Denial of Wallet」が現実的な影響となります。
ユーザー・組織・APIキーごとにリクエストレートとコスト制限を設定し、入力・出力トークン、実行時間、ツール呼び出し回数、エージェントの最大ステップ数、キュー長を制限する必要があります。コストと遅延の異常兆候を監視し、制限を超えた場合は全体障害ではなく機能を縮小してサービスを提供するグレースフルデグラデーションも準備します。
リスクは単独で発生しない
実際の事故では、複数の項目が連鎖的に発生します。例えば、攻撃者がRAGドキュメントに隠された指示を挿入すると、LLM04 データ・モデル汚染とLLM08 ベクトル・埋め込みの弱点が起点となります。検索された指示がモデルの行動を変えるとLLM01 プロンプトインジェクションにつながり、検証されていない出力がツールに渡されるとLLM05が、ツールが過剰な権限で実行されるとLLM06が被害を拡大させます。その結果が機密データ漏洩であれば、LLM02までつながります。
したがって、「プロンプトインジェクション検出率」だけを高める方法では、全体のリスクを説明できません。攻撃が1つの層を通過しても、次の層で停止するように独立した制御を重ねる必要があります。
6つの境界に制御を配置する方法
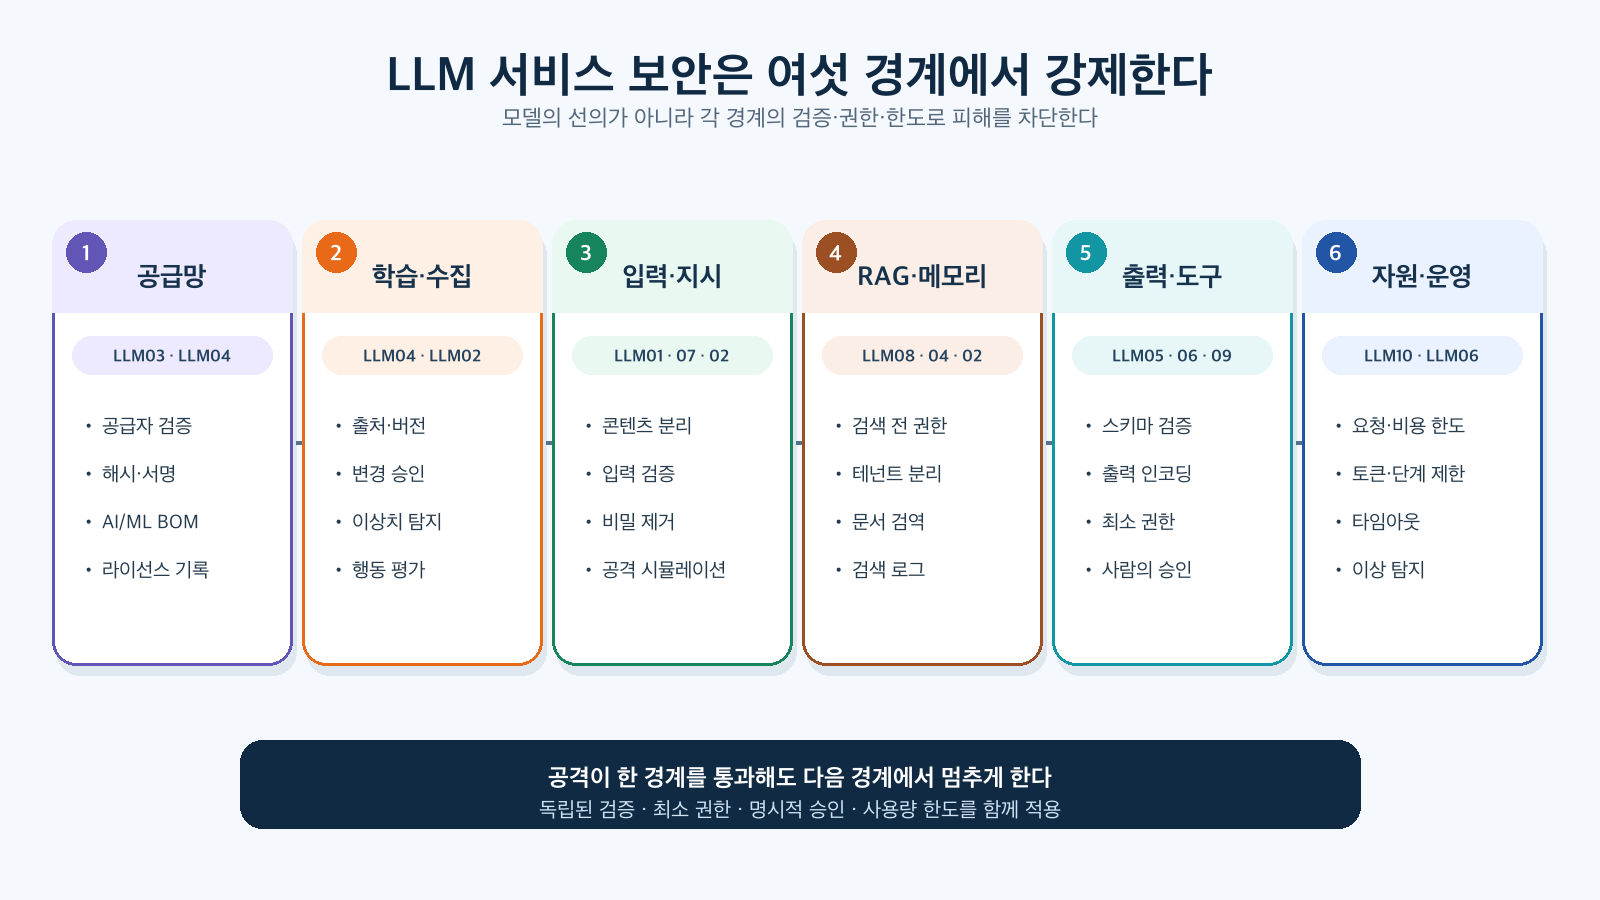
図: OWASP LLM Top 10を6つの防御境界に再構成 · OWASP 2025 LLM Top 10の予防・緩和項目に基づいて再構成
| 境界 | 優先制御 | 主に軽減するリスク |
| — | — | — |
| サプライチェーン | サプライヤー検証、モデル・データハッシュと署名、BOM、ライセンス記録 | LLM03, LLM04 |
| 学習・収集 | データ出所・バージョン管理、異常検知、変更承認、行動評価 | LLM04, LLM02 |
| 入力・指示 | 非信頼コンテンツ分離、入力検証、機密情報マスキング、攻撃シミュレーション | LLM01, LLM07, LLM02 |
| RAG・メモリ | 検索前権限フィルター、テナント分離、ドキュメント隔離、検索ログ | LLM08, LLM04, LLM02 |
| 出力・ツール | スキーマ検証、コンテキスト別エンコーディング、最小権限、ユーザー承認 | LLM05, LLM06, LLM09 |
| リソース・運用 | レート制限、トークン・コスト・ステップ制限、タイムアウト、異常検知 | LLM10, LLM06 |
実務では、まずデータフロー図を作成し、各矢印に信頼レベル、データ等級、呼び出し主体、認証方式、最大コスト、失敗時のデフォルト動作を書き込むことをお勧めします。この情報がない接続は、通常、セキュリティ要件も欠落しています。
よく混同される4つの項目ペア
LLM01とLLM07
LLM01は入力がモデルの行動を変える攻撃手法であり、LLM07はシステムプロンプトの内容がユーザーに漏洩するリスクです。システムプロンプトの抽出がプロンプトインジェクションによって起こる可能性はありますが、両項目の焦点は異なります。
LLM05とLLM06
LLM05はモデル出力に対する検証・エンコーディング・処理が不十分な問題です。LLM06はモデルが使用できる機能、権限、自律性が過剰な問題です。出力検証を行っても、削除ツールに管理者権限を与えればLLM06は残ります。
LLM03とLLM04
LLM03は外部サプライヤーとモデル・ライブラリ・データセットの出所と依存性を見るサプライチェーンの観点です。LLM04はデータやモデルが実際に操作され、整合性が損なわれる現象に焦点を当てています。
LLM08とLLM09
LLM08はRAGとベクトルストアのアクセス制御、検索、埋め込み、データ整合性の問題です。LLM09は最終回答の事実性とユーザーの過信の問題です。検索権限が正確であっても、モデルが根拠を誤って解釈すればLLM09が発生する可能性があります。
デプロイ前の最小チェックリスト
- システムプロンプトにAPIキー、資格情報、実際の権限ルールが含まれていないか
- ユーザー入力と外部ドキュメントがシステム指示と明確に分離されているか
- RAG検索前にユーザー・テナント・ドキュメント等級の権限が適用されているか
- モデル・LoRA・データセット・ライブラリの出所、ハッシュ、バージョン、ライセンスを追跡しているか
- モデル出力がHTML、SQL、シェル、ファイルパス、ツールスキーマに合わせて再検証されているか
- ツールは必要な機能と権限のみを持ち、高リスク作業には人間の承認が必要か
- 重要な回答は根拠リンク、自動検証、または専門家レビューを経ているか
- リクエスト速度、トークン、コスト、実行時間、エージェントステップ、ツール呼び出し回数に上限があるか
- 攻撃入力、汚染ドキュメント、誤った検索、ツール失敗、コスト急増をログとアラートで監視できるか
まとめ
OWASP LLM Top 10 2025を貫く原則は単純です。モデルを信頼境界として使用せず、モデルの入力と出力をすべて非信頼データとして扱い、実際の権限とコストはモデルの外で制御すべきです。
10項目を個別に覚えるよりも、サプライチェーン → 学習 → 入力・RAG → モデル → 出力 → ツール・リソースへと続く一枚のデータフローに配置することで、見落とされた制御がより早く見つかります。プロンプト防御、データ整合性、権限ベースの検索、出力検証、最小権限、リソース制限が連携して機能するとき、初めてLLMアプリケーション全体のリスクを低減できます。
コメントを残す