Attentionは、QueryとKeyの関連度スコアを計算した後、その比率でValueを混ぜる演算です。Q・K・Vを作成する線形層には、重みだけでなくbias、つまり入力とは別に加えられる学習可能なベクトルが含まれることがあります。
Qにbiasを加えることと、すべてのKに同じbiasを加えることは似ているように見えますが、基本的な内積Attentionではsoftmaxに与える影響が異なります。共通のK biasは、あるQueryのすべてのスコアを同じ値だけ移動させ、Q biasはKeyに応じて異なる値を加えることができます。 softmaxは前者の共通移動を打ち消しますが、後者の相対的な差は反映します。
Q・K・VとKV Cacheの説明に続き、本稿ではこの一つの違いを数式と小さな数値で検証します。実際のLLMやPyTorchモデルを実行した結果ではなく、位置変換のない基本的なScaled Dot-Product Attentionを対象とします。
AIで生成した概念イメージです。実際の画面や測定結果を示すものではありません。
1. 何に加えられるbiasなのかをまず区別する
トークンの現在の表現をxとするとき、説明に用いるQとKは以下の通りです。
qᵢ = xᵢWQ + bQ
kⱼ = xⱼWK + bKbQとbKはそれぞれの投影結果ベクトルに加えられます。同じHead内で同じK線形層を通過したトークンは同じbKを受け取るという条件です。PyTorchのLinearも、入力に重み変換とbiasを加える層として説明されます。行列を保存する方向によってドキュメントの転置表記が異なる場合がありますが、ベクトルに共通のbiasを加えるという点は同じです。 PyTorch Linear
これは、QとKの内積を計算した後にスコア行列に加えるattention biasとは区別されます。マスクや相対位置スコアは後のスコア行列に加えられることがあり、名前にbiasが含まれているからといって同じ項としてまとめることはできません。
基本的な計算は以下の通りです。
sᵢⱼ = qᵢ · kⱼ / √dₖ
pᵢⱼ = exp(sᵢⱼ) / Σⱼ exp(sᵢⱼ)
출력ᵢ = Σⱼ pᵢⱼ vⱼdₖはKeyベクトルの次元です。softmaxはQuery一つのスコア行を正規化します。したがって、「定数」という言葉も行列全体で同じ数字という意味ではなく、Queryを固定した一行でKeyによって変化しない数字を意味します。 Attention Is All You Need, 3.2.1
2. すべてのKに同じベクトルを加えるとスコア差が維持される
biasを加える前のKeyをkⱼ⁰と書きます。Query qᵢを固定すると次の式が成り立ちます。
qᵢ · (kⱼ⁰ + bK) / √dₖ
= qᵢ · kⱼ⁰ / √dₖ + qᵢ · bK / √dₖ後ろのqᵢ · bK / √dₖにはKey位置jがありません。したがって、一行のすべてのスコアに同じcᵢが加えられます。二つのKey間の差はそのままです。
(s₁ + c) - (s₂ + c) = s₁ - s₂softmaxでも同じ項が約分されます。
exp(sⱼ + c) / Σₜ exp(sₜ + c)
= exp(c)exp(sⱼ) / [exp(c)Σₜ exp(sₜ)]
= exp(sⱼ) / Σₜ exp(sₜ)これから得られる結論は、与えられた基本計算において共通のK biasだけを変更してもsoftmaxの重みは同じであるということです。スコア自体が同じであるという説明ではありません。Queryが異なればcᵢも異なる可能性がありますが、それぞれの行における共通移動という性質は維持されます。
3. Q biasはKeyごとに異なるスコア変化を生み出すことができる
bias前のQueryをqᵢ⁰と書くと以下の通りです。
(qᵢ⁰ + bQ) · kⱼ⁰ / √dₖ
= qᵢ⁰ · kⱼ⁰ / √dₖ + bQ · kⱼ⁰ / √dₖ後ろの項はkⱼ⁰によって変化します。Qに同じベクトルを一つ加えたとしても、異なるKeyと内積すると各スコアの変化が同じである必要はありません。これが共通K biasとの違いです。
QとKの両方にbiasがある場合、内積を四つの項に分けることができます。
(qᵢ⁰ + bQ) · (kⱼ⁰ + bK)
= qᵢ⁰·kⱼ⁰ + bQ·kⱼ⁰ + qᵢ⁰·bK + bQ·bKqᵢ⁰·bKとbQ·bKは一行でKeyによって変化しません。相対スコアに影響を与える可能性のある追加項はbQ·kⱼ⁰です。スケール√dₖで割ってもこの区別は変わりません。
ただし、Q biasが常に重みを変更するわけではありません。bQが0であるか、すべての許容されたKeyとの内積が同じであれば、追加項も共通移動となります。正確な表現は「Q biasはKey間の相対スコアを変更できる」です。
相対スコアの変化は二つのKeyの差として読み取る
Q biasによって第一と第二のKey間に生じる追加スコア差はbQ · (k₁⁰ − k₂⁰) / √dₖです。この値が0であれば、その二つのKeyの相対スコアはそのまま維持され、0でなければ相対的な比重が変わる可能性があります。「Q biasが追加された」という事実よりも、比較するKeyの差と内積してみる方が正確です。
基本的なsoftmaxの比率からも同じ結論を読み取ることができます。二つの重みがすべて有限のスコアから計算された場合、p₁ / p₂ = exp(s₁ − s₂)です。すべてのスコアに同じ数を加えると差が維持され、Keyごとに異なる値を加えると差が変わる可能性があります。後ろの数値表はこの関係を直接確認する例です。
4. 2次元ベクトルで直接検証する
次に、小さな合成数値を使用します。
q  = (1, 0)
k₁ = (1, 0), k₂ = (0, 1), k₃ = (-1, 0)
bQ = (0, 1)
bK = (3, -2)
dₖ = 2
Q biasを加えるとQueryは(1, 1)になります。第一と第二のKeyのスコアが等しくなり、第三は低いスコアを維持します。共通K biasはQuery (1, 0)と内積したときにすべてのスコアに3/√2、約2.121320を加えます。
以下はPython標準ライブラリで計算した実際の結果を小数点以下6桁に丸めた表です。
| 条件 | softmax前のスコア (s₁, s₂, s₃) |
softmax重み (p₁, p₂, p₃) |
|---|---|---|
| biasなし | (0.707107, 0, -0.707107) |
(0.575975, 0.283995, 0.140029) |
| Q biasのみ追加 | (0.707107, 0.707107, -0.707107) |
(0.445808, 0.445808, 0.108383) |
| 共通K biasのみ追加 | (2.828427, 2.121320, 1.414214) |
(0.575975, 0.283995, 0.140029) |
| Q・K biasすべて追加 | (1.414214, 1.414214, 0) |
(0.445808, 0.445808, 0.108383) |
第一行と第三行はスコアが異なりますが、重みは同じです。第二行と第四行も同じ関係です。共通K biasが存在するという事実だけでは、どのValueにより多くの比重がかかるかは変わりませんでした。固定されたVを混ぜる出力も、この条件では同じ重みで計算されます。
数値計算には最大スコアを引くsoftmaxを使用しました。これも同じ共通移動不変性を利用して大きな指数値を避ける方法です。
def softmax(xs):
    peak = max(xs)
    exps = [math.exp(x - peak) for x in xs]
return [x / sum(exps) for x in exps]添付のverify_attention_bias.pyを実行すると、入力、スコア、重みがresults.jsonに保存されます。
python3 verify_attention_bias.py --output results.jsonPython 3.9.6で8つの検証すべてが合格しました。基本スコア、Kの共通移動、softmaxの維持、Qの相対スコア変化、そして両方を加えた結果を確認しました。他のQuery行、Q biasの効果がない例外、トークンごとに異なるK移動が共通移動条件外であるという対照も含まれます。比較許容誤差は相対・絶対誤差それぞれ1e-12であり、上記の合成数値における基本重みとK bias重みの最大差は実際に0.0でした。
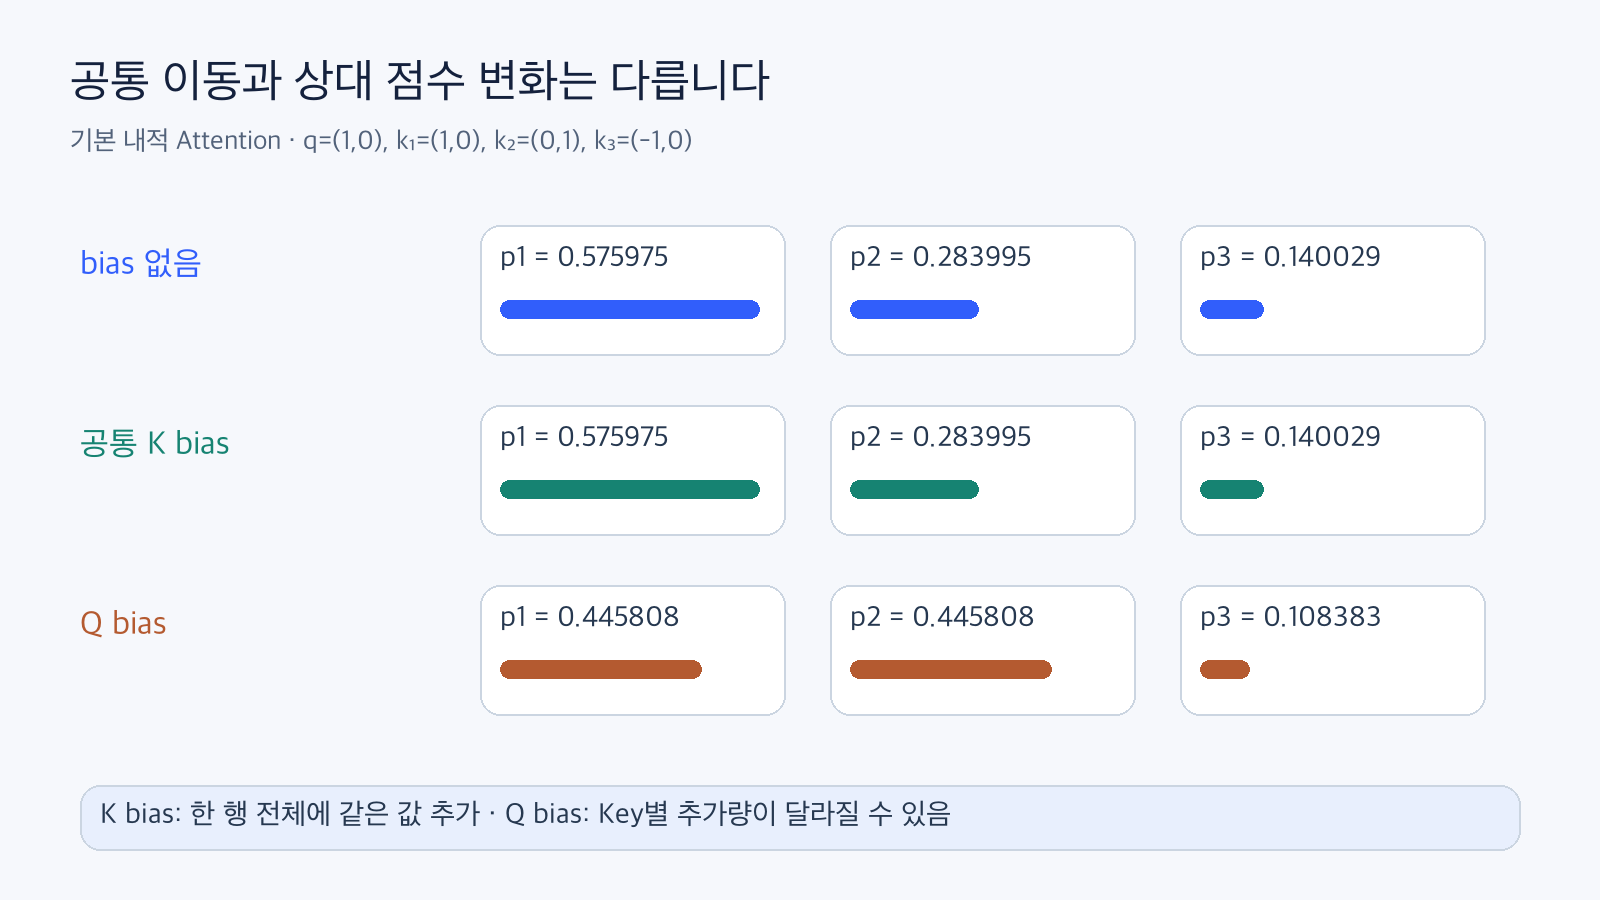
図:本文の合成数値におけるsoftmax重みの比較。公式ドキュメントに基づいて再構成されており、実際のモデルの性能測定ではありません。 公式根拠1 · 公式根拠2
5. この結論を適用できる境界を守る
今回の検証は、一つのHeadで同じ次元のQueryとKeyを内積し、同じbKをすべてのKeyに加えた後、行ごとのsoftmaxを計算したものです。dropout、量子化、GPUカーネルやモデル学習結果は測定していません。実数の数学的不変性と浮動小数点実装における誤差も区別する必要があります。
特にRoPE、つまり位置に応じてQ・Kベクトルを回転させるRotary Position Embeddingにこの結論を直接拡張することはありません。共通biasを加えた後、各位置で異なる回転をさせる構成であれば、回転後の追加項が依然としてすべてのKeyに共通であるかを再計算する必要があります。RoPE論文は位置を回転行列で反映する方法を説明しています。今回のコードにはその演算はなく、RoPEモデルに対する判定もありません。 RoFormer論文
Keyごとの追加ベクトル、Q・K正規化のような他の変換、スコア段階の相対位置項も適用箇所と式を確認する必要があります。PyTorchのAttentionの例でも、QK内積、スコアに加える項、softmax、dropout、Vとの積は互いに区別された段階です。 PyTorch Scaled Dot-Product Attention
この計算を「すべてのTransformerでK biasを削除してもよい」というモデル変更の推奨として解釈することはできません。確認した結論は、限定された式の性質です。ベクトルに何が加えられたかよりも、最終的なスコア行でKey間の差が変わるかどうかを見ることで、QとK biasの効果を区別できます。
コメントを残す