AIOps是Artificial Intelligence for IT Operations的缩写,即一种利用AI辅助IT运营数据分析和响应的方法。它可以用于聚合警报、查找潜在原因或执行预设操作。然而,“看起来异常”、“这可能是原因”和“现在可以更改”是不同的判断。
假设购物网站的API变慢,数据库连接利用率也上升了。虽然AI将两者关联起来进行解释很有用,但仅凭这种解释就重启数据库或无条件扩展应用程序可能会使问题恶化。所需的是一种操作设计,将观测结果与证据关联起来,并通过单独的批准、权限和恢复条件来限制可执行的操作。
本文基于2026年10月15日确认的AWS AIOps说明和Google SRE的监控原则,整理了这些边界。购物网站以及所有指标、时间、设置均为说明用的合成示例,不代表实际的实施经验或故障恢复业绩。
封面图片:AI生成的概念图。并非实际仪表板或服务配置的再现。
1. 首先,区分观测、原因候选和执行决策
AWS将AIOps描述为一种通过分析来自多个来源的数据来提高运营效率的方法,并介绍了观测、专家判断与协作、以及行动的流程。由于可以利用机器学习和自然语言处理等技术,因此不一定只意味着采用单一的对话式语言模型。AWS AIOps 概述
在应用于运营时,最好将此流程理解为三个具有不同权限的阶段。第一阶段是收集当前正在发生的事情。第二阶段是比较哪种解释最能说明观测结果。第三阶段是根据该解释更改实际系统。
例如,“商品查询的P95延迟增加了”是一个观测结果。P95是将请求延迟按从小到大排序时大约95%位置的值,是衡量较慢请求状态的指标。“数据库连接竞争可能导致了延迟”是一个原因候选。 “回滚之前的更改”是一个操作建议。即使观测结果正确,候选原因也可能错误;即使候选原因正确,该操作是否安全的结论也需要单独验证。
如果之前的OTel和LGTM文章解释了如何关联数据,那么本文则侧重于如何根据什么证据将关联的信息与行动联系起来。明确判断的转换点是起点,而不是重建收集结构。
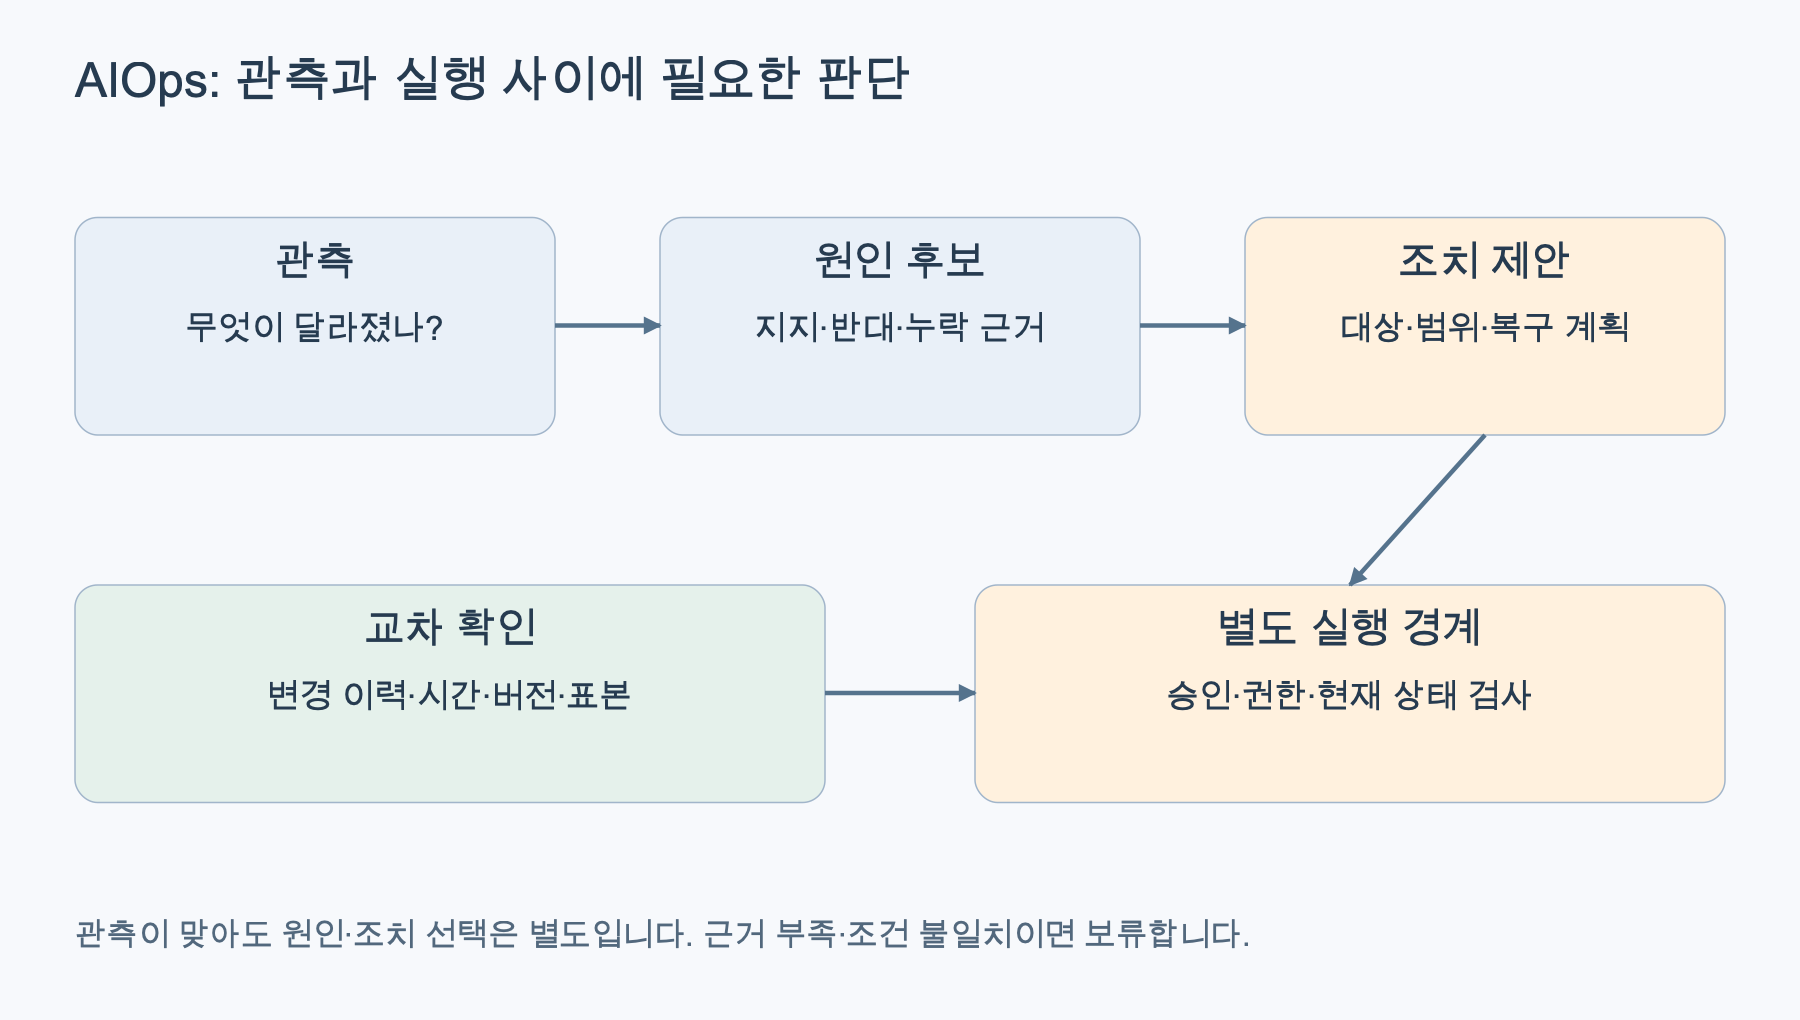
图1. 将观测、候选审查和操作划分为不同权限阶段的概念图。根据AWS AIOps 概述和Google SRE 监控等官方文档重新构建。原因候选不会自动获得执行批准。
2. 日志、指标和追踪回答不同的问题
日志显示特定时间点的事件,指标显示一段时间内的数值和分布,追踪显示请求经过多个处理阶段的路径。通过同时查看这三种数据,可以缩小同一时间段内的变化与哪些请求和组件相关联。然而,每种数据都有不同的聚合时间、样本范围和记录缺失。
假设在虚拟商品查询API中观察到以下变化。每个数值都是针对相同长度的比较区间生成的,不代表特定服务的推荐阈值。
| 检查项 | 之前区间 | 延迟增加区间 | 下一个问题 |
|---|---|---|---|
| 成功请求P95延迟 | 180ms | 900ms | 在哪个路径和部署版本中增加了? |
| 外部API请求量 | 每秒300次 | 每秒310次 | 仅凭用户需求能否解释变化? |
| 数据库连接利用率 | 45% | 90% | 连接上限/测量对象是否相同? |
| 连接获取等待 | 几乎没有 | 等待增加 | 哪个应用实例在等待? |
| 数据库CPU利用率 | 35% | 40% | 除了CPU,是否存在锁、I/O或连接限制? |
| 变更历史 | 重试1次设置 | 重试3次设置部署 | 该路径的数据库调用尝试次数是否增加了? |
对于数据库连接利用率,需要确认分母是什么。其含义会根据是基于数据库服务器允许的连接数还是应用程序连接池的上限而有所不同。仅查看整个服务的平均值可能会错过特定实例的等待情况。
在此示例中,追踪用于区分商品查询等待连接的区间和执行查询的区间。在日志中,我们查找相同部署版本的重试和连接等待相关事件。我们不将原始日志完整地发送给模型,而是定义数据范围,只提供去除识别信息的聚合数据和必要的区间。
Google SRE将用户视角的延迟、流量、错误和饱和度作为重要信号。除了查看平均延迟,还应区分成功和失败请求的延迟,并同时观察资源饱和度。区分症状和原因
在合成示例中,可能有多种解释。重试次数增加可能导致数据库请求量增加,或者长时间事务可能长时间占用连接。还可能同时存在连接释放问题或网络延迟。数据库CPU没有显著上升的观测结果,仅仅削弱了CPU不足的解释,并不能证明整个数据库都正常。
对于AI而言,让它整理每个候选原因的证据比只给出一个结论更有用。例如,可以像下面这样请求。以下语句是用于分析合成数据的编写示例,并非授予实际操作工具执行权限的指令。
제공한 합성 지표와 변경 이력만 사용해 원인 후보를 정리해 주세요.
각 후보마다 지지하는 관측, 아직 없는 근거, 반대 근거,
추가로 읽기 전용 확인할 항목을 구분해 주세요.
상관관계를 원인 확정으로 쓰지 말고 확인되지 않은 값은 만들지 마세요.
설정 변경이나 재시작은 실행하지 말고 별도 조치 제안으로만 남겨 주세요.
如果是重试候选,可以检查同一时间段内该代码路径的数据库调用尝试次数是否确实增加了。如果是长时间事务候选,则需要其他观测,例如锁等待或事务持续时间。记录哪些数据可以缩小哪些候选范围,将使人们更容易审查AI的解释。
即使模型给出的高置信度本身也不是验证结果。在缺少必要指标的情况下,语句可能显得武断。如果证据不足,设计应将其转交给额外的观测或人工审查,而不是提高执行级别。
4. 将变更历史放在同一时间轴上并匹配范围
变更后立即发生故障是一个重要线索。然而,不能仅仅因为是最近的部署就确定其为原因。部署时间和指标收集时间可能不同,并且在渐进式部署期间,新旧版本可能同时运行。
在合成示例中,我们只分离并查看重试设置已更改版本的请求。我们比较同一API的其他路径是否也出现了延迟,以及未接收更改的实例中连接等待是否增加。我们还会检查同一时间是否有重叠的变化,例如需求增加或数据库维护。
在向AI传递变更历史时,也应具体说明目标服务、版本、配置项和应用范围,而不仅仅是说“今天有部署”。如果不确认哪些观测结果指向变更前后,以及时间戳和聚合区间是否匹配,则可能会将不同的事件归结为一个故事。
在操作摘要中,应将事实和解释分开记录。“新版本区间连接等待增加”是已确认的比较结果,而“重试次数增加可能产生了影响”是解释。应保持这种区分,以防止未经审查的候选原因在报告中变为确定的根本原因。
5. 为自动化操作附加目标、条件和限制
以下是将官方文档中的操作和权限原则应用于此示例的设计建议。这并不意味着特定的AIOps产品会自动提供所有这些功能。应将只读摘要、变更方案创建和受限执行划分为不同的功能,并分别为其设定允许范围。
例如,仅仅因为连接等待时间增加而持续添加应用程序实例,可能会因为每个实例创建的连接而增加数据库负担。与其仅仅使用“扩展”这样的操作名称,不如同时定义要更改的目标、单次更改的幅度、总连接预算以及等待下一次判断的时间。
即使是允许的操作也可能在同一目标上重复执行。当一个故障关联多个警报或重试持续发生时,必须检查执行ID和进度状态,以避免重复相同的配置更改。在中间失败后重试时,应首先读取已更改的状态。
权限应置于能够实际限制这些条件的执行层。与其以管理员权限运行模型自由生成的shell命令,不如设计成只传递经审查的操作流程允许的输入。AWS IAM也解释了最小权限原则,即将权限限制在任务所需的操作、资源和条件。IAM 安全最佳实践
读取审查记录的角色和更改服务的角色也应分离。摘要功能可以提出原因候选,但这并不意味着它也应该执行数据库配置更改或账户权限修改。必须分别定义可以读取的数据和可以更改的资源。
6. 批准与操作内容绑定,并在执行前再次确认
仅仅通过人工批准并不能完成执行边界。像“可以解决问题”这样宽泛的批准可能会被误解为即使目标或方法发生变化也仍然有效。最好在批准界面显示目标版本和资源、变更前后值、预期影响、确认依据和恢复方法。
批准与变更方案的版本绑定。如果批准后目标或参数发生变化,或者依据过时,则需要重新审查。由于在等待期间其他操作员可能已经采取了措施,因此在执行前应立即检查当前状态和正在进行的变更。
AWS Systems Manager Automation的aws:approve是一个示例,可以在工作流程中包含一个步骤来等待指定批准者的响应。拥有这样的批准步骤并不能自动确保原因判断或执行权限验证的准确性。批准、策略检查和执行角色的权限必须分别验证。Automation 批准操作
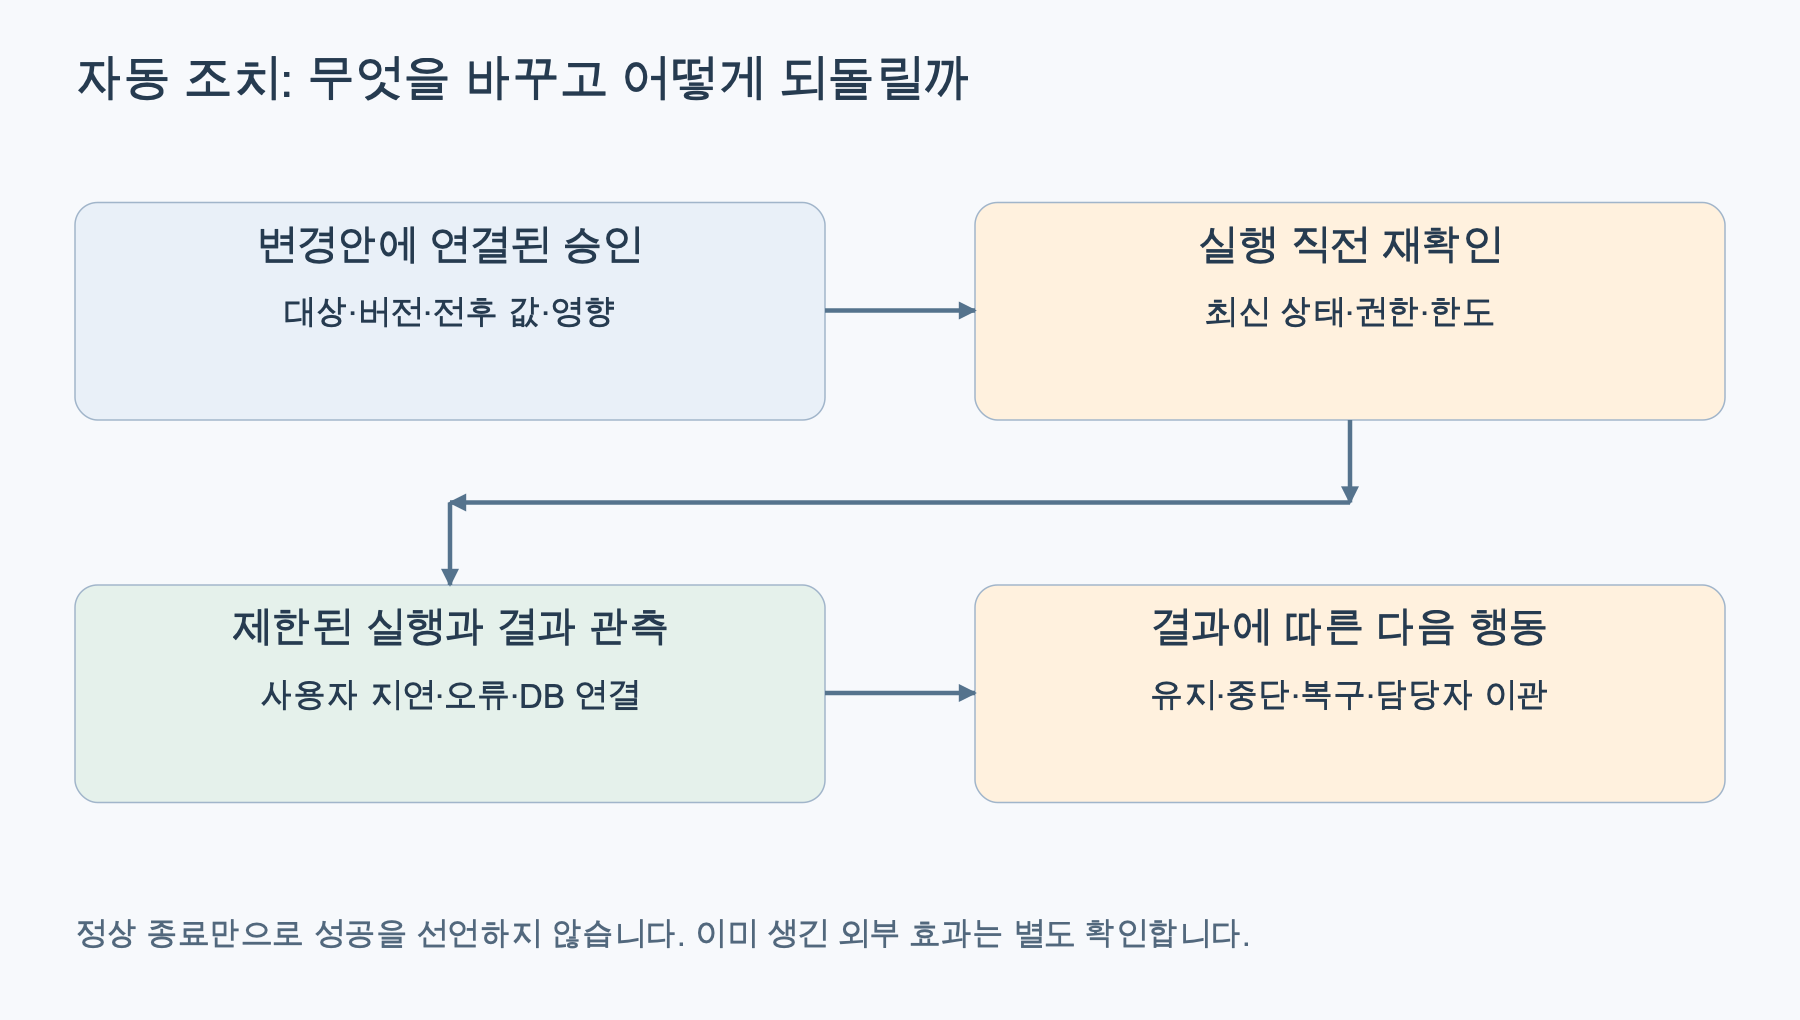
图2. 将已批准的变更方案与执行前状态检查、受限执行和结果观测相结合的操作设计。根据Automation 批准文档、IAM 权限原则和AWS 缓解部署风险等官方文档重新构建。在未经批准、状态不匹配或无法观测的情况下,将暂停执行。
7. 在变更前确定成功和回滚标准
操作成功与命令无错误完成是不同的。如果在合成示例中审查将重试设置恢复到先前值的变更方案,则需要一个计划来同时观测商品查询的延迟、错误率以及数据库连接等待/利用率。如果延迟减少但错误增加,则不能认为是期望的结果。
判定区间和最小请求量也必须事先确定。不应仅凭变更后短暂的平静期或几乎没有请求的区间来宣布恢复。这些数字应根据服务的负载特性和目标来确定,本文中的示例数值不应作为操作阈值复制。
回滚是恢复到先前状态的程序。应确保变更前的值和可恢复的版本,并确定在哪些失败信号下停止新操作。AWS Well-Architected也同时涵盖了变更结果的快速反馈、从不良结果中恢复、测试、安全部署和回滚。缓解部署风险
然而,并非所有操作都能以相同方式回滚。已处理的订单、已发送到外部的消息或数据更改不能仅仅通过恢复配置文件来撤销。对于影响较大的不可逆操作,应进一步缩小自动化范围并设置单独的确认。如果在恢复过程中观测本身中断,也需要设定条件将其转交给负责人,而不是重复额外的自动更改。
8. 实施顺序从只读比较开始
与其从一开始就以自动恢复为目标,不如在过去已审查的事件或合成场景中,检查AI会聚合什么以及会遗漏什么。确认原因候选是否附有证据,是否引入了不相关的变更,以及是否将未知信息标记为未知。
接下来,通过让AI生成建议并与现有操作判断进行比较来扩大范围。在评估操作时,生成候选的数量不如不必要的变更、误报响应、负责人审查负担以及故障是否可恢复重要。如果没有数据来衡量效果,则不应将运营成本节约或恢复时间缩短作为业绩。
之前的代理安全装置测试讨论了验证阻止实际工具调用的边界。在AIOps中,在该边界之前增加了一个操作判断:现在选择此操作是否有足够的依据? 即使是能够有效阻止执行的工具,也无法替代解决选择错误操作的问题。
9. 委托范围由运营合同而非模型的表达能力决定
AIOps的价值可以从聚合分散的信号并整理供人工确认的原因候选和证据开始。要连接到自动化操作,证据范围、目标、权限、限制、已批准的变更方案、结果判断和恢复方法必须相互关联。
购物网站API变慢和数据库连接增加的观测结果是一个起点。下一步不是获取重启数据库的命令,而是决定用哪些观测结果来缩小哪些候选范围,以及在什么条件下可以更改什么。当分别管理信任观测、判断原因和允许更改的任务时,也可以解释自动化的范围。
参考资料
官方资料确认日期:2026年10月15日。合成指标和运营设计示例是为了本文的说明而构建的。
发表回复