OpenTelemetry(简称OTel)是一个开放标准,用于以一种通用方式收集和传输应用程序生成的跟踪、指标和日志。简而言之,它是一种翻译规则,将不同机器各自使用的观察日志统一为相同的格式。
然而,在LLM服务中真正想看到的不仅仅是“模型API是否成功?”。您需要知道响应慢是因为搜索延迟,还是模型第一个token延迟,工具调用是否重试,或者是否检索了不相关的文档。如果只记录模型调用,就像只看到了漫长旅程的起点和终点,却不知道中间在哪里迷失了方向。
结论是,选择OTel作为LLM可观测性的基础符合当前的标准化趋势。但是,OTel的核心跟踪和指标体系与LLM专用的gen_ai.*规范的成熟度需要区分。前者已广泛稳定,而后者仍处于可能发生变化的发展阶段。LGTM并非取代此标准,而是用于存储和查询收集到的数据的典型开源后端组合。
一次用户请求经过搜索、模型、工具时,遥测技术连接整个旅程的景象。此图片是为本文新创建的。
LLM服务为何仅靠现有监控不足?
一般的Web API仅通过请求数、错误率、CPU、内存和响应时间就能发现许多问题。这些指标对于LLM系统仍然很重要。然而,LLM应用程序通常在一次请求中经历更多步骤。
假设用户询问“请告诉我我们公司的退款政策”。服务首先会检查认证和安全策略,将问题转换为嵌入,在向量数据库中查找相关文档,组合提示,然后调用模型。如果需要,还会执行内部API或外部工具,然后对答案进行后处理。
此时,屏幕上可能只显示“耗时8秒”。但运营人员需要的答案要具体得多。
- 搜索阶段是否耗时5秒?
- 模型发送第一个字符是否等待了很长时间?
- 工具调用是否失败并重试了三次?
- 是否回退到更昂贵的模型,导致token成本增加?
- 答案很快,但依据的是不相关的文档吗?
要回答这些问题,需要为每个用户请求附加相同的trace_id,并将其中的每个操作划分为span。Span可以简单理解为记录在整个旅程(Trace)中的“一段收据”。它包含开始时间、结束时间、成功状态以及模型、工具等属性。
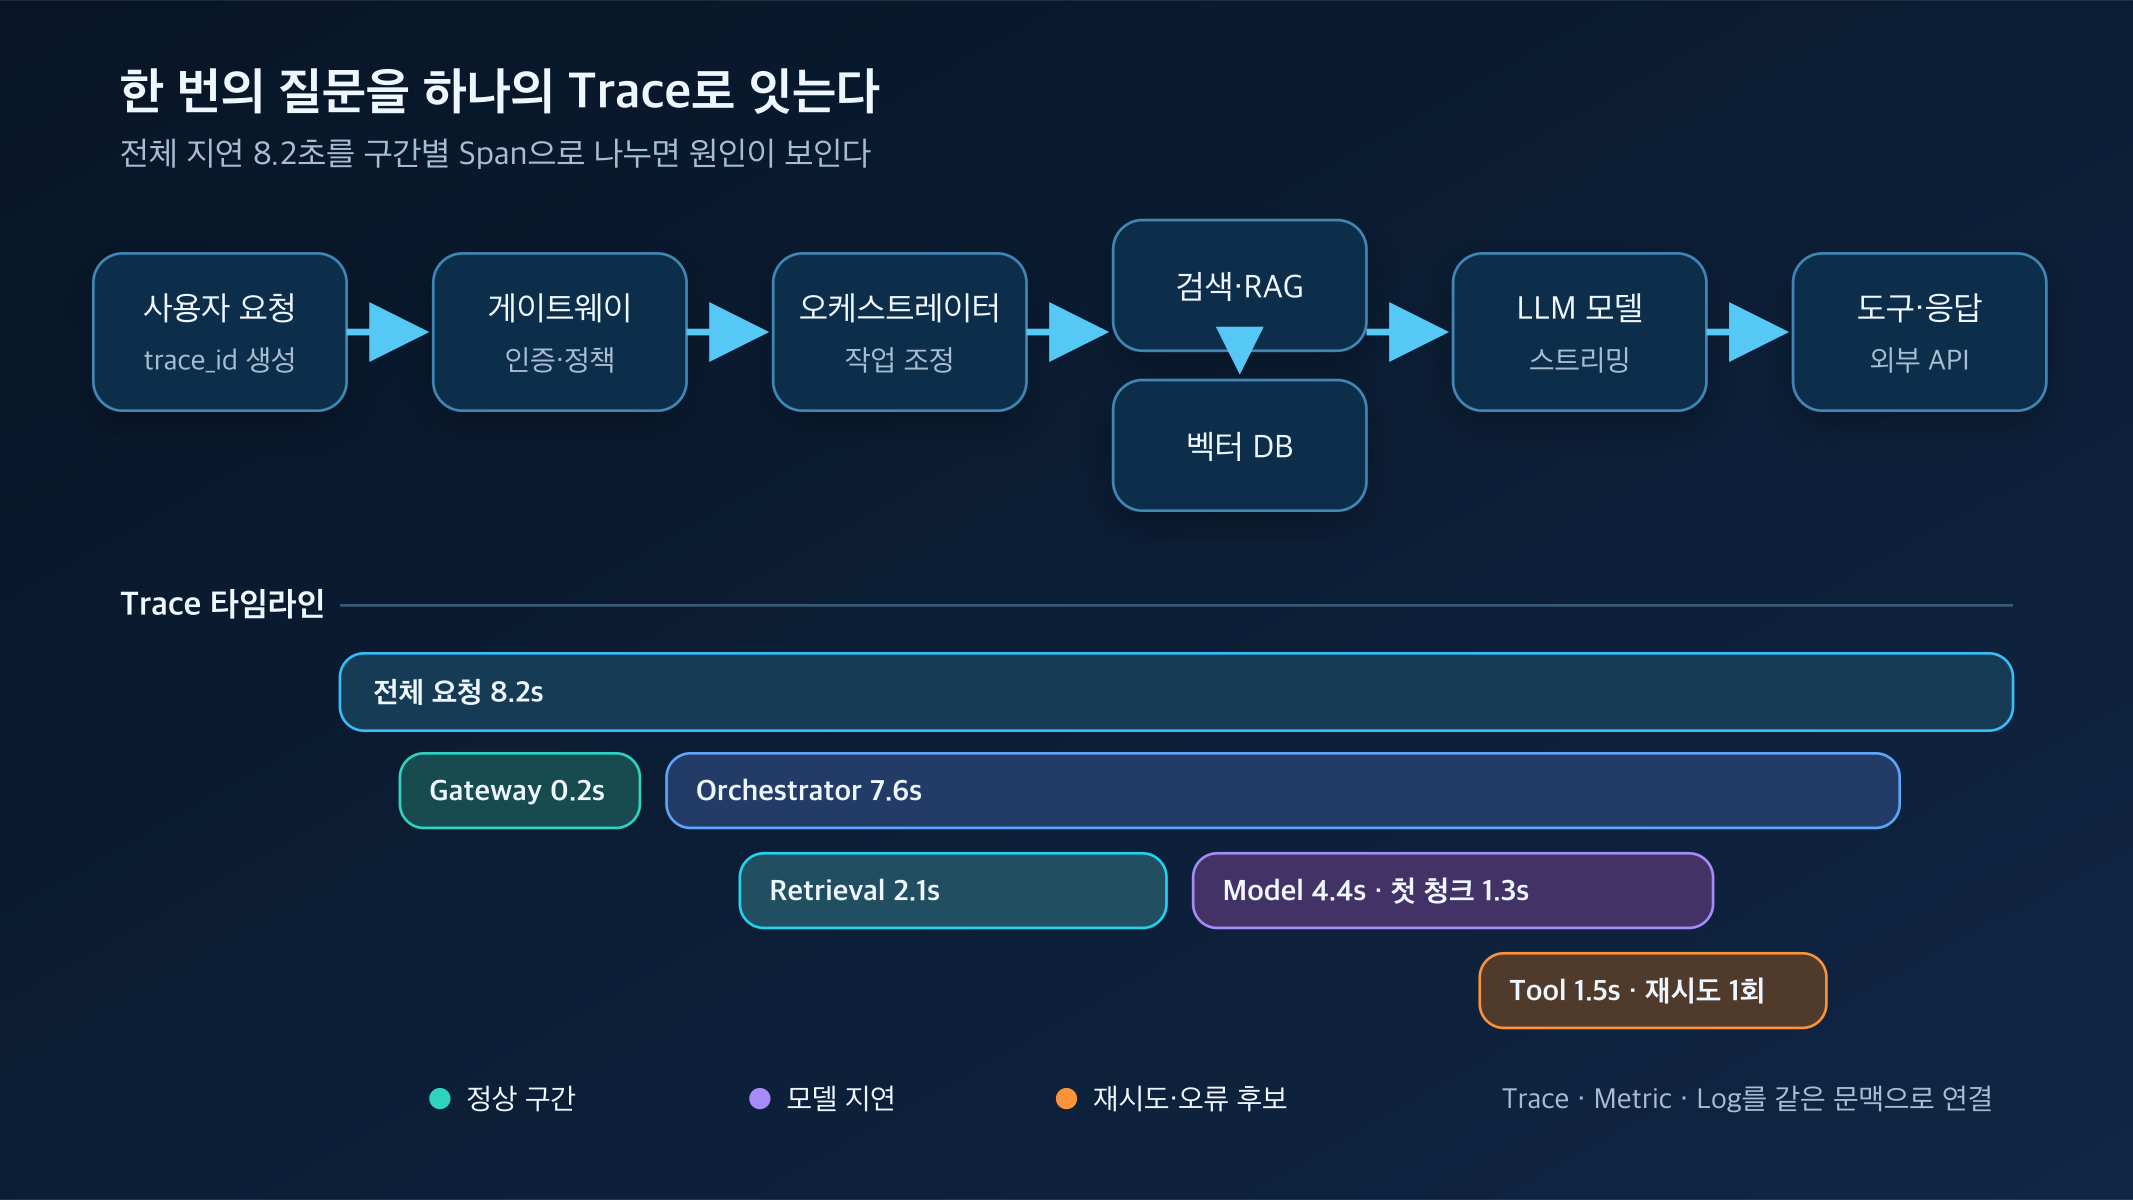
通过将一个请求连接成多个Span,可以分离出缓慢的 구간 和失败点。此图基于OpenTelemetry的Trace·Span概念和GenAI规范重新构建。依据:OpenTelemetry Trace概述,GenAI Span规范
OTel能做什么,不能做什么
OTel的核心作用不是创建数据查看界面。它提供了一种通用语言,使应用程序能够生成可观测性数据,以相同的上下文连接数据,并以供应商中立的方式传输数据。
OTel主要处理以下信号和连接上下文。
| 组成部分 | 简单含义 | LLM系统中回答的问题 |
| — | — | — |
| Trace | 一次请求的完整移动路径 | 在搜索、模型、工具中,哪里变慢了? |
| Metric | 按时间聚合的数字 | 错误率、P95延迟、token使用量变化了多少? |
| Log | 特定时间点的详细记录 | 发生了哪些错误和策略决策? |
| Baggage·Context | 服务之间共同传递的上下文 | 如何将多个进程的记录捆绑到同一个请求中? |
SDK或自动仪表化在应用程序内部生成数据。OTLP(OpenTelemetry Protocol)是发送这些数据的通用传输规则。OpenTelemetry Collector接收数据,进行批处理,过滤敏感属性,重试后将其导出到一个或多个后端。
因此,仅安装OTel并不能创建仪表板和长期存储。OTel是仪表化和传输层,而Tempo·Loki·Mimir等产品是存储和查询层。分离这些边界可以减少在更换后端时需要彻底修改应用程序仪表化代码的可能性。
LLM中应该观察什么
LLM监控不是“记录一切”,而是确定解释故障、成本和质量所需的最小信号。
1. 端到端延迟和首次响应时间
仅查看总响应时间会忽略流媒体服务的感知速度。用户可能对第一个token或第一个chunk何时出现比最后一个token何时到达更敏感。因此,需要将TTFT(Time to First Token)或到第一个chunk的时间与总操作时间分开查看。
当前的GenAI规范定义了表示操作时间、请求模型、响应模型、输入/输出token以及流媒体的第一个chunk时间等的属性和指标。但是,实际支持范围因语言和仪表化库而异,因此不要仅凭名称就假定会收集,而应在示例Trace中进行确认。
2. 模型·提供商·回退路径
请求的模型可能与实际响应的模型不同。路由器可能由于故障或超出限制而切换到其他提供商或更昂贵的模型。在Span中记录操作名称、提供商、请求模型、响应模型和错误类型,可以更容易地追踪“为什么成功率相同但成本增加了?”
token数量是估算成本的重要依据,但token数量本身并非金额。价格因提供商、模型、缓存策略和合同而异,因此将价格表和计算规则应用于单独的版本控制成本层更为安全。
3. RAG搜索和工具调用
不好的答案并非总是模型的错。搜索结果可能为空,检索到过时的文档,或者工具收到了错误的参数。对于RAG,连接搜索时间、结果数量、数据源、重新排序阶段和选定的文档标识符;对于工具调用,记录工具名称、延迟、成功状态和重试次数。
但是,原始文档和工具参数/结果不应无条件地放入通用Trace存储中。因为可能混入个人信息、公司机密和认证信息。在生产环境中,更适合的方式是内容存储在单独的、访问受控的存储中,并在Span中留下引用值或非识别标识符。
4. 质量和安全性
OTel擅长连接“此操作何时、何地、耗时多久执行?”。另一方面,“答案是否真实?”、“是否与依据一致?”、“对用户是否有用?”则需要应用程序特定的评估标准。
因此,最好不要将可观测性与评估(Evaluation)混为一谈。在线反馈、离线标准数据集、事实性/相关性评估和安全性检查应单独运行,但通过将评估结果与Trace或对话标识符关联,可以调查“质量下降的请求经历了哪些执行路径?”。OTel更像是连接不同证据的骨架,而非质量评估引擎。
那么OTel是当前的标准吗?
简短的回答是:作为可观测性数据的仪表化、上下文传播和传输基础,是的。OpenTelemetry通过整合OpenTracing和OpenCensus的流程而发展壮大,并于2026年5月成为CNCF毕业项目。主要语言的Trace和Metric API·SDK也普遍处于Stable状态,并且支持OTLP和Collector的开源·商业后端已广泛形成。
但这并不意味着“OTel的所有功能和所有属性名称都已永久固定”。
- 各语言的日志信号成熟度各不相同。
- Collector处于Mixed状态,不同组件的稳定性水平不同。
- 用于LLM·代理的GenAI Semantic Conventions正在单独的仓库中发展,并且Span·Event文档中仍保留Development状态。
- 实际的仪表化库对提供商和属性的支持范围各不相同。
因此,实际操作的结论是两句话:将OTel/OTLP作为新LLM平台的通用仪表化·传输规范是可行的。但是,对于gen_ai.*属性,应固定使用的规范版本和库,并在内部数据模型和仪表板之间设置一个薄的转换层,以应对未来的变化。
LGTM与OTel有什么关系?
LGTM是Loki、Grafana、Tempo、Mimir的首字母缩写。
- Loki存储和查询日志。
- Grafana探索和可视化来自各种数据源的数据。
- Tempo存储和查询分布式跟踪。
- Mimir长期存储与Prometheus兼容的指标。
也就是说,LGTM不是定义遥测含义和传输方式的行业标准。它是Grafana生态系统中一个后端组合,非常适合操作OTel生成的数据。即使选择OpenSearch、Elastic、Jaeger、Prometheus、云托管服务或商业可观测性平台,OTel层也可以保持不变。
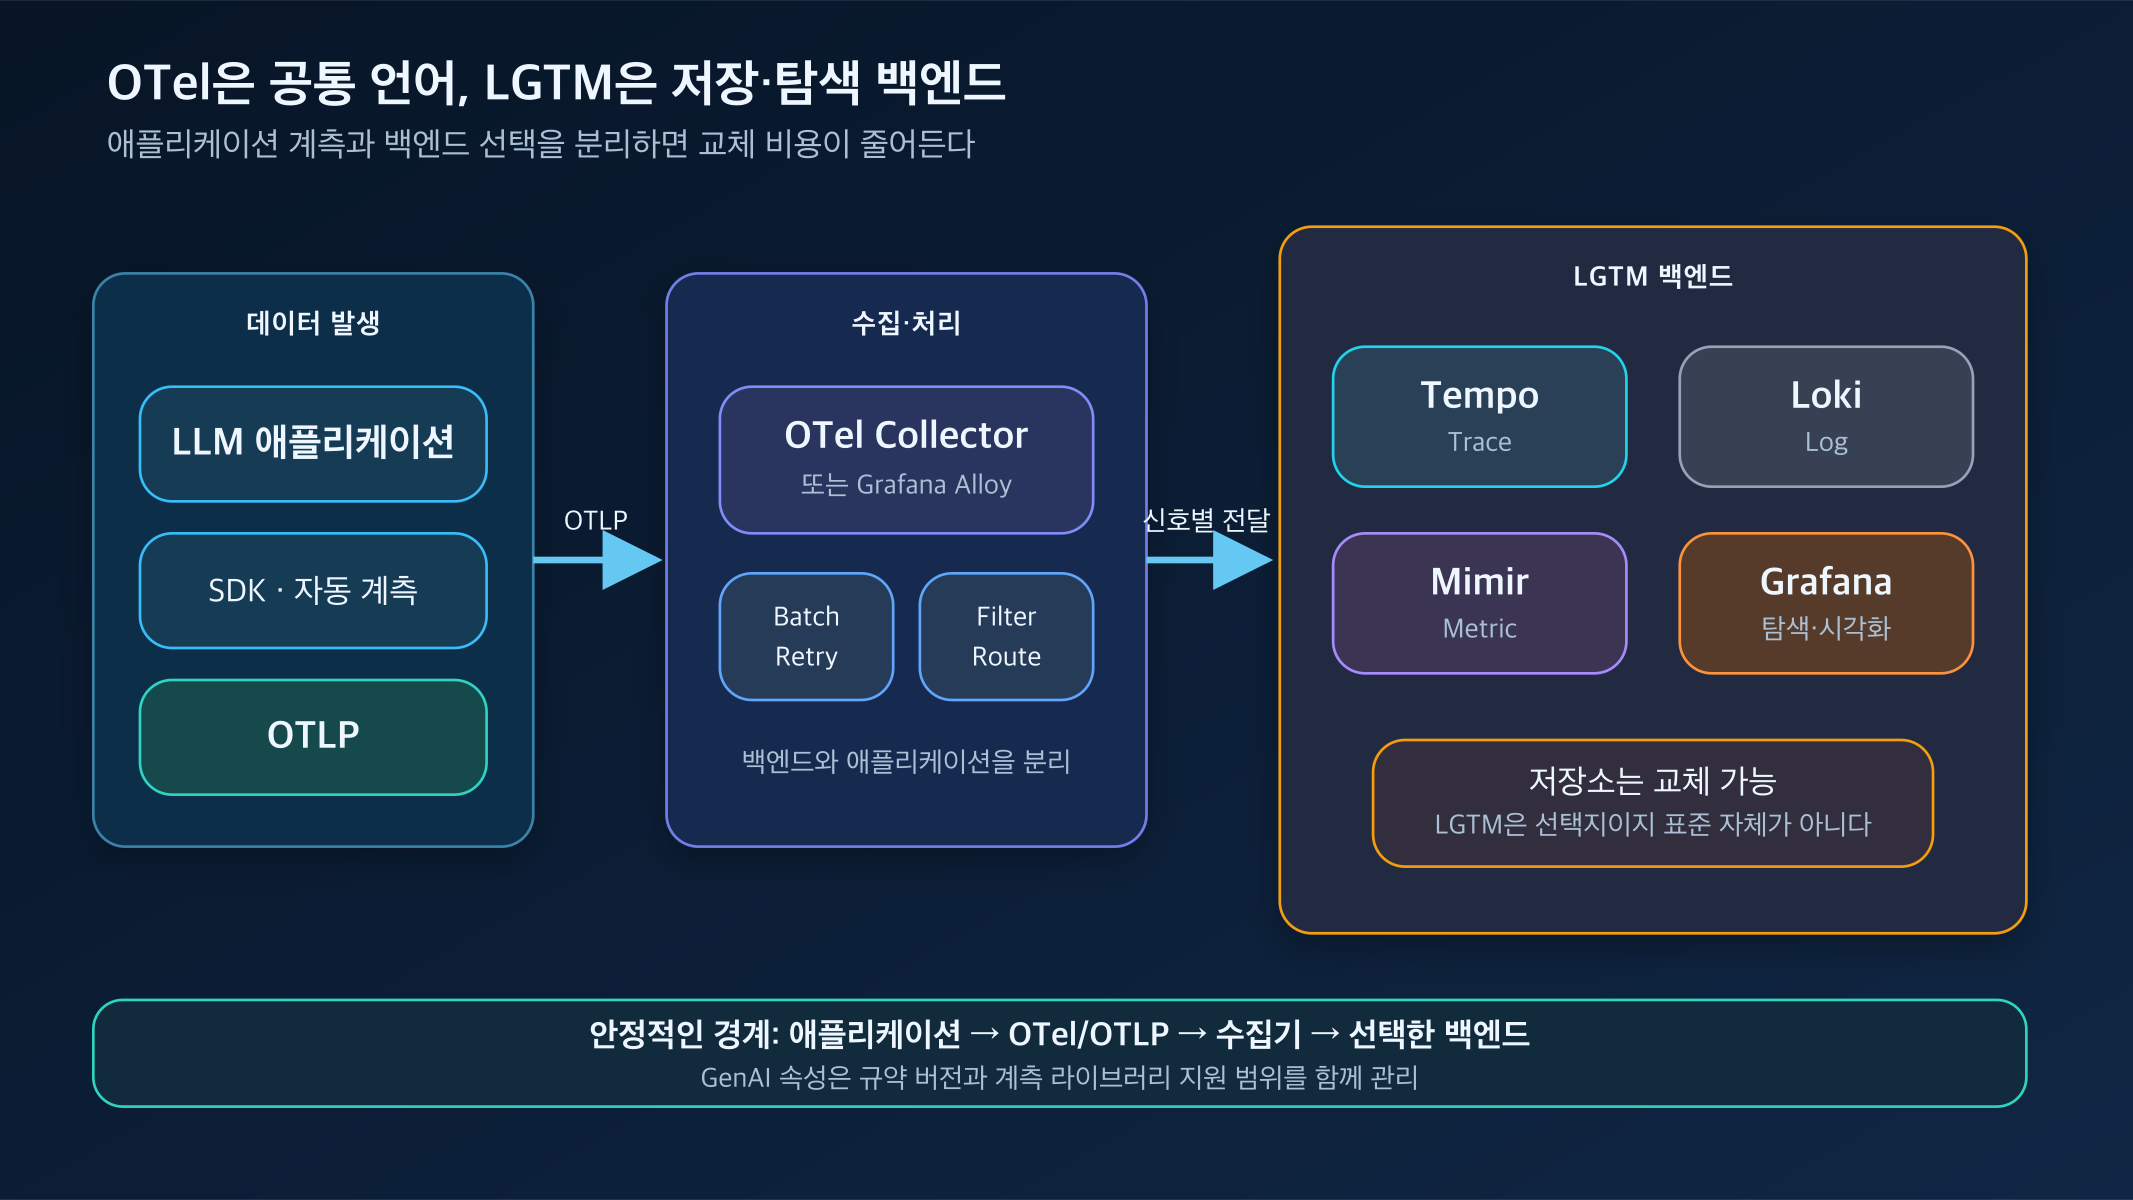
应用程序通过OTLP发送数据到Collector或Alloy,LGTM负责按信号存储和查询。此图基于Grafana官方文档重新构建。依据:Grafana Alloy工作原理,Docker OpenTelemetry LGTM
在收集层,可以使用纯粹的OpenTelemetry Collector,也可以使用Grafana Alloy。Alloy提供与OpenTelemetry Collector兼容的收集管道以及Prometheus·Loki生态系统的功能。如果以Grafana为中心进行运营,这是一个自然的选择,但这也不是OTel的必要组成部分。
在开发·演示环境中,Grafana提供的docker-otel-lgtm镜像可以一次性测试Collector、Grafana、Loki、Mimir、Tempo。官方文档也将其描述为开发·演示·测试用途,因此不应将该配置直接复制为大规模生产环境的正确答案。
实际操作中应按什么顺序开始?
从一开始就存储所有提示和所有Span会导致成本和安全问题。最好从以下小块垂直切片开始:
- 首先连接服务边界。确保相同的Trace上下文传递到API Gateway、LLM Orchestrator、Retriever、Model Client和Tool Runner。
- 确定运营问题。选择那些能实际改变行为的指标,例如P95总延迟、首次响应时间、按模型/提供商划分的错误率、输入/输出token、回退率以及搜索/工具失败率。
- 将OTLP出口统一。与其让应用程序直接知道后端地址,不如让Collector或Alloy负责批处理、重试、过滤和路由。
- 连接到LGTM或其他后端。保持trace_id、服务名称和环境属性的一致性,以便从Trace导航到相关的日志和指标。
- 通过实际故障进行验证。故意制造模型超时、搜索延迟、工具错误和回退,以确认它们出现在哪个Span中。
- 然后,连接质量评估。使低用户评价或事实性失败的请求能够通过Trace追溯其执行路径。
仪表板不应该是“绘制所有可用数据的地方”,而应该是快速做出运营决策的屏幕。例如,一个实用的结构是:在第一个屏幕上显示用户感知延迟、错误率、token使用量和回退率,当出现异常时,通过Trace深入查找搜索、模型、工具中的原因。
必须首先确定的安全和成本边界
LLM遥测可能比一般的Web日志更敏感。提示可能包含姓名、电子邮件、合同信息和源代码,模型响应或工具结果可能包含内部数据。
OpenTelemetry的GenAI文档也建议默认不收集系统指令、输入消息和输出消息,认为它们是敏感且大量的数据。它建议仅在必要时明确启用,并在生产环境中,将内容存储在单独的、访问受控的存储中,并在Span中留下引用。
以下原则应在引入前作为政策固定:
- 默认不收集提示和响应正文。
- 个人信息和认证信息由SDK或Collector删除。
- 模型·用户ID等高基数的值不应随意用作Metric Label。
- 考虑对正常请求进行采样,但保留错误、高延迟和重要评估失败的策略。
- 分离Trace存储和原始内容存储的访问权限·保留期限。
- 通过单独的指标监控遥测丢失和Collector自身的故障。
总结
LLM系统的故障并非仅发生在一次模型调用中。由于搜索、路由、安全策略、工具和外部API共同生成一个答案,运营人员必须能够将整个旅程视为一个请求。
OTel是目前连接该旅程的通用语言的最安全基础选择。LGTM是当您希望使用开源工具存储和探索这些数据时,一个非常合适的典型组合。但是,不应将核心OTel的成熟度扩大解释为GenAI专用规范的完全稳定。
最现实的起点是:将OTel/OTLP定义为平台的边界,管理LLM专用属性的版本,并且默认不收集提示正文。遵守这三点,即使您更改特定的模型提供商或可观测性后端,也能构建可重用的监控基础。
发表回复